<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <author>
    <name>Bob</name>
  </author>
  <generator uri="https://hexo.io/">Hexo</generator>
  <id>https://blog.wangbowei.com/</id>
  <link href="https://blog.wangbowei.com/" rel="alternate"/>
  <link href="https://blog.wangbowei.com/atom.xml" rel="self"/>
  <rights>All rights reserved 2026, Bob</rights>
  <subtitle>路虽远行则将至，事虽难做则必成</subtitle>
  <title>Bob's Blog</title>
  <updated>2026-04-28T09:58:41.000Z</updated>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="运维" scheme="https://blog.wangbowei.com/categories/%E8%BF%90%E7%BB%B4/"/>
    <content>
      <![CDATA[<p>我们买了服务器后,最好立即修改ssh端口做好安全防护,避免被密码被暴力破解导致服务器被黑,接下来我以 Ubuntu  24 系统为例,跟着我的操作来加固服务器安全:</p><ol><li>通过 <code>last</code> 命令查看登录成功日志,确认只有自己的ip登录</li><li>通过 <code>lastb -n 30</code> 命令可以看到很多ip在不停试错的登录失败记录</li><li>修改配置文件,将 <code>#Port 22</code> 改为高位端口,不建议改为 <code>22222</code> 这种常见 ssh 高位端口,也容易被不停试错,最好是随机一点,例如我这里改为 <code>Port 20827</code></li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> vim /etc/ssh/sshd_config</span><br></pre></td></tr></table></figure><ol start="4"><li>写 ssh.socket 覆盖配置</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> <span class="built_in">mkdir</span> -p /etc/systemd/system/ssh.socket.d</span><br><span class="line"></span><br><span class="line"><span class="built_in">sudo</span> <span class="built_in">tee</span> /etc/systemd/system/ssh.socket.d/override.conf &gt; /dev/null &lt;&lt;<span class="string">&#x27;EOF&#x27;</span></span><br><span class="line">[Socket]</span><br><span class="line">ListenStream=</span><br><span class="line">ListenStream=0.0.0.0:20827</span><br><span class="line">ListenStream=[::]:20827</span><br><span class="line">EOF</span><br></pre></td></tr></table></figure><ol start="5"><li>重新加载 systemd</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> systemctl daemon-reload</span><br></pre></td></tr></table></figure><ol start="6"><li>检查 SSH 配置语法, 如果没有输出，就是正常</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> sshd -t</span><br></pre></td></tr></table></figure><ol start="7"><li>重启 ssh.socket</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> systemctl restart ssh.socket</span><br></pre></td></tr></table></figure><ol start="8"><li>重启 ssh</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> systemctl restart ssh</span><br></pre></td></tr></table></figure><ol start="9"><li>确认是否切到高位端口 20827</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> systemctl status ssh.socket --no-pager -l</span><br><span class="line"><span class="built_in">sudo</span> ss -lntp | grep ssh</span><br></pre></td></tr></table></figure><ol start="10"><li>安装 ufw 防火墙</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> apt update</span><br><span class="line"><span class="built_in">sudo</span> apt install -y ufw</span><br></pre></td></tr></table></figure><ol start="11"><li>放行需要的端口, 一定要放行刚才配的ssh端口</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> ufw allow 20827/tcp</span><br><span class="line"><span class="built_in">sudo</span> ufw allow 80/tcp</span><br><span class="line"><span class="built_in">sudo</span> ufw allow 443/tcp</span><br></pre></td></tr></table></figure><ol start="12"><li>启用防火墙, 提示确认按 y</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> ufw <span class="built_in">enable</span></span><br></pre></td></tr></table></figure><ol start="13"><li>查看防火墙状态, 此时记得新开一个 ssh 连接查看是否能连上</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> ufw status verbose</span><br></pre></td></tr></table></figure><ol start="14"><li>安装 fail2ban 防止暴力破解 ssh 密码</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> apt update</span><br><span class="line"><span class="built_in">sudo</span> apt install -y fail2ban</span><br></pre></td></tr></table></figure><ol start="15"><li>写入本地配置 (10分钟内试错3次锁 ip 一年, 可以在 ignoreip 后加空格自己的 ip 设置白名单)</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> <span class="built_in">tee</span> /etc/fail2ban/jail.local &gt; /dev/null &lt;&lt;<span class="string">&#x27;EOF&#x27;</span></span><br><span class="line">[DEFAULT]</span><br><span class="line">bantime = 1y</span><br><span class="line">findtime = 10m</span><br><span class="line">maxretry = 3</span><br><span class="line">backend = systemd</span><br><span class="line">banaction = ufw</span><br><span class="line">ignoreip = 127.0.0.1/8 ::1</span><br><span class="line"></span><br><span class="line">[sshd]</span><br><span class="line">enabled = <span class="literal">true</span></span><br><span class="line">port = 20827</span><br><span class="line">logpath = %(sshd_log)s</span><br><span class="line">EOF</span><br></pre></td></tr></table></figure><ol start="16"><li>测试语法是否有误, 启动并设置开机自启</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> fail2ban-client -t</span><br><span class="line"></span><br><span class="line"><span class="built_in">sudo</span> systemctl <span class="built_in">enable</span> fail2ban</span><br><span class="line"><span class="built_in">sudo</span> systemctl restart fail2ban</span><br></pre></td></tr></table></figure><ol start="17"><li>检测配置是否生效</li></ol><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">sudo</span> systemctl status fail2ban --no-pager -l</span><br><span class="line"><span class="built_in">sudo</span> fail2ban-client status</span><br><span class="line"><span class="built_in">sudo</span> fail2ban-client status sshd</span><br></pre></td></tr></table></figure><p>做完这些你的服务器基本不会被暴力试错破解密码了,但是你的密码信息仍可能通过社工手段被偷走,如果希望更加安全,可以通过禁用密码登录,通过密钥凭证登录等的手段来保证服务器安全</p>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/ssh-port-ufw-fail2ban/</id>
    <link href="https://blog.wangbowei.com/archives/ssh-port-ufw-fail2ban/"/>
    <published>2026-04-23T07:22:14.000Z</published>
    <summary>我们买了服务器后,最好立即修改ssh端口做好安全防护,避免被密码被暴力破解导致服务器被黑,接下来我以 Ubuntu 24 系统为例,跟着我的操作来加固服务器安全: 通过 last 命令查看登录成功日志,确认只有自己的ip登录 通过 lastb -n 30 命令可以看到很多ip在不停试错的登录失败记录</summary>
    <title>服务器更换 SSH 端口并开启 UFW + Fail2ban 防护</title>
    <updated>2026-04-28T09:58:41.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="数据库" scheme="https://blog.wangbowei.com/categories/%E6%95%B0%E6%8D%AE%E5%BA%93/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="MySQL" scheme="https://blog.wangbowei.com/tags/MySQL/"/>
    <content>
      <![CDATA[<h2 id="如何调优？"><a href="#如何调优？" class="headerlink" title="如何调优？"></a>如何调优？</h2><p>SQL调优是一个很大的概念，但是大致就是从索引优化、代码&#x2F;业务优化、架构优化几个方向上来做：</p><ul><li>比如最常说的索引优化：<ol><li>我们可以使用覆盖索引避免回表；</li><li>然后就是尽量满足最左匹配原则，避免索引失效；</li><li>还有就是索引也不宜过多，这样写入的时候维护索引的成本就高了，也占磁盘空间，mysql选择索引的时候也会选择困难</li></ol></li><li>再从从代码&#x2F;业务层面的话：<ol><li>减少sql次数，不在循环发sql，避免频繁数据库IO</li><li>可以尽量控制事务范围，用小事务避免使用大事务，不在事务中做文件&#x2F;网络IO操作</li><li>在业务允许的情况下，使用合适的隔离级别，如RR-&gt;RC，避免锁等待</li><li>在业务上做优化，比如如果需要查询未加索引的情况时，要求用户必填一个加了索引的字段，先筛选掉一部分数据在逐行查询</li></ol></li><li>最后就是架构上来说：<ol><li>最容易想到的就是加缓存中间层分担数据库压力，如redis、caffiein、guava</li><li>可以使用读写分离、分库分表（注意数据库主键与业务主键分离）+使用OLAP数据库定时归档减少OLTP数据库的数据量来分担数据库压力</li><li>还可以通过升级数据库版本、采用性能更好的连接池来优化</li></ol></li></ul><h2 id="调优大方向"><a href="#调优大方向" class="headerlink" title="调优大方向"></a>调优大方向</h2><ol><li>索引优化：联合索引、覆盖索引、隐式类型转换、控制索引数量</li><li>架构优化：读写分离、分库分表、缓存中间层</li><li>数据库升级&#x2F;版本升级：5.7-&gt;8.0优化器改进、更好的执行计划</li><li>更好的查询引擎&#x2F;混合架构：使用OLAP分析性数据库，如ClickHouse、Doris、TiDB</li><li>并发&#x2F;锁优化：避免大事务、合理使用隔离级别（RR-&gt;RC），避免锁等待</li><li>代码优化：不在事务中进行网络IO&#x2F;文件IO操作、使用短事务、减少SQL次数，避免频繁数据库IO</li><li>业务优化：在查询未用索引字段强制必填索引字段先筛选一部分</li></ol><h2 id="索引优化技巧"><a href="#索引优化技巧" class="headerlink" title="索引优化技巧"></a>索引优化技巧</h2><ol><li>最左前缀原则：联合索引必须从最左边的字段开始使用。</li><li>索引覆盖：查询的字段都包含在索引里，避免回表，提高性能。</li><li>索引下推：MySQL 5.6+ 提供优化，先在存储引擎层用索引过滤条件，减少回表次数。</li><li>控制索引数量：降低写入维护索引成本，避免查询优化器难以选择</li><li>索引选择性：读多写少，越散列的字段越适合加索引</li></ol><h2 id="你做过哪些具体的优化呢？"><a href="#你做过哪些具体的优化呢？" class="headerlink" title="你做过哪些具体的优化呢？"></a>你做过哪些具体的优化呢？</h2><p>像架构的优化太大了，我们最常做的就是对索引和业务的优化</p><ol><li>没使用联合索引导致回表的查询慢<ul><li>比如我记得之前因为刚开始真正的就是到企业工作，之前更多是做的一些比赛和练手的项目，所以对于企业这种模式还是没经验，当时我记得是有一个新的查询功能嘛，然后我当时就是按平时我做练习的一些习惯，在mysql里把数据库语句写好了查出来数据，然后改成xml放到mybatis里，但是其实这种存在的问题就是可能我需要的这些字段没有建立联合索引，所以会导致这个查询效率不高，当时这个接口也确实查询比较慢，就定位到这里，其实当时xml文件上面有之前同时写好的建立了联合索引的<code>&lt;sql&gt;</code>标签，只是当时我没有使用这个标签去查，然后后面我就改成了这个联合索引嘛，然后通过在这个业务层把需要的字段组装成vo再返回给前端嘛，提高了这个查询到效率。</li></ul></li><li>用户查询无索引字段的业务优化<ul><li>还有就是用户反馈某个查询特别慢，反馈到我们这里，然后要求我们改，当时我们去看了，那个需求就是要查询一个无索引的字段，这个没有索引慢是正常的，当时我们评审了这个是一个就是修改较为频繁的字段，建立索引不合适，会导致写入很慢，但是这个字段又有查询的需求，还要快，当时我们跟产品扯了好久，最后我们就是采取折中的方案，就是你要查询这个没有索引的字段，那你必须填一个建立了索引的字段，这样我们通过有索引的字段先筛掉一部分数据，再对剩下的数据全表扫，可以提升一部分的查询效率</li></ul></li></ol>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/mysql-optimization/</id>
    <link href="https://blog.wangbowei.com/archives/mysql-optimization/"/>
    <published>2025-11-09T15:46:00.000Z</published>
    <summary>如何调优？ SQL调优是一个很大的概念，但是大致就是从索引优化、代码/业务优化、架构优化几个方向上来做： 比如最常说的索引优化： 我们可以使用覆盖索引避免回表； 然后就是尽量满足最左匹配原则，避免索引失效； 还有就是索引也不宜过多，这样写入的时候维护索引的成本就高了，也占磁盘空间，mysql选择索引</summary>
    <title>MySQL 的优化</title>
    <updated>2026-04-09T15:57:36.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="Spring" scheme="https://blog.wangbowei.com/categories/Spring/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="MySQL" scheme="https://blog.wangbowei.com/tags/MySQL/"/>
    <category term="SpringBoot" scheme="https://blog.wangbowei.com/tags/SpringBoot/"/>
    <content>
      <![CDATA[<h2 id="事务的特性和属性"><a href="#事务的特性和属性" class="headerlink" title="事务的特性和属性"></a>事务的特性和属性</h2><p>特性：原子性、一致性、隔离性、持久性</p><p>属性：隔离性、传播性、回滚规则、是否只读、超时时间</p><h2 id="事务传播行为有哪几种？"><a href="#事务传播行为有哪几种？" class="headerlink" title="事务传播行为有哪几种？"></a>事务传播行为有哪几种？</h2><p>协同派：</p><ol><li><strong>REQUIRED</strong>：有就加入，没有就新建（默认）</li><li><strong>SUPPORTS</strong>：有就加入，没有就算了</li><li><strong>NESTED</strong>：有就新建子事务（子事务失败父事务不受影响，父事务失败会带动子事务回滚），没有就新建事务</li></ol><p>独立派：</p><ol><li><strong>REQUIRES_NEW</strong>：直接单独开事务，有事务就挂起（脱离当前事务影响）</li><li><strong>NOT_SUPPORTED</strong>：以非事务运行，有事务就挂起（脱离当前事务影响）</li></ol><p>强硬派：</p><ol><li><strong>MANDATORY</strong>：有就加入，没有就抛异常</li><li><strong>NEVER</strong>：有事务就抛异常，没事务就以非事务运行</li></ol><h2 id="事务注解失效的场景？"><a href="#事务注解失效的场景？" class="headerlink" title="事务注解失效的场景？"></a>事务注解失效的场景？</h2><p>底层使用<strong>AOP</strong>实现，而AOP又是基于<strong>动态实现</strong>实现，通过<strong>ThreadLocal</strong>存储上下文，失效场景就与其原理有关</p><ol><li>最简单的就是<strong>异常吞没</strong>，使用了try&#x2F;catch代码捕获异常后未重新抛出，导致事务注解无法感知</li><li>设置的<strong>异常范围太小</strong>，默认设置是RuntimeException导致捕获不到Exception异常</li><li><strong>类的自调用</strong>，同一个类中方法调用，因此事务是基于动态代理实现的，同类的方法调用不会走代理方法</li><li><strong>修饰非 public 方法</strong>，Spring 事务管理器判断非公共方法则不应用事务。</li><li><strong>传播机制配置错误</strong>，例如使用了REQUIRES_NEW（挂起脱离当前事务）传播行为</li><li><strong>多线程</strong>环境，每个线程有自己的ThreadLocal上下文</li><li>使用的<strong>数据库不支持事务</strong>，如使用MySQL的MyISAM引擎</li><li><strong>修饰final 和 static 方法</strong>，aop 默认是 cglib 代理，无法对 final 方法子类化。static 是静态方法，属于类，不属于实例对象，无法被代理！</li></ol>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/spring-transaction/</id>
    <link href="https://blog.wangbowei.com/archives/spring-transaction/"/>
    <published>2025-11-08T12:17:00.000Z</published>
    <summary>事务的特性和属性 特性：原子性、一致性、隔离性、持久性 属性：隔离性、传播性、回滚规则、是否只读、超时时间 事务传播行为有哪几种？ 协同派： REQUIRED：有就加入，没有就新建（默认） SUPPORTS：有就加入，没有就算了 NESTED：有就新建子事务（子事务失败父事务不受影响，父事务失败会带</summary>
    <title>Spring 的事务</title>
    <updated>2026-04-09T15:57:58.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="中间件" scheme="https://blog.wangbowei.com/categories/%E4%B8%AD%E9%97%B4%E4%BB%B6/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="SpringCloud" scheme="https://blog.wangbowei.com/tags/SpringCloud/"/>
    <content>
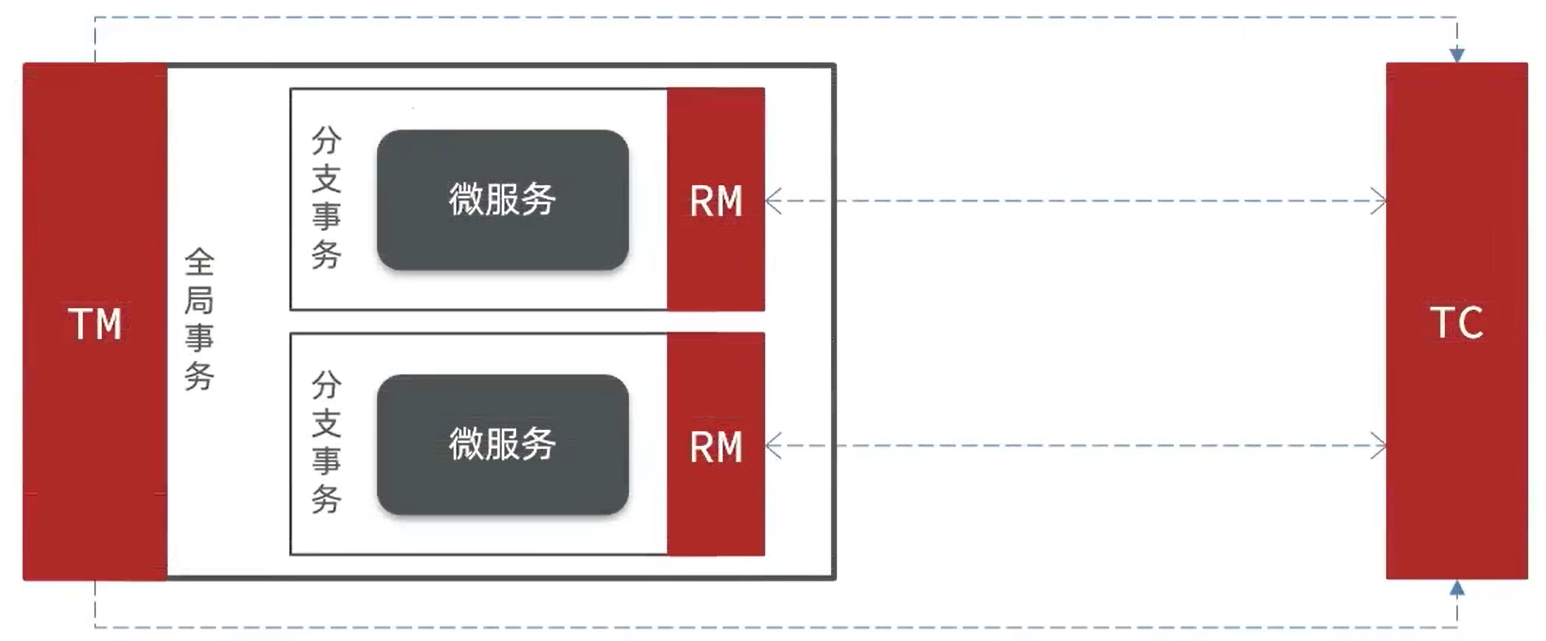
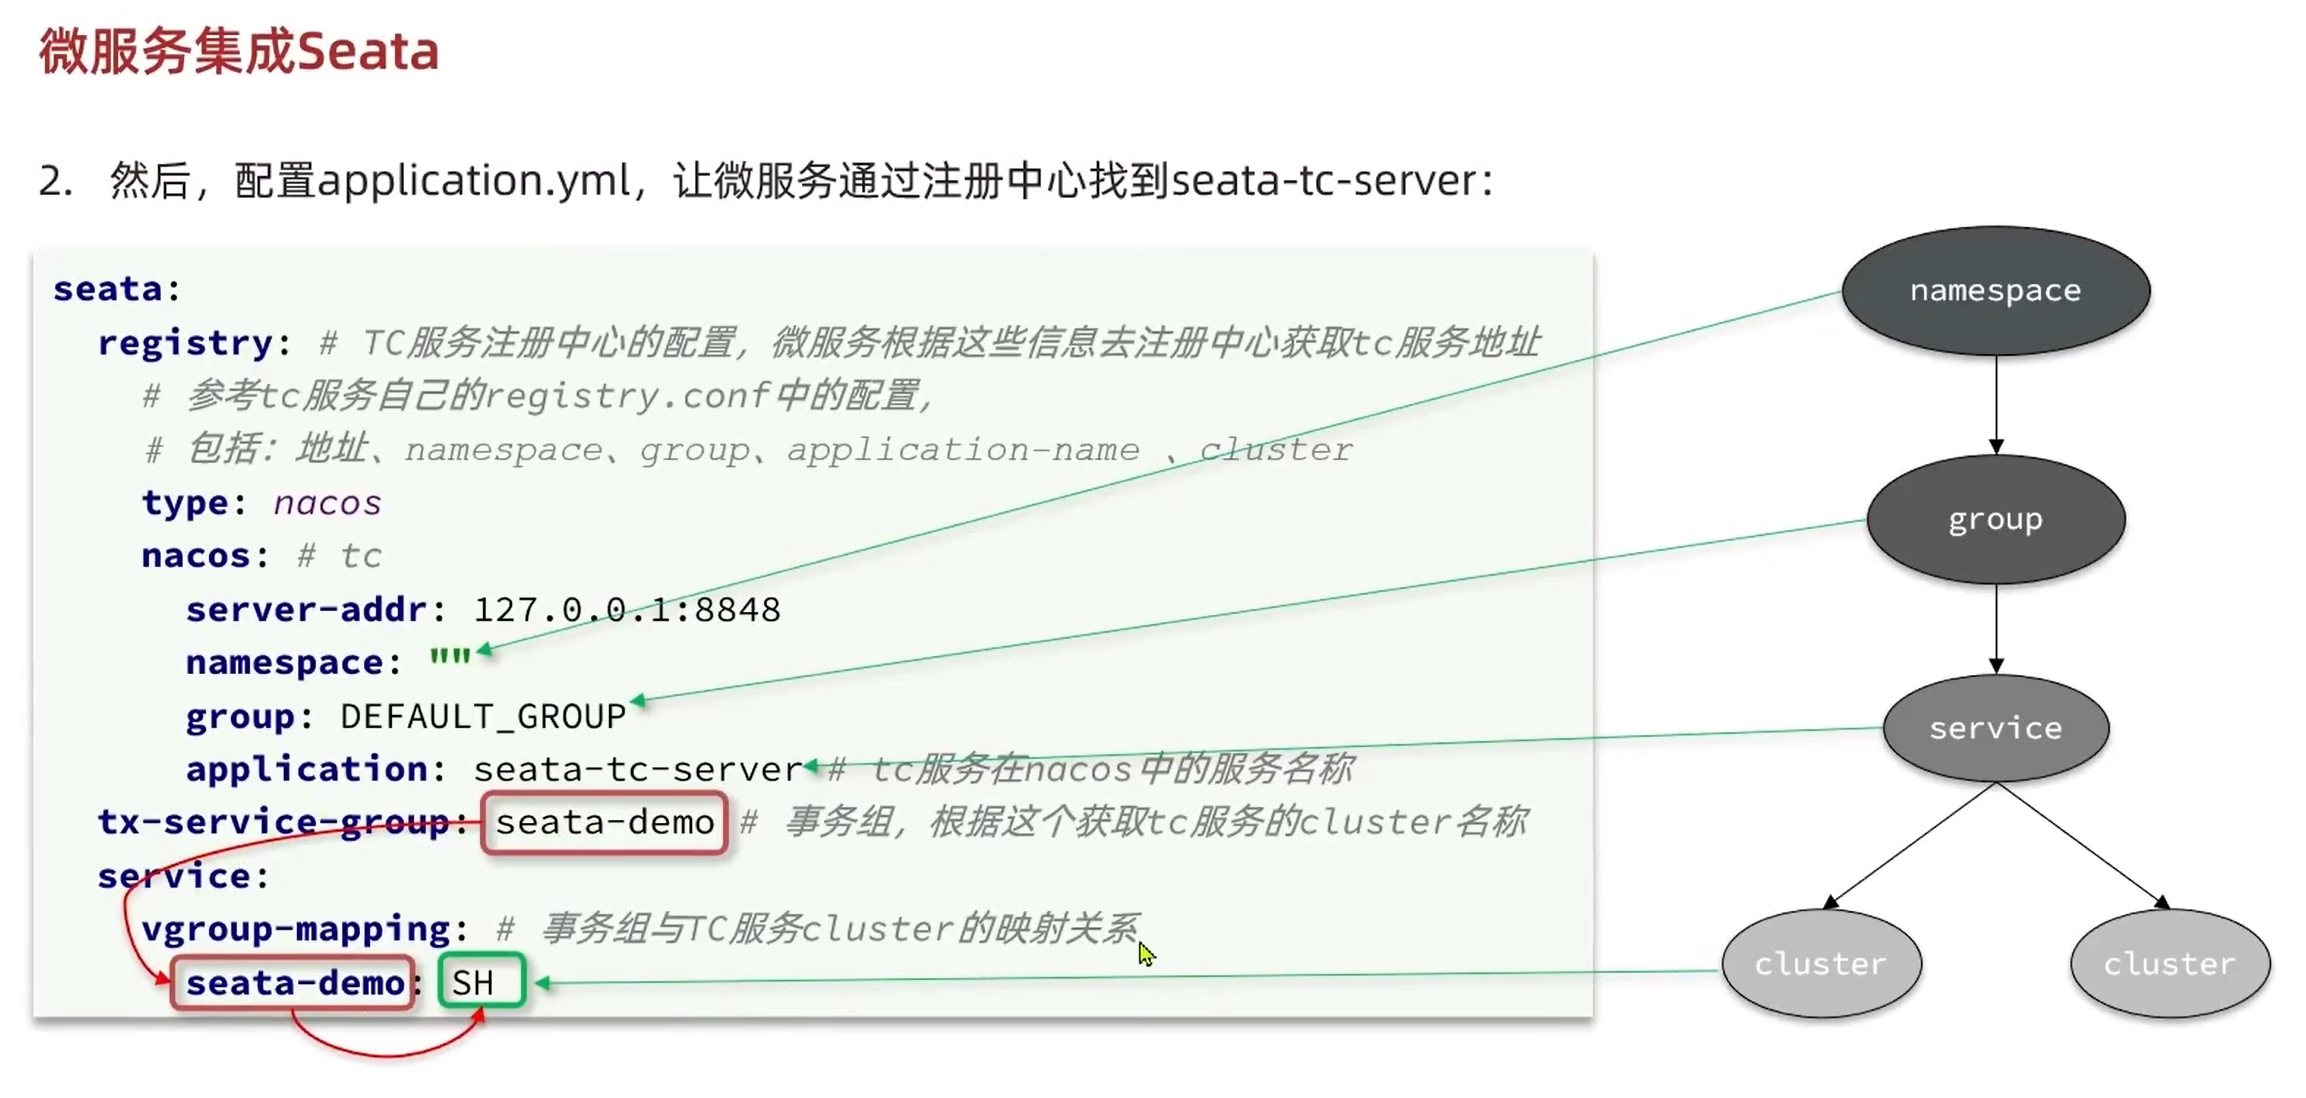
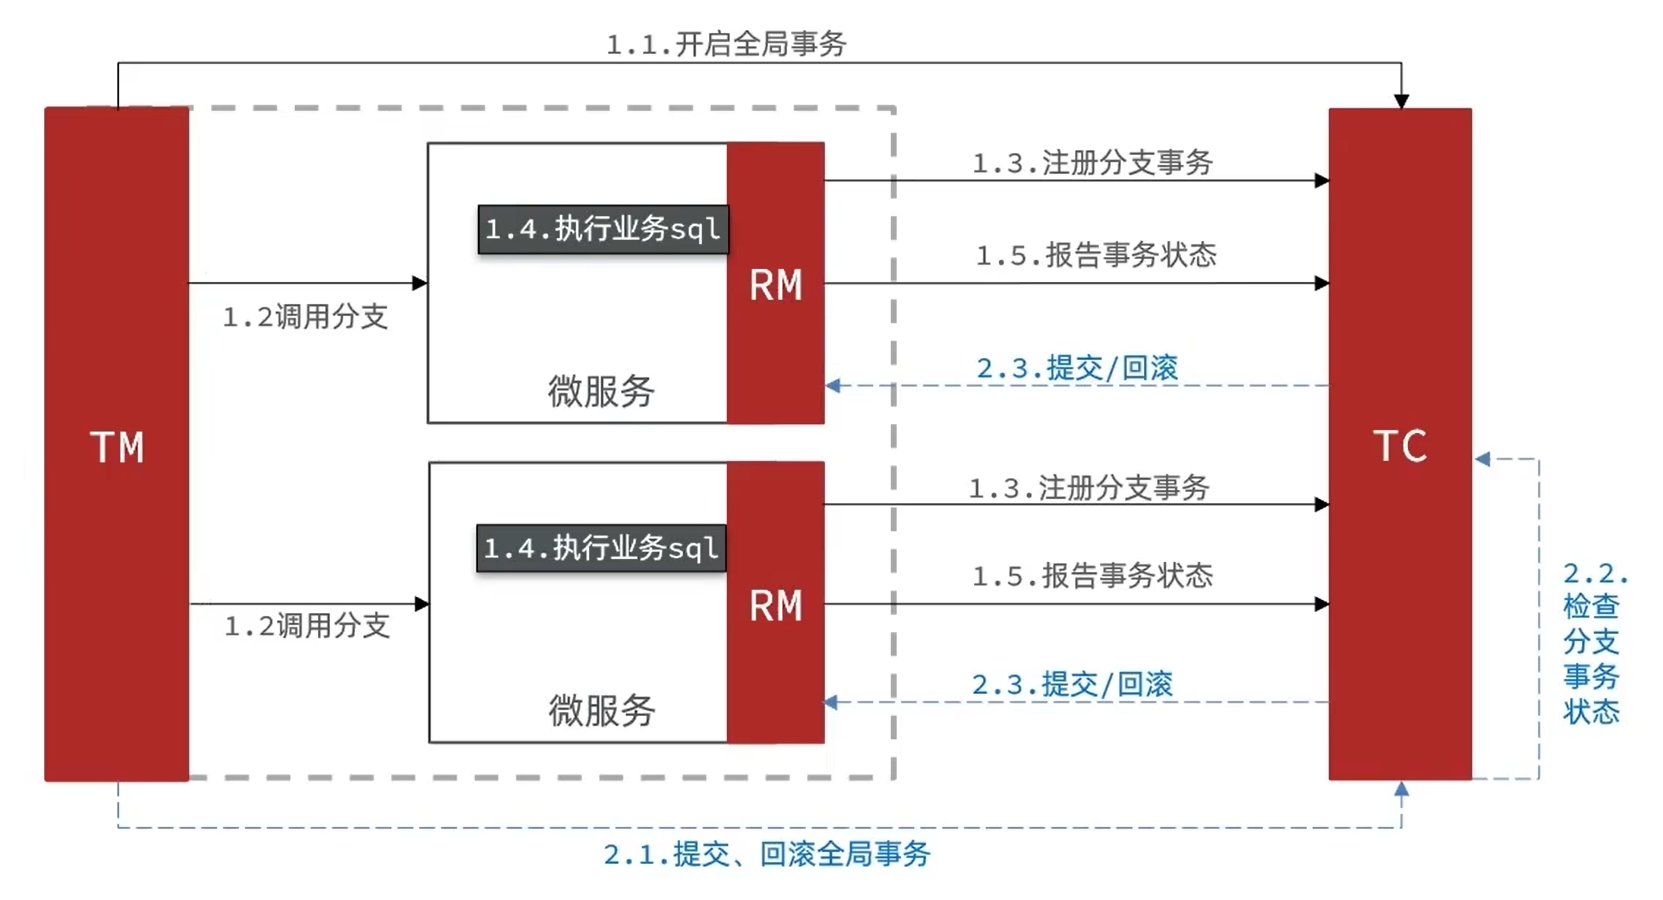
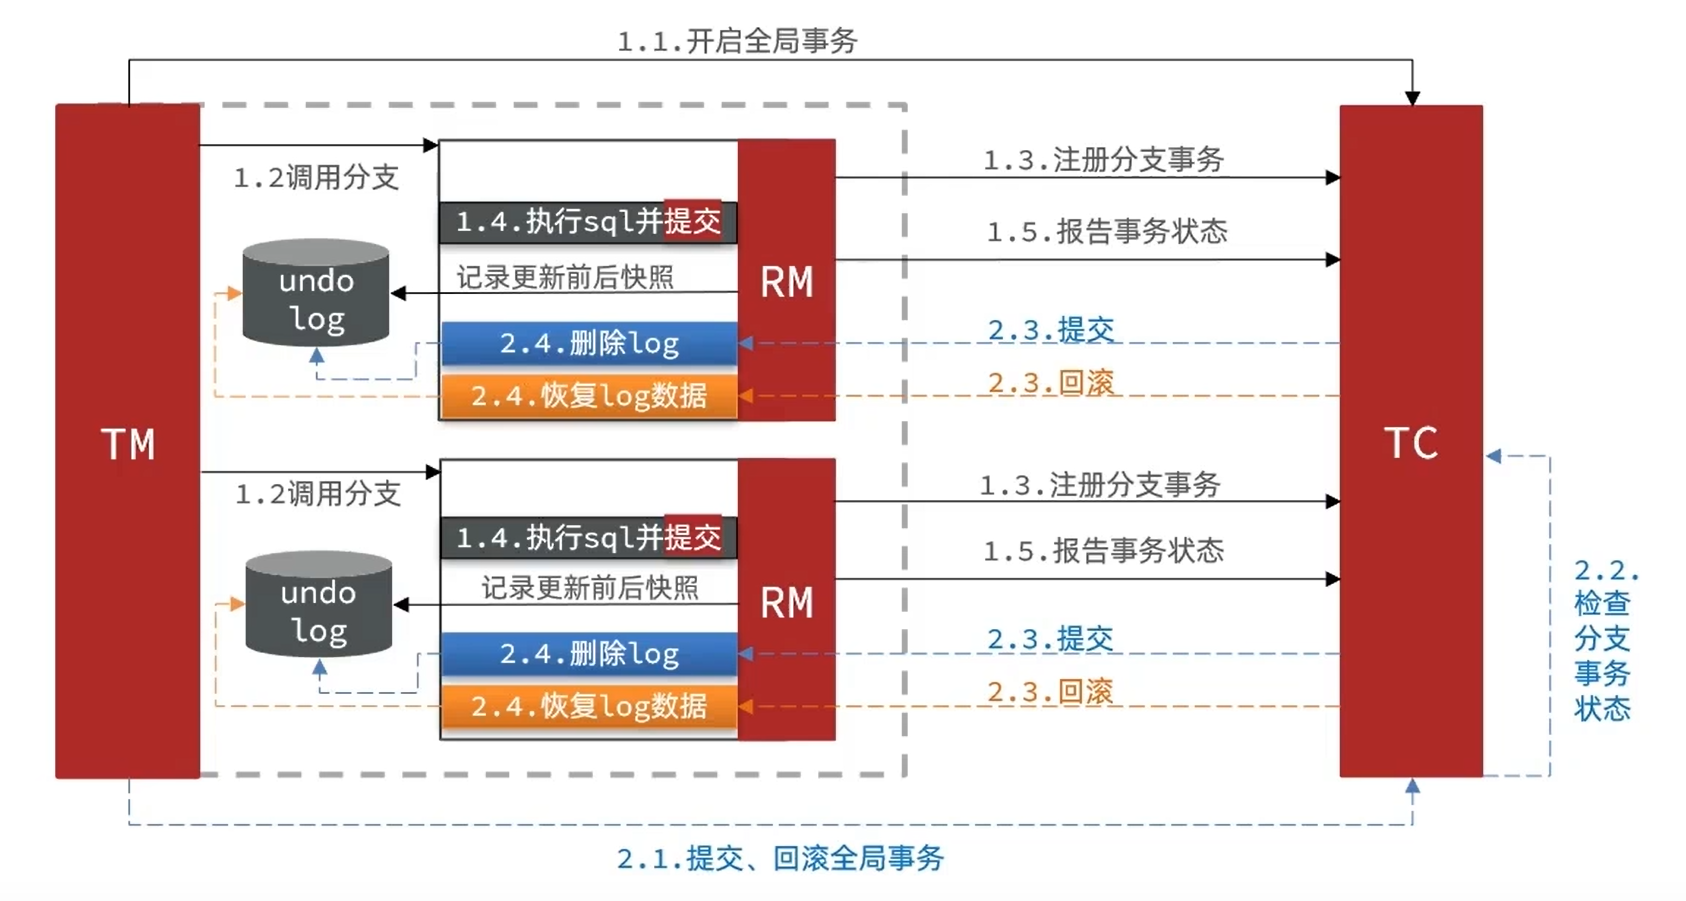
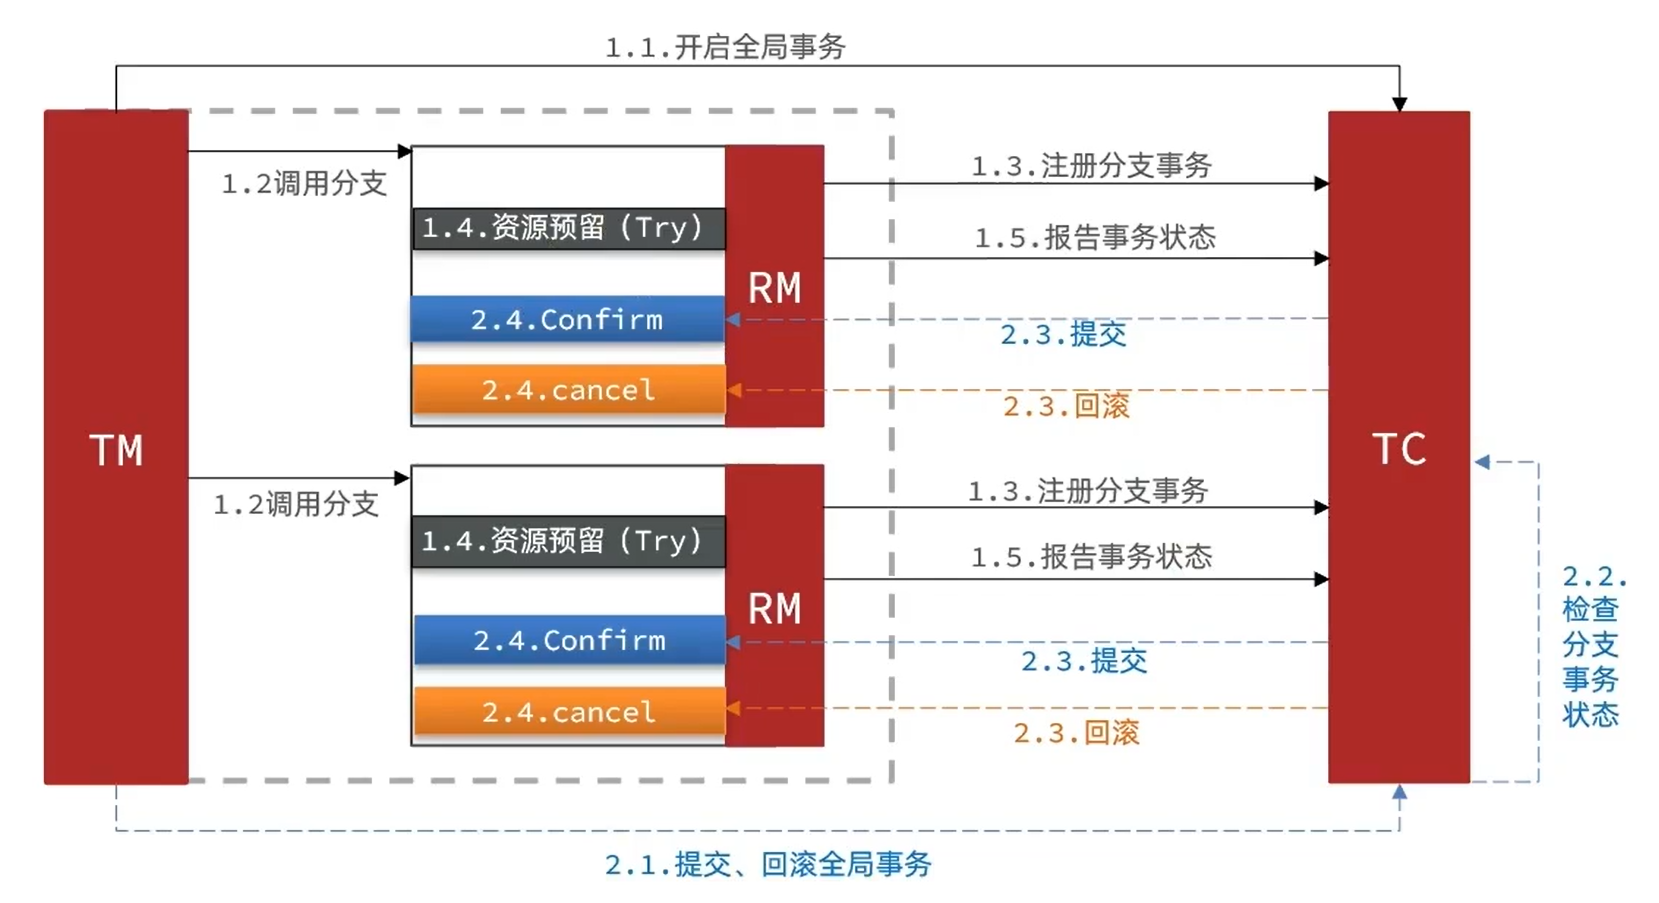
      <![CDATA[<h2 id="什么是CAP定理？"><a href="#什么是CAP定理？" class="headerlink" title="什么是CAP定理？"></a>什么是CAP定理？</h2><ul><li><strong>C</strong>onsistency <strong>一致性</strong>：所有节点在同一时间看到的数据必须一致。</li><li><strong>A</strong>vailability <strong>可用性</strong>：每个请求都能得到响应，不会出现长时间阻塞或错误。</li><li><strong>P</strong>artition tolerance <strong>分区容错性</strong>：当网络通信出现故障时（如网络丢包、节点之间无法连通），系统仍能继续运作。</li></ul><p>在分布式系统中，网络分区无法避免，所以 <strong>P 必须保证</strong>。那么我们主要在AP&#x2F;CP模式中做取舍。</p><p><strong>CP</strong>：保证一致性 + 分区容错，牺牲可用性，适用于需要保证强一致允许响应慢或者直接拒绝请求</p><p><strong>AP</strong>：保证可用性 + 分区容错，牺牲一致性，保证高可用，响应快但是允许短时数据不一致（我们的项目使用AP）</p><h2 id="什么是BASE理论？"><a href="#什么是BASE理论？" class="headerlink" title="什么是BASE理论？"></a>什么是BASE理论？</h2><ul><li><p><strong>BA</strong>（Basically Available-基本可用）：系统在出现故障或网络分区时，允许损失部分可用性，但必须保证<strong>核心功能可用</strong></p></li><li><p><strong>S</strong>（Soft state-软状态）：一定时间内，系统中的数据可以是<strong>中间状态</strong>、<strong>未同步状态</strong>，允许临时不一致状态</p></li><li><p><strong>E</strong>（Eventually consistent-最终一致性）：虽然系统允许短时间不一致，但在乱状态结束后，<strong>最终达到数据一致</strong></p></li></ul><p>在实际项目中我们也是遵循BASE理论，基本采用的AP模式保证系统高可用，允许短时的数据不一致。</p><h2 id="Seata中有哪些重要角色？"><a href="#Seata中有哪些重要角色？" class="headerlink" title="Seata中有哪些重要角色？"></a>Seata中有哪些重要角色？</h2><ol><li><strong>TC（Transaction Coordinator）事务协调者</strong>：负责整个全局和分支事务事务的状态，协调全局事务的提交和回滚</li><li><strong>TM（Transaction Manager）事务管理者</strong>：定义全局事务范围，开始全局事务、提交&#x2F;回滚全局事务</li><li><strong>RM（Resource Manager）资源管理者</strong>：管理分支事务处理的资源，与TC交谈，以注册分支事务和报告分支事务的状态，并驱动分支事务的提交&#x2F;回滚。</li></ol><p><img src="/images/upload/image-20251117153956151.png" alt="image-20251117153956151.png"></p><h2 id="Seata有几种模式？"><a href="#Seata有几种模式？" class="headerlink" title="Seata有几种模式？"></a>Seata有几种模式？</h2><ul><li><p>XA模式：强一致性分阶段事务模式，牺牲了一定的可用性，无业务侵入</p></li><li><p><strong>AT模式</strong>：最终一致的分阶段事务模式，无业务侵入，也是Seata的默认模式</p></li><li><p><strong>TCC模式</strong>：最终一致的分阶段事务模式，有业务侵入</p></li><li><p>SAGA模式：长事务模式，有业务侵入</p></li></ul><h2 id="Nacos服务名称包括哪几部分？"><a href="#Nacos服务名称包括哪几部分？" class="headerlink" title="Nacos服务名称包括哪几部分？"></a>Nacos服务名称包括哪几部分？</h2><p>namespace（命名空间）+group（组名称）+serviceName（服务名称）+cluster（集群名称）</p><h2 id="Seata客户端获取TC的cluster名称的方式？"><a href="#Seata客户端获取TC的cluster名称的方式？" class="headerlink" title="Seata客户端获取TC的cluster名称的方式？"></a>Seata客户端获取TC的cluster名称的方式？</h2><p>以tx-group-service的值为key到vgroupMapping中查找</p><p><img src="/images/upload/image-20251117173721874.png" alt="image-20251117173721874.png"></p><h2 id="什么是2PC、3PC？"><a href="#什么是2PC、3PC？" class="headerlink" title="什么是2PC、3PC？"></a>什么是2PC、3PC？</h2><ul><li>2PC：两阶段提交<ol><li>准备阶段：执行SQL语句但是不提交</li><li>提交&#x2F;回滚阶段：等到所有节点都返回YES就commit，否则rollback<ul><li>优点：保证强一致性</li><li>缺点：<ol><li>同步阻塞，性能差</li><li>单点故障会一直等待</li><li>发出commit命令时可能有参与者没收到导致数据不一致</li></ol></li></ul></li></ol></li><li>3PC：三阶段提交<ol><li>询问提交阶段：询问是否可以提交</li><li>预提交阶段：如果参与者都回复YES，则进入预提交阶段，锁定资源</li><li>提交阶段：通知参与者提交，如果超时由参与者自己决定提交或回滚<ul><li>改进点：超时参与者可以自己决定提交&#x2F;回滚，避免单点故障等待问题</li><li>仍存在发出commit命令时可能有参与者没收到导致数据不一致的问题</li></ul></li></ol></li></ul><h2 id="Seata的XA模式是怎么样的？"><a href="#Seata的XA模式是怎么样的？" class="headerlink" title="Seata的XA模式是怎么样的？"></a>Seata的XA模式是怎么样的？</h2><p>XA模式<strong>基于2PC协议，具有强一致性，但是性能差，依赖数据库支持</strong>，适用于银行金融等需要保证强一致的场景</p><p><img src="/images/upload/image-20251117174205912.png" alt="image-20251117174205912.png"></p><h2 id="Seata的AT模式是怎么样的？"><a href="#Seata的AT模式是怎么样的？" class="headerlink" title="Seata的AT模式是怎么样的？"></a>Seata的AT模式是怎么样的？</h2><p>AT模式第一阶段<strong>直接提交</strong>，并记录数据快照<strong>写入undolog</strong>，如果参与者都成功，则提交事务，异步删除undolog；如果有失败，则通过数据快照回复原始数据，<strong>性能更好，保证了最终一致性，但是存在脏写的隔离性问题</strong>，项目中常用AT模式</p><p><img src="/images/upload/image-20251117182538912.png" alt="image-20251117182538912.png"></p><h2 id="AT模式存在什么问题？如何解决的？"><a href="#AT模式存在什么问题？如何解决的？" class="headerlink" title="AT模式存在什么问题？如何解决的？"></a>AT模式存在什么问题？如何解决的？</h2><p>AT模式存在的最大问题就是<strong>脏写</strong>的问题，一阶段直接提交后数据可能被其他事务修改，而二阶段回滚后可能造成数据不一致；</p><p>Seata通过<strong>全局锁</strong>解决了脏写的问题，Seata 自己维护了一个逻辑全局锁，Seata 会向 TC 申请全局锁，如果全局锁冲突则必须等待&#x2F;失败重试。</p><h2 id="加了全局锁性能不就低了，那和XA模式有区别吗？"><a href="#加了全局锁性能不就低了，那和XA模式有区别吗？" class="headerlink" title="加了全局锁性能不就低了，那和XA模式有区别吗？"></a>加了全局锁性能不就低了，那和XA模式有区别吗？</h2><p>有区别！在锁粒度上有区别，AT性能更高。</p><p>XA模式的锁是数据库的锁，锁定了整行的数据；</p><p>而AT模式是Seata自己维护的逻辑锁，只锁定了字段，修改其他字段不影响。</p><h2 id="如果其他事务不受Seata管理怎么办呢？"><a href="#如果其他事务不受Seata管理怎么办呢？" class="headerlink" title="如果其他事务不受Seata管理怎么办呢？"></a>如果其他事务不受Seata管理怎么办呢？</h2><p>其实Seata不止记录了更新前的数据快照，也<strong>记录更新后的数据</strong>，回滚时采用一种类似<strong>CAS</strong>的方式比较数据有没有被修改，如果被修改了就发出异常，这时候就可以人工介入解决。</p><h2 id="如果Undo-Log写失败了怎么办？"><a href="#如果Undo-Log写失败了怎么办？" class="headerlink" title="如果Undo Log写失败了怎么办？"></a>如果Undo Log写失败了怎么办？</h2><p>Undo log 写入和业务 SQL 在同一个<strong>本地事务</strong>中执行，<strong>只要业务 SQL 成功，Undo log 一定存在且完整</strong>。</p><h2 id="Seata的TCC模式是怎么样的？"><a href="#Seata的TCC模式是怎么样的？" class="headerlink" title="Seata的TCC模式是怎么样的？"></a>Seata的TCC模式是怎么样的？</h2><ol><li><p><strong>T</strong>ry（预留资源）：资源的检测和预留，如锁定库存、冻结余额</p></li><li><p><strong>C</strong>onfirm（确认执行）：完成资源操作业务；要求Try成功Confirm一定要能成功</p></li><li><p><strong>C</strong>ancel（取消回滚）：预留资源释放，可以理解为Try的反向操作</p></li></ol><ul><li>优点：<ol><li>性能好：一阶段直接提交，相较于AT也无需生成快照和全局锁，性能最好</li><li>不依赖数据库事务，依赖手动编码的补偿，可用于不支持事务的数据库</li></ol></li><li>缺点：<ol><li>有代码侵入，需要编写三份逻辑</li><li>无法保证强一致，只能保证最终一致性，存在软状态</li><li>需要考虑Confirm和Cancel的失败情况，需要做好幂等处理</li></ol></li></ul><p><img src="/images/upload/image-20251117192030518.png" alt="image-20251117192030518.png"></p><h2 id="你是如何在代码中实现TCC的？"><a href="#你是如何在代码中实现TCC的？" class="headerlink" title="你是如何在代码中实现TCC的？"></a>你是如何在代码中实现TCC的？</h2><ol><li>首先我们要接口定义三个方法代表 Try&#x2F;Confirm&#x2F;Cancel 三步；</li><li>然后加上<code>@LocalTCC</code>和<code>@TwoPhaseBusinessAction</code>注解；</li><li><code>@TwoPhaseBusinessAction</code>注解传入commit &#x2F; rollback两个方法名，Try 自己就是被注解的方法；</li><li>在Service中实现这个接口；</li><li>然后在业务接口加上<code>@GlobalTransactional</code>，就实现了TCC。</li></ol><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@LocalTCC</span></span><br><span class="line"><span class="keyword">public</span> <span class="keyword">interface</span> <span class="title class_">AccountTccAction</span> &#123;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@TwoPhaseBusinessAction(name = &quot;accountTccAction&quot;, </span></span><br><span class="line"><span class="meta">                            commitMethod = &quot;commit&quot;, </span></span><br><span class="line"><span class="meta">                            rollbackMethod = &quot;rollback&quot;)</span></span><br><span class="line">    <span class="type">boolean</span> <span class="title function_">prepare</span><span class="params">(<span class="meta">@BusinessActionContextParameter(paramName = &quot;userId&quot;)</span> Long userId,</span></span><br><span class="line"><span class="params">                    <span class="meta">@BusinessActionContextParameter(paramName = &quot;amount&quot;)</span> BigDecimal amount)</span>;</span><br><span class="line"></span><br><span class="line">    <span class="type">boolean</span> <span class="title function_">commit</span><span class="params">(BusinessActionContext context)</span>;</span><br><span class="line"></span><br><span class="line">    <span class="type">boolean</span> <span class="title function_">rollback</span><span class="params">(BusinessActionContext context)</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h2 id="TCC存在什么问题？如何解决？"><a href="#TCC存在什么问题？如何解决？" class="headerlink" title="TCC存在什么问题？如何解决？"></a>TCC存在什么问题？如何解决？</h2><p>问题：</p><ol><li><strong>幂等性</strong>：Confirm和Cancel失败重试，保证不重复执行</li><li><strong>空回滚</strong>：当某分支事务的try阶段阻塞时，可能导致全局事务超时而触发二阶段的cancel操作。在<strong>未执行try操作时先执行了cancel操作</strong>，这时cancel不能做回滚，就是空回滚。</li><li><strong>业务悬挂</strong>：对于<strong>已经空回滚</strong>的业务，如果以后<strong>继续执行try</strong>，就永远不可能confirm或cancel，这就是业务悬挂。</li></ol><p>解决方案：</p><ol><li><strong>幂等回滚状态判断</strong>：在在执行操作前需要判断状态是不是已经是当前操作过的状态了，如果已经是说明已经处理过一次了，就直接返回。</li><li><strong>空回滚冻结记录判断</strong>：通常在代码中，我们会在回滚前通过xid查询判断有没有冻结记录，有才执行回滚；如果没有，说明try还没做，我们就会新增一条空回滚的冻结记录，状态为回滚，但不真正回滚。</li><li><strong>悬挂冻结记录判断</strong>：判断是否已经有过冻结记录，如果为空才执行try；如果不为空，说明Cancel执行过了，直接return拒绝。</li></ol><h2 id="Seata的Saga模式是怎么样的？"><a href="#Seata的Saga模式是怎么样的？" class="headerlink" title="Seata的Saga模式是怎么样的？"></a>Seata的Saga模式是怎么样的？</h2><ol><li><p>一阶段：直接提交本地事务</p></li><li><p>二阶段：成功则什么都不做；失败则通过编写补偿业务来回滚</p></li></ol><ul><li><p>优点：</p><ol><li><p>事务参与者可以基于事件驱动实现异步调用，吞吐高</p></li><li><p>一阶段直接提交事务，无锁，性能好</p></li><li><p>不用编写TCC中的三个阶段，实现简单</p></li></ol></li><li><p>缺点：</p><ol><li><p>软状态持续时间不确定，时效性差</p></li><li><p>没有锁，没有事务隔离，会有脏写</p></li></ol></li></ul>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/seata-distributed-transaction/</id>
    <link href="https://blog.wangbowei.com/archives/seata-distributed-transaction/"/>
    <published>2025-10-27T14:33:00.000Z</published>
    <summary>什么是CAP定理？ Consistency 一致性：所有节点在同一时间看到的数据必须一致。 Availability 可用性：每个请求都能得到响应，不会出现长时间阻塞或错误。 Partition tolerance 分区容错性：当网络通信出现故障时（如网络丢包、节点之间无法连通），系统仍能继续运作。</summary>
    <title>Seata分布式事务 八股文面试题</title>
    <updated>2026-04-09T14:32:41.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="中间件" scheme="https://blog.wangbowei.com/categories/%E4%B8%AD%E9%97%B4%E4%BB%B6/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="RocketMQ" scheme="https://blog.wangbowei.com/tags/RocketMQ/"/>
    <content>
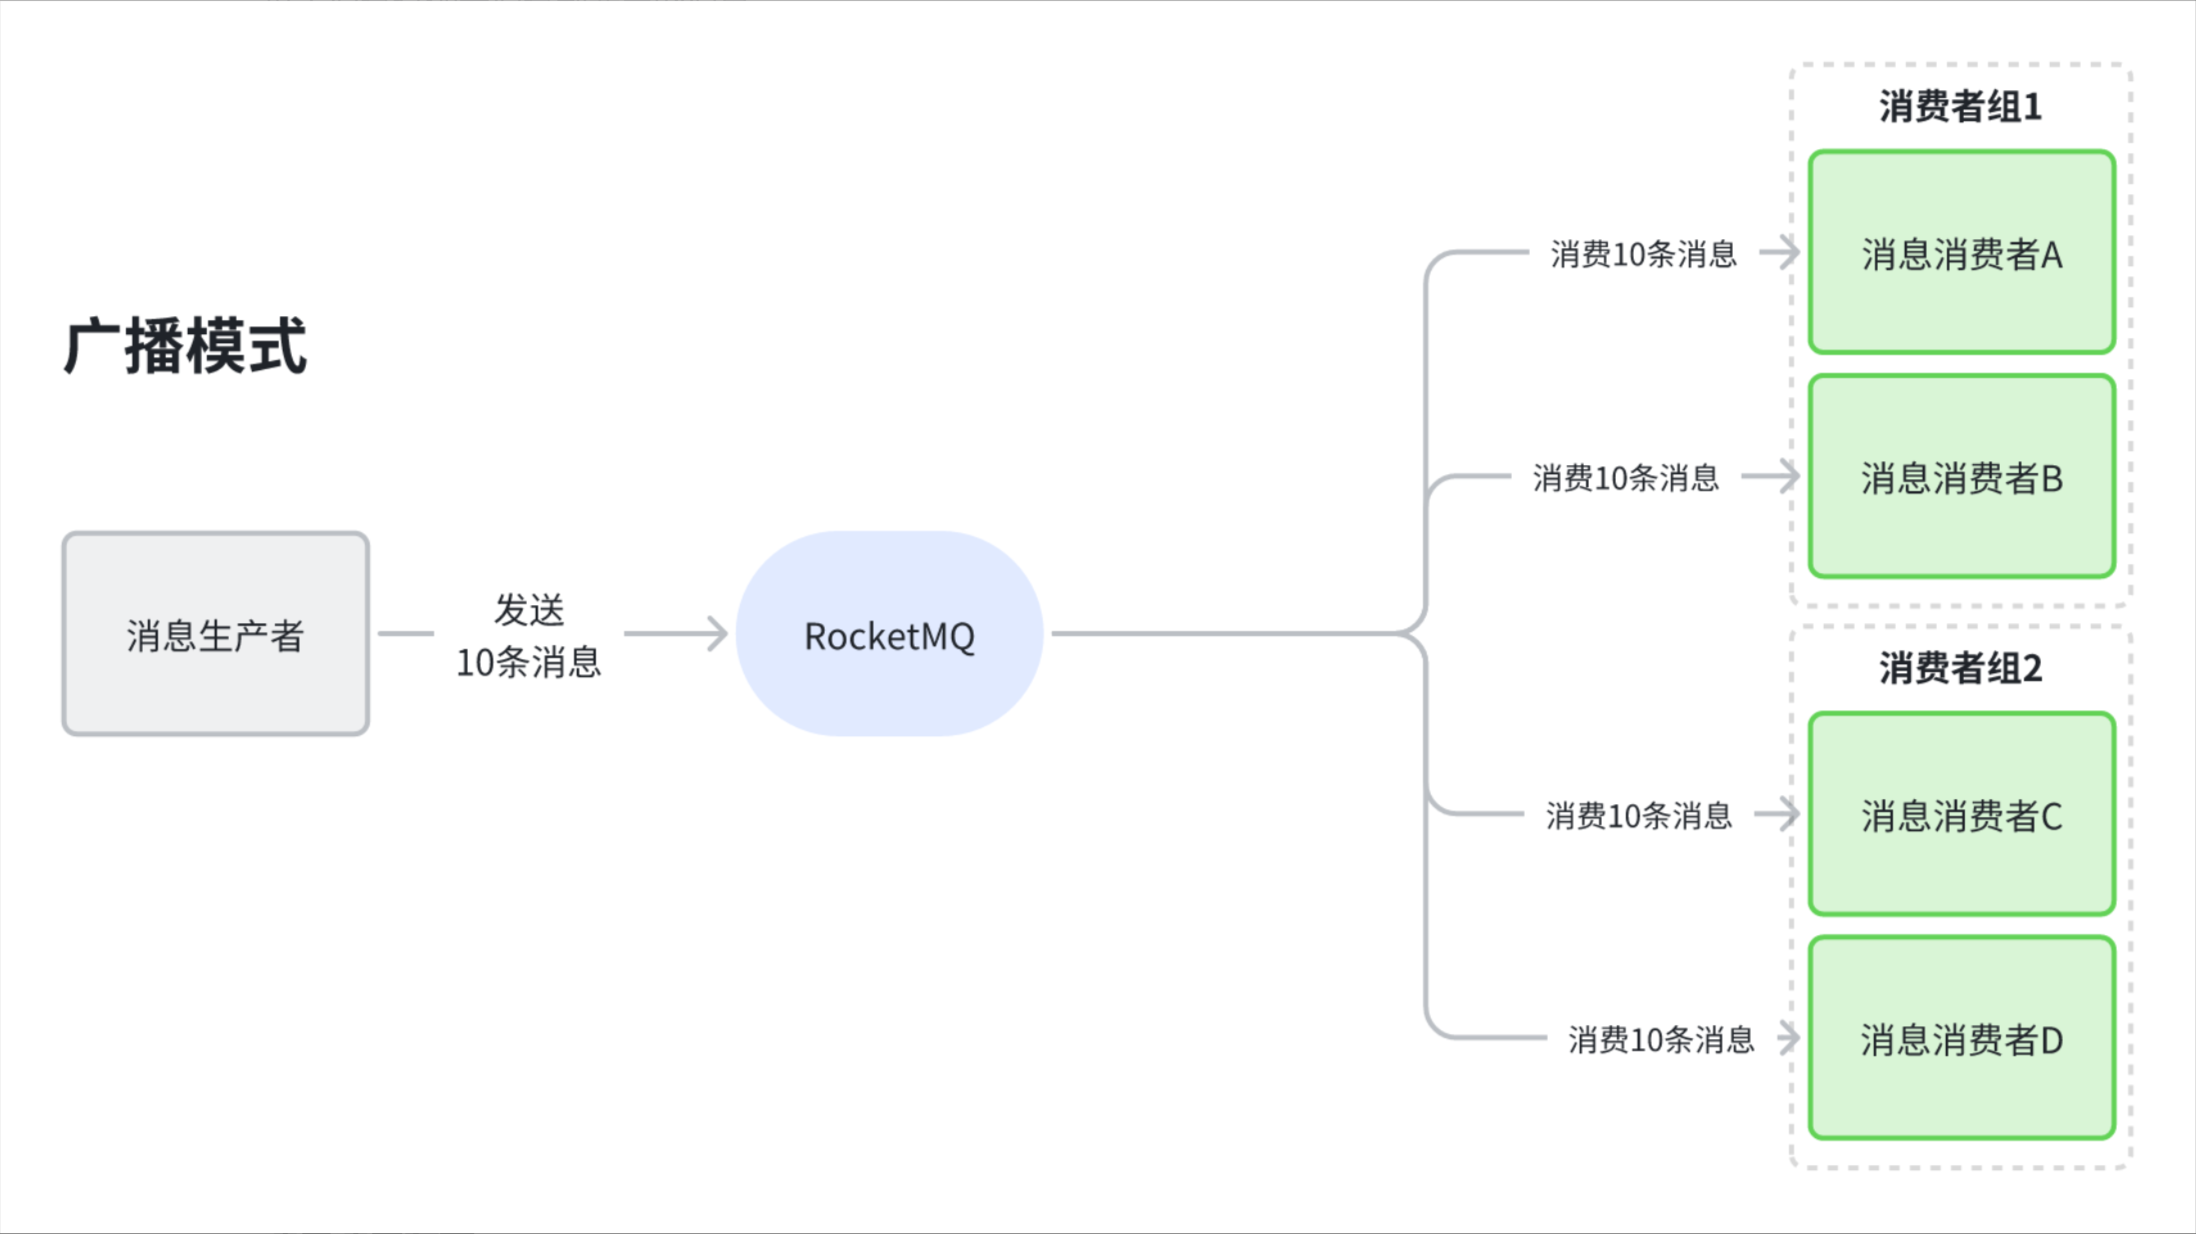
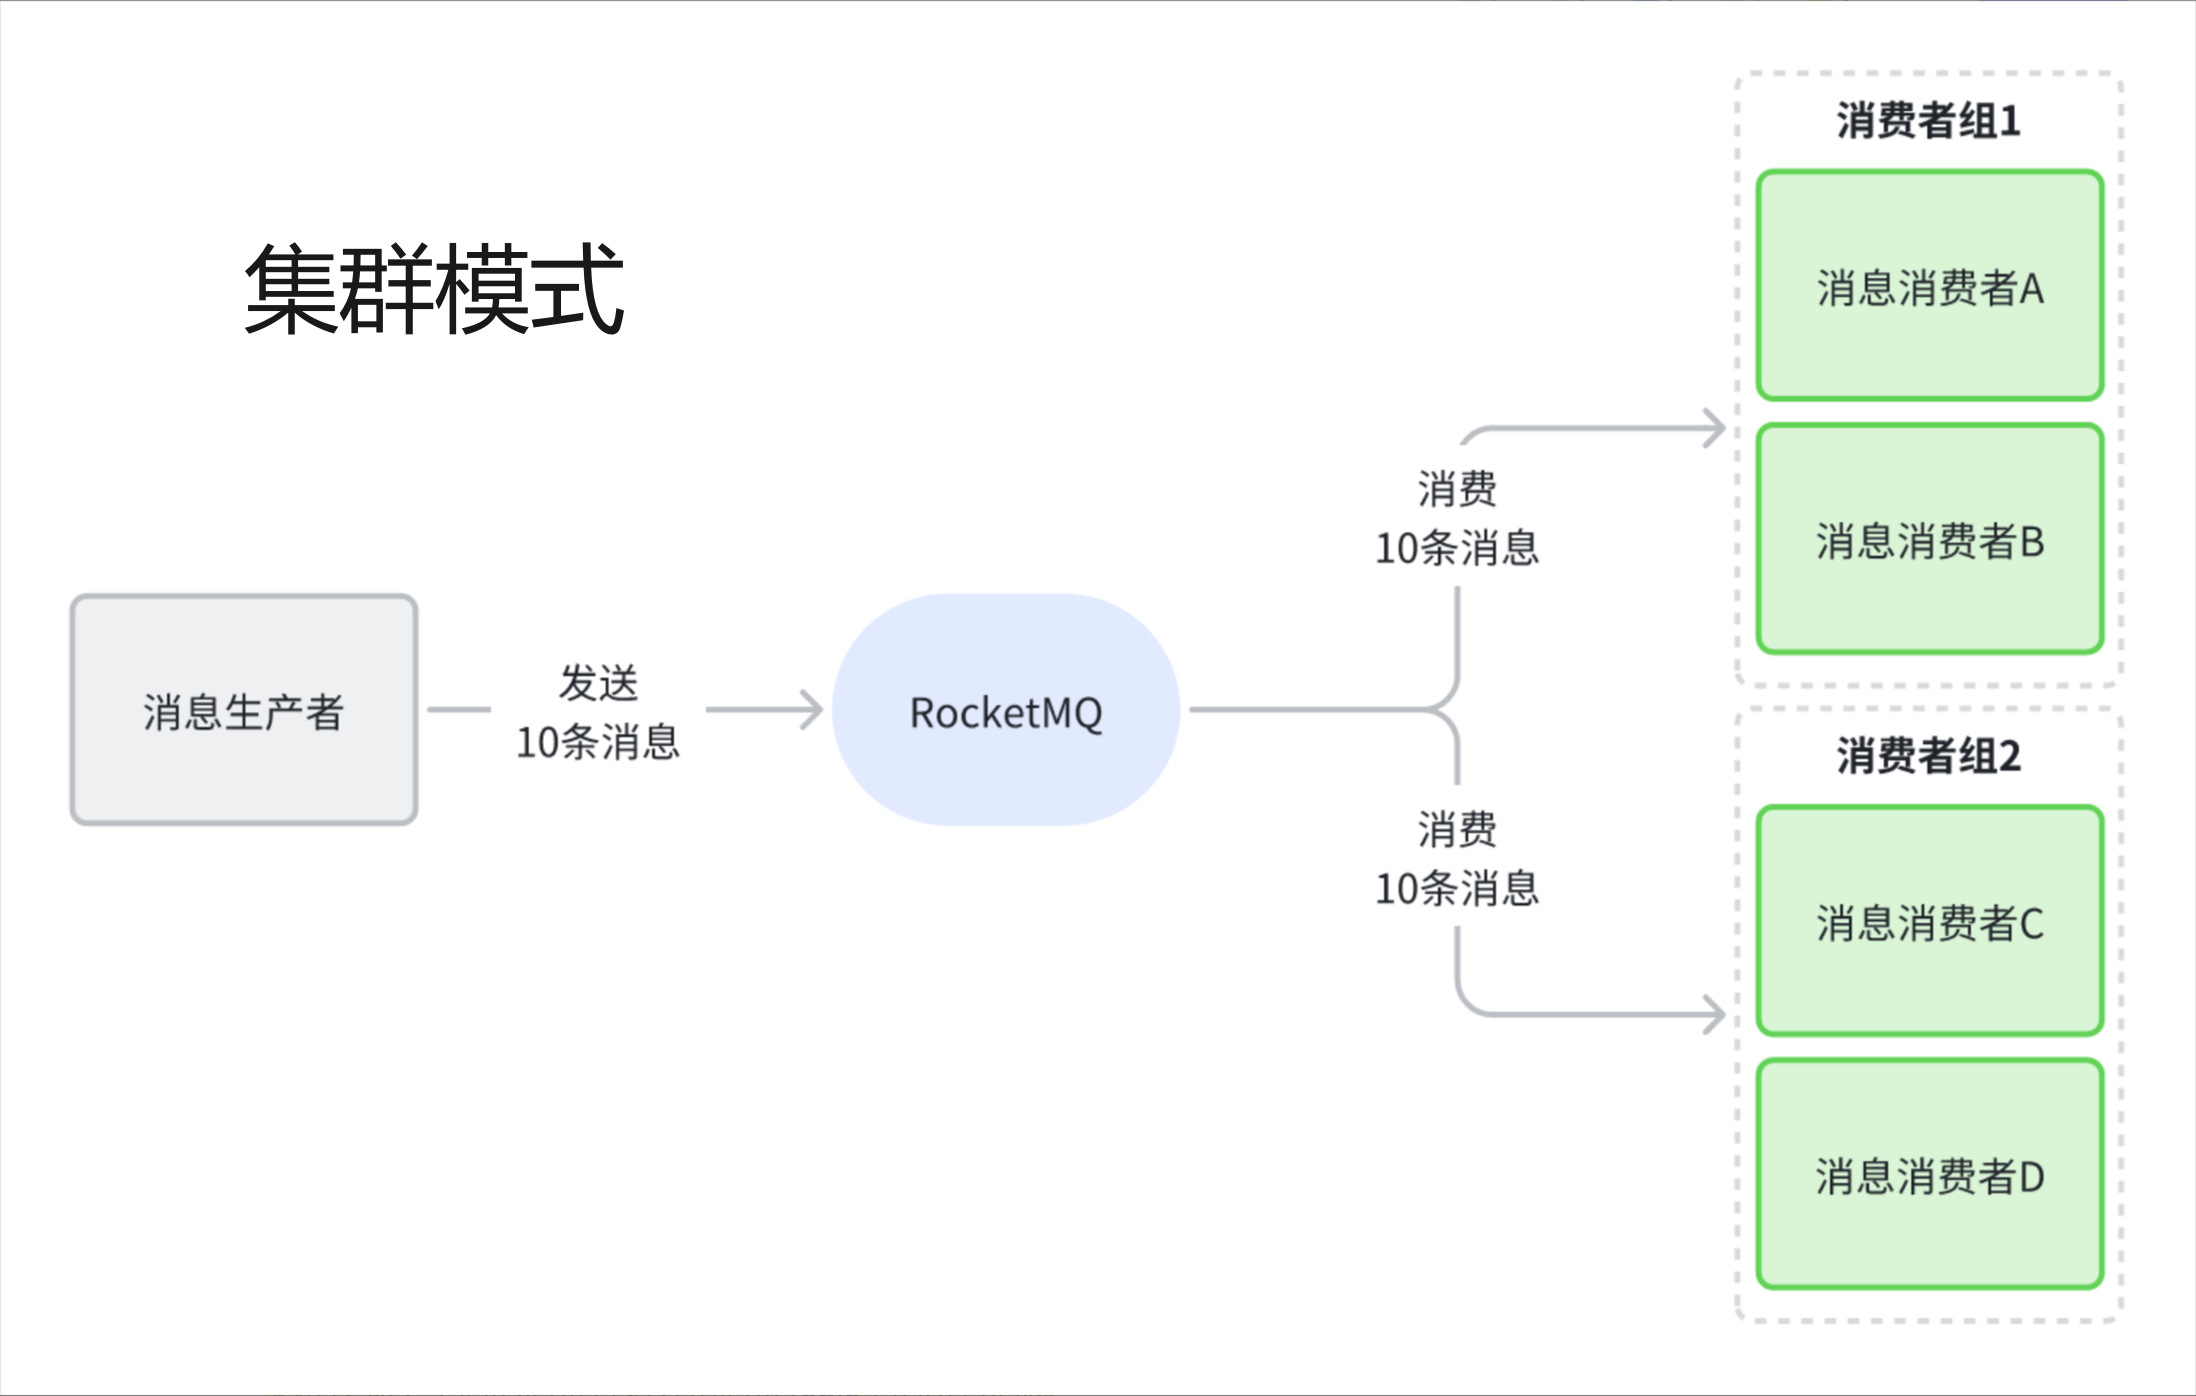
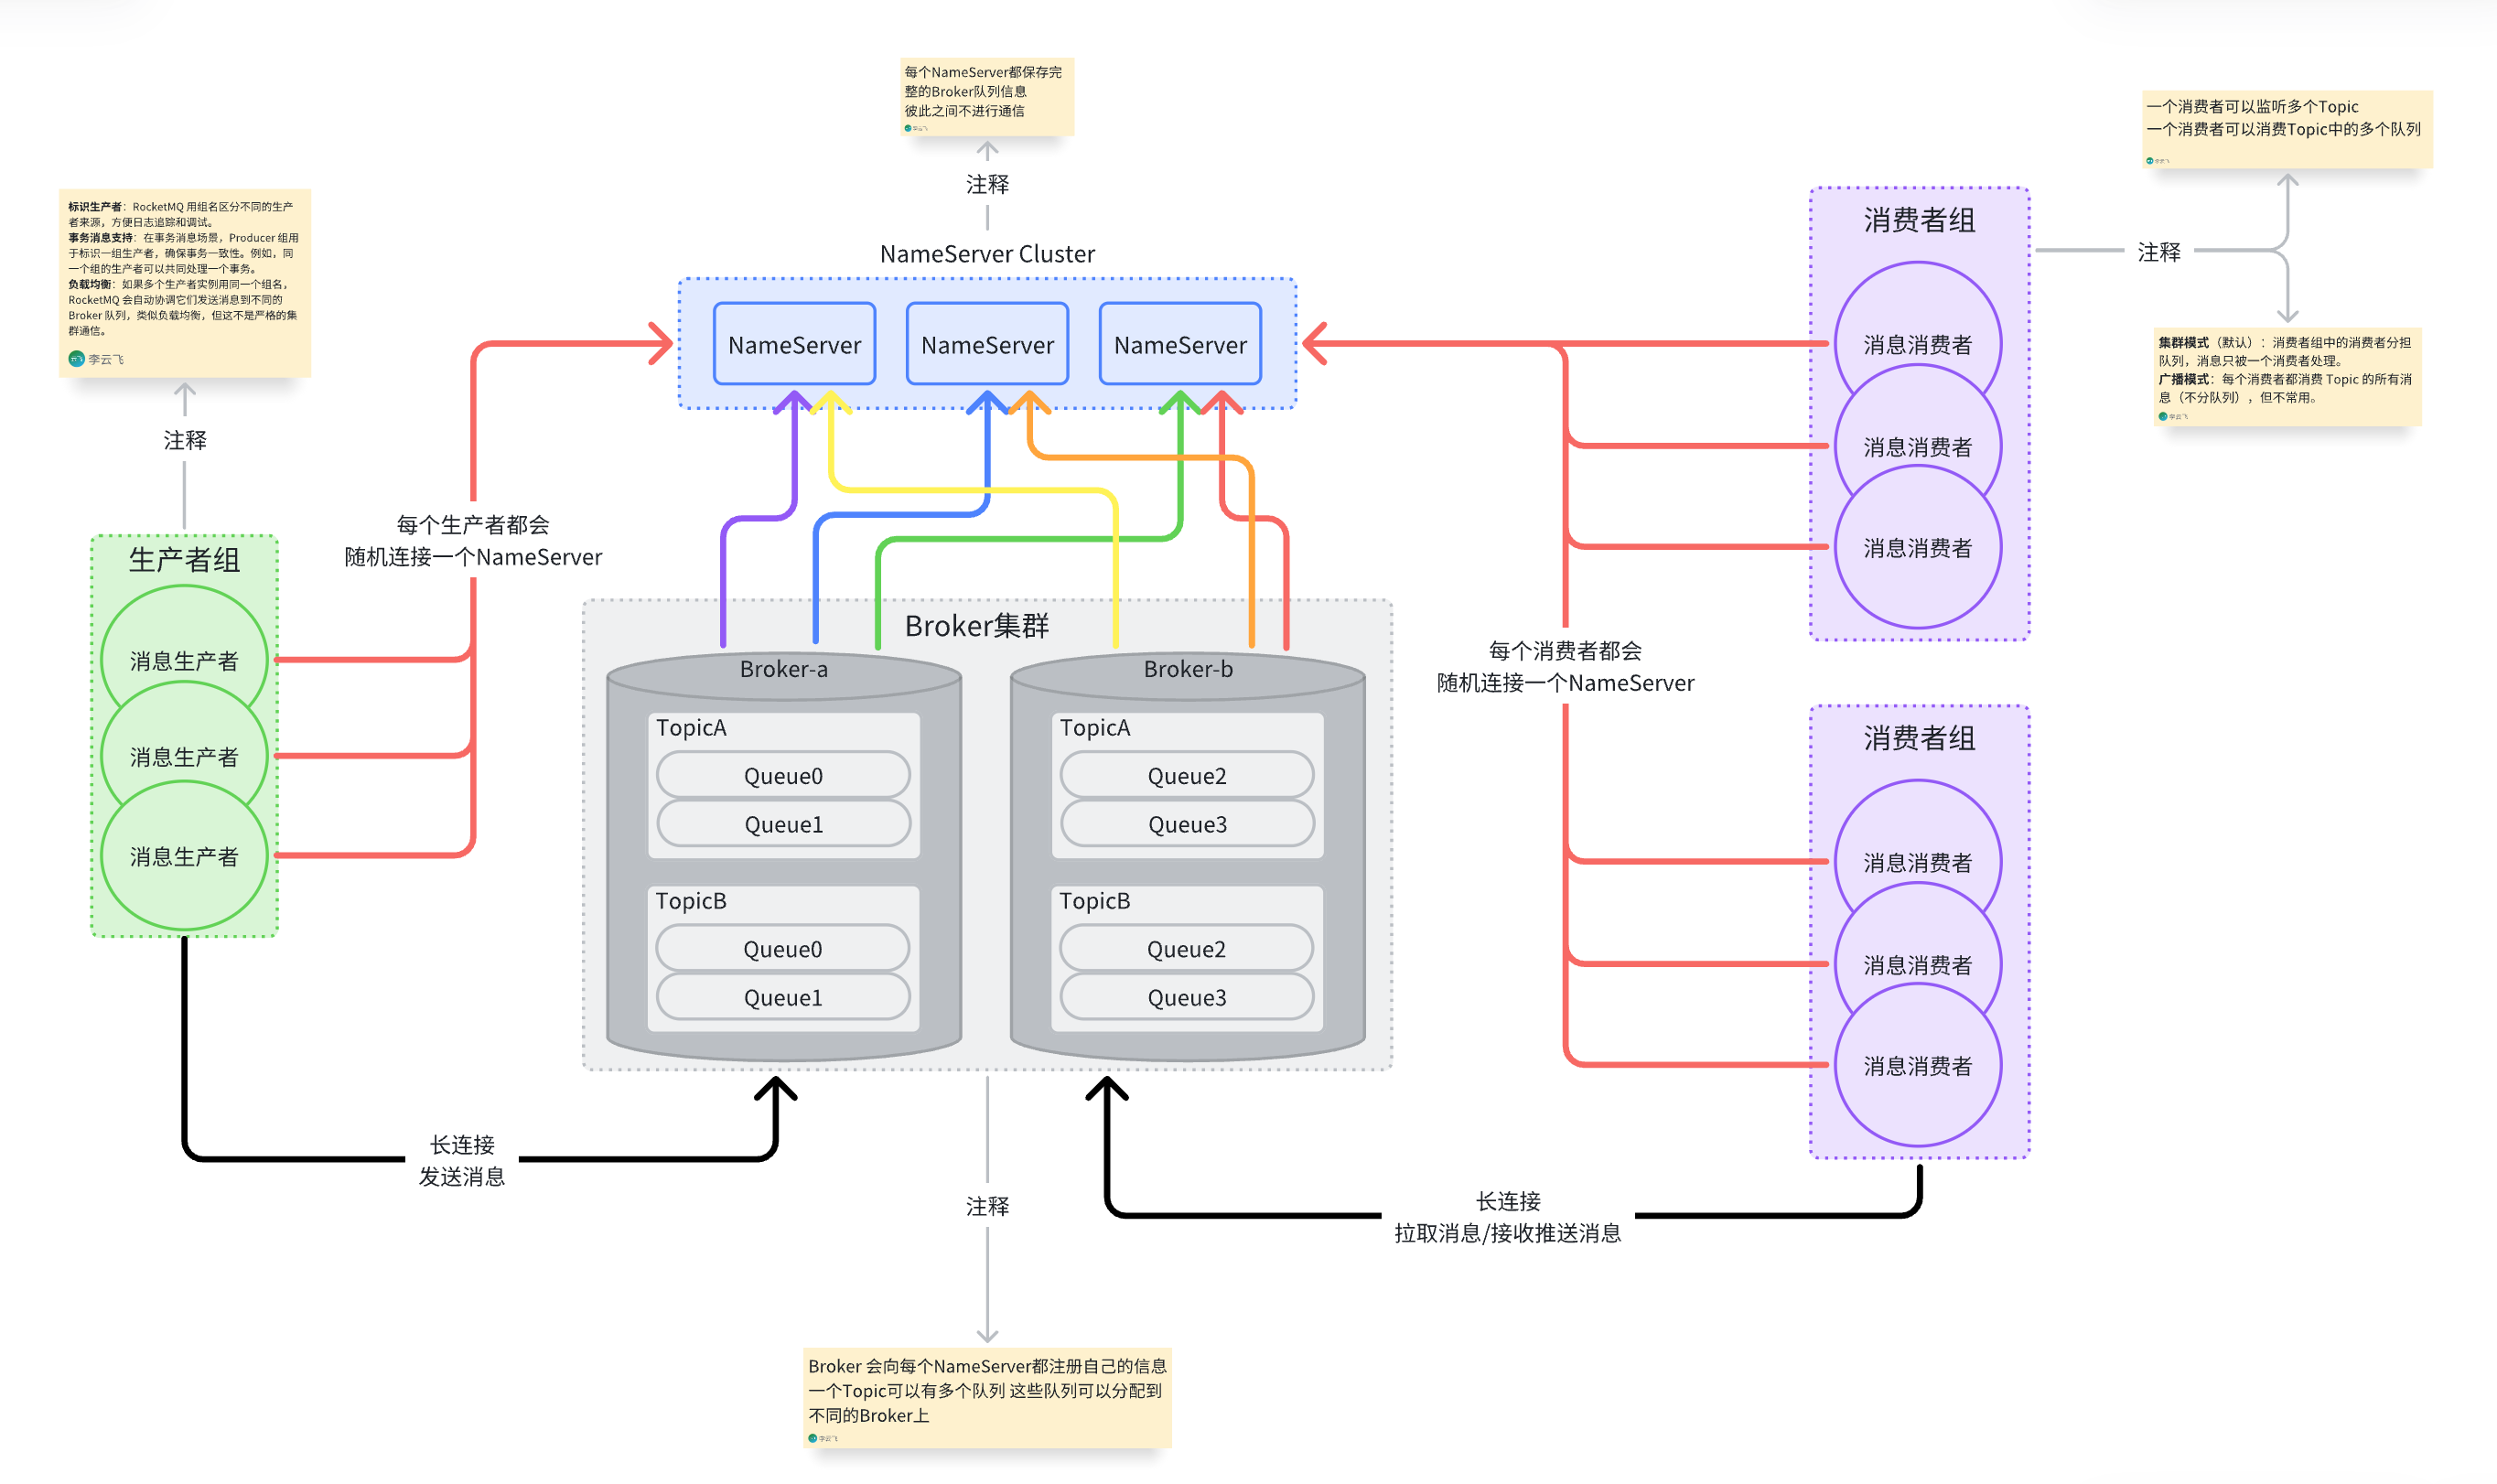
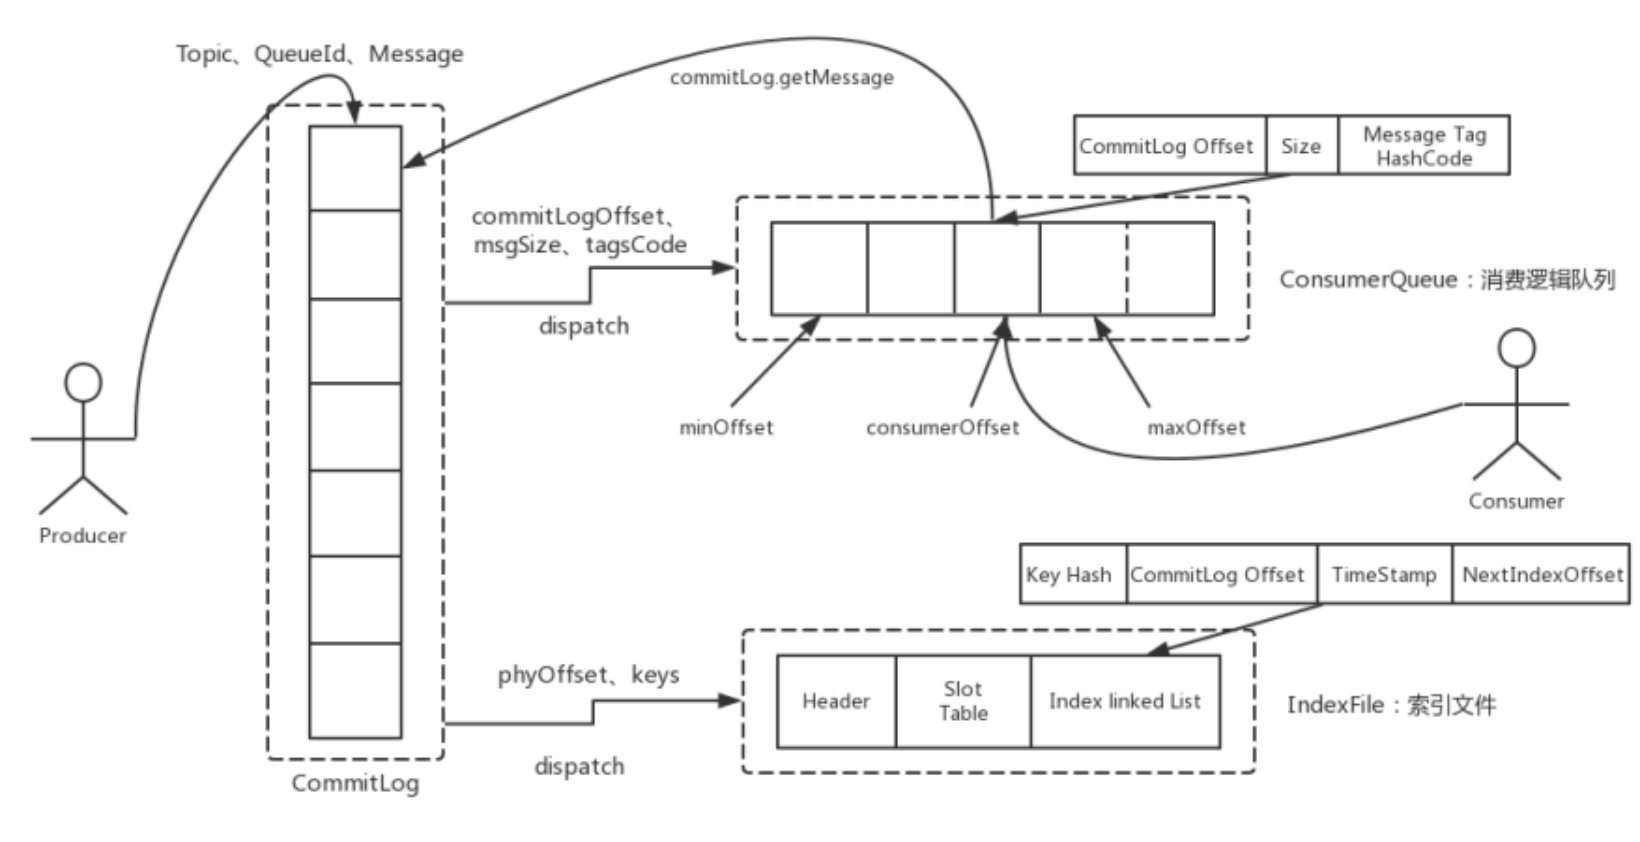
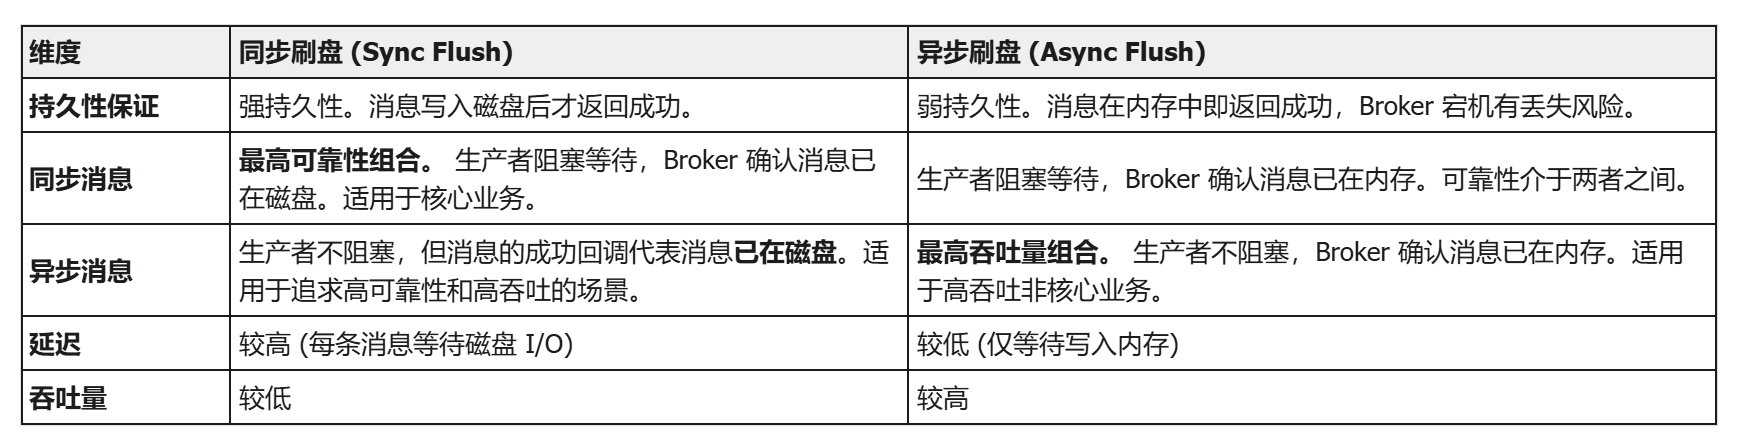
      <![CDATA[<h2 id="发送同步消息，如果出现了异常，怎么进行可靠性保障？"><a href="#发送同步消息，如果出现了异常，怎么进行可靠性保障？" class="headerlink" title="发送同步消息，如果出现了异常，怎么进行可靠性保障？"></a>发送同步消息，如果出现了异常，怎么进行可靠性保障？</h2><p>RocketMQ会默认进行重试（客户端内部进行的，看不见的），默认会重试2次，重试次数可以自己配置；<br>一般来说 如果重试都失败了，可能就是MQ服务器出现了异常&#x2F;宕机了，我们还需要再重试了，当然也可以编码，但是通常我们不会这么做，此时这个mq已经不能用了，但是我们要把这个消息保存到 MySQL，XXL-J0B 定时去扫描这个表，然后重新进行发送和消费消息</p><h2 id="如何保证顺序消息？"><a href="#如何保证顺序消息？" class="headerlink" title="如何保证顺序消息？"></a>如何保证顺序消息？</h2><p>产生乱序的原因：</p><p>生产者把消息发送到Topic的时候，默认是存储到了4个队列中，每个队列可能会被不同的消费者或不同的线程进行消费，而我们没法控制消费者或者线程的执行顺序，所以会产生乱序</p><p>保证顺序消息的前提：</p><ol><li>将一组需要保证顺序的消息放到同一个队列</li><li>使用单线程进行消费</li></ol><h2 id="你在开发中有没有使用到MQ的事务消息？使用的业务场景是什么？为什么使用事务消息？"><a href="#你在开发中有没有使用到MQ的事务消息？使用的业务场景是什么？为什么使用事务消息？" class="headerlink" title="你在开发中有没有使用到MQ的事务消息？使用的业务场景是什么？为什么使用事务消息？"></a>你在开发中有没有使用到MQ的事务消息？使用的业务场景是什么？为什么使用事务消息？</h2><p>使用过，场景是XXX</p><p><strong>为了保证消息和本地事务的一致性</strong></p><p>事务消息核心：</p><ol><li><strong>half消息机制</strong>: 事务消息发送到MQ后会先被暂存起来(存储到一个特定的事务Topic中) 直到收到生产者发送来的COMMIT 才会把消息推送给消费者</li><li><strong>回查机制</strong>: MQ如果没有收到生产者发送过来的COMMIT&#x2F;ROLLBACK 会自动去调用生产者的回调方法检查本地事务执行结果</li></ol><h2 id="我使用同步消息加事务注解的方式可以代替事务消息吗？"><a href="#我使用同步消息加事务注解的方式可以代替事务消息吗？" class="headerlink" title="我使用同步消息加事务注解的方式可以代替事务消息吗？"></a>我使用同步消息加事务注解的方式可以代替事务消息吗？</h2><p>不可以！因为同步消息如果发生网络错误，<strong>无法判断MQ时候收到消息</strong>，是为送到就网络故障还是MQ收到消息返回时网络故障；</p><p>如果MQ<strong>收到消息返回时网络故障</strong>，加上事务注解的方法回滚事务，MQ消费了消息，还是会导致数据不一致，所以必须依赖事务消息的半消息+事务回查机制来保证事务</p><h2 id="广播模式和集群模式有什么区别？"><a href="#广播模式和集群模式有什么区别？" class="headerlink" title="广播模式和集群模式有什么区别？"></a>广播模式和集群模式有什么区别？</h2><p>广播模式就像是个人作业，每个消费者都要做，每个消费者组里的每个消费者都要消费topic里的所有消息；</p><p>集群模式就像是小组作业，每个消费者组都要做，一个消费者组里的消费者平分topic里的消息（组内负载均衡）。</p><p><img src="/images/upload/image-20251018093232912.png" alt="image-20251018093232912.png"></p><p><img src="/images/upload/image-20251018093325219.png" alt="image-20251018093325219.png"></p><h2 id="RocketMQ的架构是什么样？"><a href="#RocketMQ的架构是什么样？" class="headerlink" title="RocketMQ的架构是什么样？"></a>RocketMQ的架构是什么样？</h2><ul><li>NameServer是RocketMQ的轻量级注册中心</li><li>Broker是消息的核心存储和转发组件</li><li>Producer负责生成消息并发送到指定的Topic</li><li>Consumer负责从Broker拉取并处理消息</li></ul><p><img src="/images/upload/image-20251018115953643.png" alt="image-20251018115953643.png"></p><h2 id="消息是如何传递的？"><a href="#消息是如何传递的？" class="headerlink" title="消息是如何传递的？"></a>消息是如何传递的？</h2><ol><li>Producer发送消息到Broker的指定Topic和Queue。</li><li>Broker存储消息（根据刷盘和复制策略），并维护消息的索引。</li><li>Consumer从Broker拉取消息，按订阅规则处理。</li><li>NameServer持续提供路由支持，确保Producer和Consumer能动态发现Broker。</li><li>如果Broker集群包含Master和Slave，消息会在主从间复制以提高可靠性；Consumer可从Master或Slave（视配置）消费消息。</li></ol><h2 id="NameServer-集群之间会相互通信吗？"><a href="#NameServer-集群之间会相互通信吗？" class="headerlink" title="NameServer 集群之间会相互通信吗？"></a>NameServer 集群之间会相互通信吗？</h2><p><strong>不会</strong>，每个 NameServer 独立记录 Broker 和 Topic 的信息（比如哪个 Broker 存了哪些 Topic）。它们之间不聊天，每个 NameServer 自己维护一份完整的数据副本。</p><h2 id="Broker-会连接到每个-NameServer-吗，还是只连接到一个-NameServer-就可以了？"><a href="#Broker-会连接到每个-NameServer-吗，还是只连接到一个-NameServer-就可以了？" class="headerlink" title="Broker 会连接到每个 NameServer 吗，还是只连接到一个 NameServer 就可以了？"></a>Broker 会连接到每个 NameServer 吗，还是只连接到一个 NameServer 就可以了？</h2><p>Broker 会 <strong>连接到所有 NameServer</strong></p><h2 id="如果-Broker-崩溃了，NameServer-如何感知？"><a href="#如果-Broker-崩溃了，NameServer-如何感知？" class="headerlink" title="如果 Broker 崩溃了，NameServer 如何感知？"></a>如果 Broker 崩溃了，NameServer 如何感知？</h2><p>Broker 会每隔一段时间（30秒）向所有的 NameServer 发送一次心跳包，如果 NameServer 在一段时间（默认 120s）没有收到某个 Broker 的心跳，就认为该 Broker 已崩溃，会从路由表中移除它。</p><h2 id="Broker-集群之间会相互通信吗？"><a href="#Broker-集群之间会相互通信吗？" class="headerlink" title="Broker 集群之间会相互通信吗？"></a>Broker 集群之间会相互通信吗？</h2><p><strong>不会直接相互通信</strong>，只有主从关系主节点会把消息复制到从节点</p><h2 id="一个-Topic-可以存储在多个-Broker-上吗？存储的数据是相同的还是不同的？"><a href="#一个-Topic-可以存储在多个-Broker-上吗？存储的数据是相同的还是不同的？" class="headerlink" title="一个 Topic 可以存储在多个 Broker 上吗？存储的数据是相同的还是不同的？"></a>一个 Topic 可以存储在多个 Broker 上吗？存储的数据是相同的还是不同的？</h2><p>一个 Topic <strong>可以存储在多个 Broker 上</strong>。存储的数据 <strong>通常是不同的</strong>，因为 Topic 的消息被分成多个队列（Queue），分散在不同 Broker 上。</p><h2 id="一个消费者可以同时监听多个-Topic-吗？"><a href="#一个消费者可以同时监听多个-Topic-吗？" class="headerlink" title="一个消费者可以同时监听多个 Topic 吗？"></a>一个消费者可以同时监听多个 Topic 吗？</h2><p>可以</p><blockquote><p>具体实现得看消费者如何定义，如果是一台服务器为一个消费者，那么可以通过多个类监听同一个topic，通过tag来区分不同；如果一个类为一个消费者，那么只能通过传统的API方式订阅多个topic</p></blockquote><h2 id="你们RocketMQ项目用的什么集群架构？"><a href="#你们RocketMQ项目用的什么集群架构？" class="headerlink" title="你们RocketMQ项目用的什么集群架构？"></a>你们RocketMQ项目用的什么集群架构？</h2><p>我们项目用的是多主多从的主从架构。Master 处理读写，Slave 处理读不可写，除非Slave角色更换成了Master，复制 Master 数据做备份。</p><h2 id="如果-Master-宕机了，Slave-会进行-Master-角色转换吗？"><a href="#如果-Master-宕机了，Slave-会进行-Master-角色转换吗？" class="headerlink" title="如果 Master 宕机了，Slave 会进行 Master 角色转换吗？"></a>如果 Master 宕机了，Slave 会进行 Master 角色转换吗？</h2><p>我记得在之前的版本，是不能自动切换的，从节点可以继续读，但是不能写了，只能手动配置更换主节点；</p><p>但是在5.0+之后好像就可以支持自动切换了</p><h2 id="主从同步的具体过程？"><a href="#主从同步的具体过程？" class="headerlink" title="主从同步的具体过程？"></a>主从同步的具体过程？</h2><p>从节点主动先主节点发送同步请求，请求携带offset偏移量，告诉主节点从哪里返回数据给我，也就是就是继续从上一次同步的位置继续同步；</p><p>收到主节点返回的数据后从节点会将数据存储到CommitLog中，同时更新自己的offset。</p><h2 id="主从同步的两种方式？"><a href="#主从同步的两种方式？" class="headerlink" title="主从同步的两种方式？"></a>主从同步的两种方式？</h2><ol><li><strong>同步复制</strong>：主节点和从节点要同时保存成功，才会给生产者返回响应；可靠性高，但性能相对较低</li><li><strong>异步复制</strong>：主节点保存成功就立即给生产者返回响应，从节点可能还没有进行保存；性能高，但可能存在数据丢失风险</li></ol><h2 id="消息的存储过程是怎样的？"><a href="#消息的存储过程是怎样的？" class="headerlink" title="消息的存储过程是怎样的？"></a>消息的存储过程是怎样的？</h2><blockquote><p>回答重点：</p><ol><li>消息实际存储在 CommitLog 中，ConsumeQueue 中只存储了消息在 CommitLog 中的偏移量</li><li>消费者监听的 Topic 队列实际是监听的 ConsumeQueue（每个Topic中的每个队列都会对应一个ConsumeQueue），通过 ConsumeQueue 中的偏移量去CommitLog中找实际消息</li><li>CommitLog 不止发给了 ConsumeQueue，还发给了 IndexFile 方便通过消息ID快速查找</li></ol></blockquote><p>Producer 发送消息到 Broker 之后，Broker 使用同步或者异步的方式将消息持久化，保存到 CommitLog 中，当消息持久化到 CommitLog 之后，消息就不会丢失，可以根据 CommitLog 来进行消息重发。</p><p>生产者发送消息给MQ，MQ会把这些消息一股脑的都存储在CommitLog中，没有区分Topic和队列，然后CommitLog存储完消息后会把这个消息的大小 、消息存储在CommitLog中的偏移量(存在CommitLog中的物理位置)、消息标签的hash值都转发给ConsumeQueue；</p><p>每个Topic中的每个队列都会对应一个ConsumeQueue，消费者在对Topic进行监听的时候，其实的对ConsumeQueue进行监听，然后从ConsumeQueue中获取要消费的消息，但是消息存储在CommitLog中，</p><p>因为ConsumeQueue中有这个消息存储在CommitLog中的位置，所以可以根据这个位置直接定位到CommitLog中把消息取出来。</p><p>同时CommitLog在存储消息之后还会向IndexFile中转发这个消息的Key和消息ID，以后我们就可以直接通过这个消息ID快速查找这个消息在CommitLog中的位置。</p><p><img src="/images/upload/image-20251018175635483.png" alt="image-20251018175635483.png"></p><h2 id="RocketMQ为什么这么快-性能为什么这么高？"><a href="#RocketMQ为什么这么快-性能为什么这么高？" class="headerlink" title="RocketMQ为什么这么快 &#x2F; 性能为什么这么高？"></a>RocketMQ为什么这么快 &#x2F; 性能为什么这么高？</h2><p>首先MQ会把这个消息<strong>顺序写</strong>到commitlog中 ，然后再通过consumerqueue去索引消息可以快速从commitlog中定位到消息；</p><p>MQ还使用了<strong>mmap</strong>的这种<strong>零拷贝</strong>技术 实现了MQ内存和操作系统内存的映射 减少了数据往应用层内存拷贝的次数。</p><h2 id="消息的刷盘机制？"><a href="#消息的刷盘机制？" class="headerlink" title="消息的刷盘机制？"></a>消息的刷盘机制？</h2><ul><li><strong>同步刷盘</strong><ol><li>生产者发送消息</li><li>Broker接收消息</li><li>消息写入PageCache（内存映射文件）</li><li><strong>立即调用force()方法强制刷盘</strong></li><li>等待数据真正写入磁盘</li><li><strong>刷盘完成后返回响应给生产者</strong></li></ol></li><li><strong>异步刷盘</strong><ol><li>生产者发送消息</li><li>Broker接收消息</li><li>消息写入PageCache（内存映射文件）</li><li><strong>立即返回响应给生产者（不等待刷盘）</strong></li><li><strong>后台线程异步执行刷盘</strong></li><li><strong>定时或达到阈值时批量刷盘</strong><ul><li>触发条件：<ul><li>时间间隔：默认500ms执行一次</li><li>脏页数量：达到一定阈值</li><li>系统要求：操作系统内存压力时主动刷盘</li><li>正常关机：内存中数据会写入磁盘</li></ul></li></ul></li></ol></li></ul><h2 id="同步-异步的消息、刷盘、复制之间的关系"><a href="#同步-异步的消息、刷盘、复制之间的关系" class="headerlink" title="同步&#x2F;异步的消息、刷盘、复制之间的关系"></a>同步&#x2F;异步的消息、刷盘、复制之间的关系</h2><p>同步消息：发送消息  等着返回  执行后续代码</p><p>异步消息：发送消息  执行后续代码  执行回调</p><p>同步刷盘：接收消息  写入磁盘  返回响应</p><p>异步刷盘：接收消息  返回响应  写入磁盘</p><p>同步复制：主服务器接收消息  同步从服务器  返回响应</p><p>异步复制：主服务器接收消息  返回响应  同步从服务器</p><p><img src="/images/upload/image-20251020105635781.png" alt="image-20251020105635781"></p><p>要达到<strong>最高可靠性</strong>，使用 <strong>同步消息发送 + 同步刷盘</strong> 的组合。</p><p>要达到<strong>最高吞吐量</strong>，使用 <strong>异步消息发送 + 异步刷盘</strong> 的组合。</p><p>在实际生产中，RocketMQ 默认的配置通常是：<strong>异步刷盘（Async Flush） + 主从异步复制（ASYNC_MASTER）</strong>，兼顾性能和可靠性。</p><h2 id="触发再平衡的时机？"><a href="#触发再平衡的时机？" class="headerlink" title="触发再平衡的时机？"></a>触发再平衡的时机？</h2><p>当消费者组变化（如新消费者加入、旧消费者下线、Queue 数变化）时，立即触发再平衡</p><h2 id="RocketMQ消息发送失败的重试策略？"><a href="#RocketMQ消息发送失败的重试策略？" class="headerlink" title="RocketMQ消息发送失败的重试策略？"></a>RocketMQ消息发送失败的重试策略？</h2><p>&#x3D;&#x3D;消息重试只在<strong>集群消费 (Clustering)</strong> 模式下生效！&#x3D;&#x3D;</p><blockquote><p>无序消息：采用阶梯式延时投递，最大重试16次（可配置）。消费失败的会存入一个重试Topic（有就添加，没有就创建），并将消息转为延时消息，到时间后会作为一条新的普通消息，重新自动投递到对应消费者组的重试 Topic 队列，消费者自动订阅了这条队列进行二次消费</p><p>有序消息：有序消息为了保证顺序，会阻塞后续消息，无限次不断重新投递给消费者</p><p>处理方式：加强监控，及时通知开发人员</p></blockquote><ul><li><p>无序消息：RocketMQ 采用<strong>延时投递</strong>的方式进行重试，并使用<strong>阶梯式重试间隔</strong>来避免瞬时故障对系统造成持续压力</p><ol><li>**消费失败：**当一条无序消息被消费者消费失败后会通知 Broker进行消息重试。</li><li><strong>创建重试Topic：</strong> Broker 检查该消费者是否有重试Topic <code>%RETRY% + consumerGroupName</code>如果没有则自动创建，该重试Topic的名称是固定格式且是懒加载，只有出现重试消息时才会创建，且会被消费者组自动订阅，每个消费者组对应自己的重试Topic。</li><li><strong>时间调度：</strong> Broker 将重试消息转化为延迟消息，根据重试次数选择对应的延迟等级，并将重试消息存入内部的<strong>延迟 Topic</strong>（SCHEDULE_TOPIC_XXXX）的队列中。</li><li><strong>定时轮询：</strong> Broker 的定时器线程扫描 <code>SCHEDULE_TOPIC_XXXX </code>。</li><li><strong>到期投递：</strong> 当消息到期时，定时器线程将其取出，并将消息作为一条<strong>新的普通消息</strong>，投递到<strong>重试 Topic</strong> (<code>%RETRY% + consumerGroupName</code>) 的某个队列中。</li><li><strong>消费者拉取：</strong> 消费者因为自动订阅了<code>%RETRY% + consumerGroupName</code>，从而拉取到消息进行二次消费。</li></ol><ul><li><strong>最大重试次数：</strong> 默认是 <strong>16 次</strong>（可配置）。</li></ul></li><li><p>有序消息：为了保证同一个<strong>Sharding Key</strong>（如订单 ID）下的消息消费顺序，严格按照发送顺序进行</p><ol><li><strong>阻塞重试：</strong> 有序消息在消费失败后，Broker <strong>不会进行延时投递</strong>。它会<strong>无限次地、立即、不断地</strong>将失败消息重新投递给<strong>当前的消费者</strong>，每次重试间隔通常为 <strong>1 秒</strong>（具体取决于版本和配置）。</li><li><strong>消费阻塞：</strong> 由于顺序性的要求，只要该消息没有消费成功，<strong>该队列 (Queue) 后续的所有消息都会被阻塞</strong>，无法被投递给任何消费者。</li></ol></li><li><p>处理建议：对顺序消息的消费情况设置严格告警。在消费者代码中对异常进行严格包裹处理，如果出现消息消费失败的情况，要及时记录消息或者通知开发人员。</p></li></ul><h2 id="什么是死信队列？"><a href="#什么是死信队列？" class="headerlink" title="什么是死信队列？"></a>什么是死信队列？</h2><p>死信机制是消息重试的<strong>最终兜底方案</strong>。当一条无序消息在达到最大重试次数(默认16次)后仍然消费失败，RocketMQ 会将其转移到死信队列  (Dead Letter Queue, DLQ)。一个死信队列对应<strong>一个消费组</strong>，该消费组内所有 Topic 产生的死信消息都会被收集到这一个 DLQ 中。一旦消息进入 DLQ，它将<strong>永远不会</strong>被原来的消费者组（GroupID）正常消费到。死信消息默认有保留时间，超时后会被系统自动清理。</p><h2 id="如何处理死信队列？"><a href="#如何处理死信队列？" class="headerlink" title="如何处理死信队列？"></a>如何处理死信队列？</h2><p>用户可以创建独立的消费者组订阅死信Topic，将死信消息记录到日志、发送警报给开发人员、存储到数据库，或者人工审核后重新发送到原来的Topic。</p><h2 id="RocketMQ-如何保证消息不丢失（消息的可靠性）"><a href="#RocketMQ-如何保证消息不丢失（消息的可靠性）" class="headerlink" title="RocketMQ 如何保证消息不丢失（消息的可靠性）"></a>RocketMQ 如何保证消息不丢失（消息的可靠性）</h2><p><strong>生产者</strong>：如果消息发送失败，MQ会默认进行2次重试，如果还是发送失败，我们可以捕获MQ返回的异常然后把消息进行其他位置的存储(Redis&#x2F;MySQL)，最后再人为干预处理这些发送失败的消息。</p><p><strong>Broker</strong>：消息到达MQ后会先存储中内存中，我们可以配置同步刷盘将消息立即存储到硬盘，同时也可以配置主从到同步复制，让消息中从服务器中也存储一份。</p><p><strong>消费者</strong>：如果消费者消费失败消息会自动进行重试，如果达到重试次数会进入到死信，我们可以去写个消费者监听这个死信队列，然后处理死信消息。</p><h2 id="RocketMQ-如何保证消息的顺序性"><a href="#RocketMQ-如何保证消息的顺序性" class="headerlink" title="RocketMQ 如何保证消息的顺序性"></a>RocketMQ 如何保证消息的顺序性</h2><p>首先我们要保证顺序必须知道为什么会产生乱序：多个顺序消息在进行发送的时候，默认是会轮询存储到不同的队列中，每个队列可能是有不同的消费者实例或者是不同的线程进行消费的，我们不能保证多个实例或者多个线程的消费顺序。</p><p>那我们保证顺序的就是：把消息放到一个队列中，并用单线程消费</p><h2 id="RocketMQ-消息堆积了怎么解决"><a href="#RocketMQ-消息堆积了怎么解决" class="headerlink" title="RocketMQ 消息堆积了怎么解决"></a>RocketMQ 消息堆积了怎么解决</h2><p>发生消息堆积首先想到的就是增加消费者暂时解决或缓解问题，再排查是否有消息有耗时操作（如IO&#x2F;大量计算&#x2F;大量数据排序等），再评估消费者个数。</p><h2 id="RocketMQ-如何保证高可用性"><a href="#RocketMQ-如何保证高可用性" class="headerlink" title="RocketMQ 如何保证高可用性"></a>RocketMQ 如何保证高可用性</h2><p><strong>NameServer</strong>：部署多个NameServer集群，多节点独立运行，互不依赖。</p><p><strong>Broker集群</strong>：采用多 Master 多 Slave的主从架构，配置主从复制，实现自动故障转移。</p><h2 id="RocketMQ-如何保证幂等性-确保消息不会被重复消费"><a href="#RocketMQ-如何保证幂等性-确保消息不会被重复消费" class="headerlink" title="RocketMQ 如何保证幂等性 &#x2F; 确保消息不会被重复消费"></a>RocketMQ 如何保证幂等性 &#x2F; 确保消息不会被重复消费</h2><p>有些操作天然就是幂等性的，比如MySQL中的删除操作，执行多次同一个SQL语句，对数据库影响是一致的；如果消费逻辑中就都是幂等性的操作，其实可以不用去做非幂等性的措施。</p><p>对于非幂等性的操作来说，我们要进行处理，防止一个消息被重复消费多次，记录每次消费过的消息ID，<strong>存储到Redis&#x2F;MySQL中</strong>，再每次消费前先查询是否已经被消费过；</p><p>如果消费操作是操作数据库的，我们可以根据业务自动判断查询数据库中是否已经操作过这个数据了，如果是更新的，可以使用<strong>乐观锁</strong></p><h2 id="RocketMQ-消息存储过程是什么"><a href="#RocketMQ-消息存储过程是什么" class="headerlink" title="RocketMQ 消息存储过程是什么"></a>RocketMQ 消息存储过程是什么</h2><p>消息生产者发送消息给MQ的Broker，Broker会先把消息存储到内存（Page Cache），如果配置的是同步刷盘，消息会立即存储到磁盘，如果配置的是异步刷盘，消息不会立即存储磁盘</p><p>消息中存储到磁盘的时候，先直接存储到Commit Log中，同时Commit Log还会向ConsumerQueue和Index File做两次转发，ConsumerQueue会记录消息在CommitLog中存储的位置信息，Index File会记录消息的Key和消息的ID，同时还会记录消息在CommitLog中存储的位置信息。</p><h2 id="RocketMQ-的架构是怎么样的"><a href="#RocketMQ-的架构是怎么样的" class="headerlink" title="RocketMQ 的架构是怎么样的"></a>RocketMQ 的架构是怎么样的</h2><p>Name Server：记录Broker中的Topic的信息，多个Name Server之间不会进行通信，依靠Broker进行数据同步</p><p>Broker： 存储消息的，启动会向Name Server进行注册，同时还会向Name Server发送心跳</p><p>Producer： 发送消息的，会先从Name Server根据Topic获取Broker的信息，然后发送消息给Broker</p><p>Consumer：接收消息的，会先从Name Server根据Topic获取Broker的信息，然后从Broker接收消息</p><h2 id="RocketMQ延时消息不同版本的实现方式？"><a href="#RocketMQ延时消息不同版本的实现方式？" class="headerlink" title="RocketMQ延时消息不同版本的实现方式？"></a>RocketMQ延时消息不同版本的实现方式？</h2><ul><li><p>在<strong>4.x</strong>版本是通过<strong>延时级别</strong>实现的，消息会先放进一个系统延迟队列里，Broker 后台线程定时扫描，到期后再投递到真实主题，精度是秒级，默认<strong>18个级别</strong>，从1s-2h（<em>1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h</em>）</p></li><li><p>在<strong>5.x</strong>版本改为采用<strong>时间轮</strong>机制实现，可以设置任意毫秒级的投递时间，延时精度更高、性能更好，也没有固定档位限制</p></li></ul>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/rocketmq-interview/</id>
    <link href="https://blog.wangbowei.com/archives/rocketmq-interview/"/>
    <published>2025-10-09T16:23:00.000Z</published>
    <summary>发送同步消息，如果出现了异常，怎么进行可靠性保障？ RocketMQ会默认进行重试（客户端内部进行的，看不见的），默认会重试2次，重试次数可以自己配置； 一般来说 如果重试都失败了，可能就是MQ服务器出现了异常/宕机了，我们还需要再重试了，当然也可以编码，但是通常我们不会这么做，此时这个mq已经不能</summary>
    <title>RocketMQ 八股文面试题</title>
    <updated>2026-04-09T16:23:55.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="中间件" scheme="https://blog.wangbowei.com/categories/%E4%B8%AD%E9%97%B4%E4%BB%B6/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="Redis" scheme="https://blog.wangbowei.com/tags/Redis/"/>
    <content>
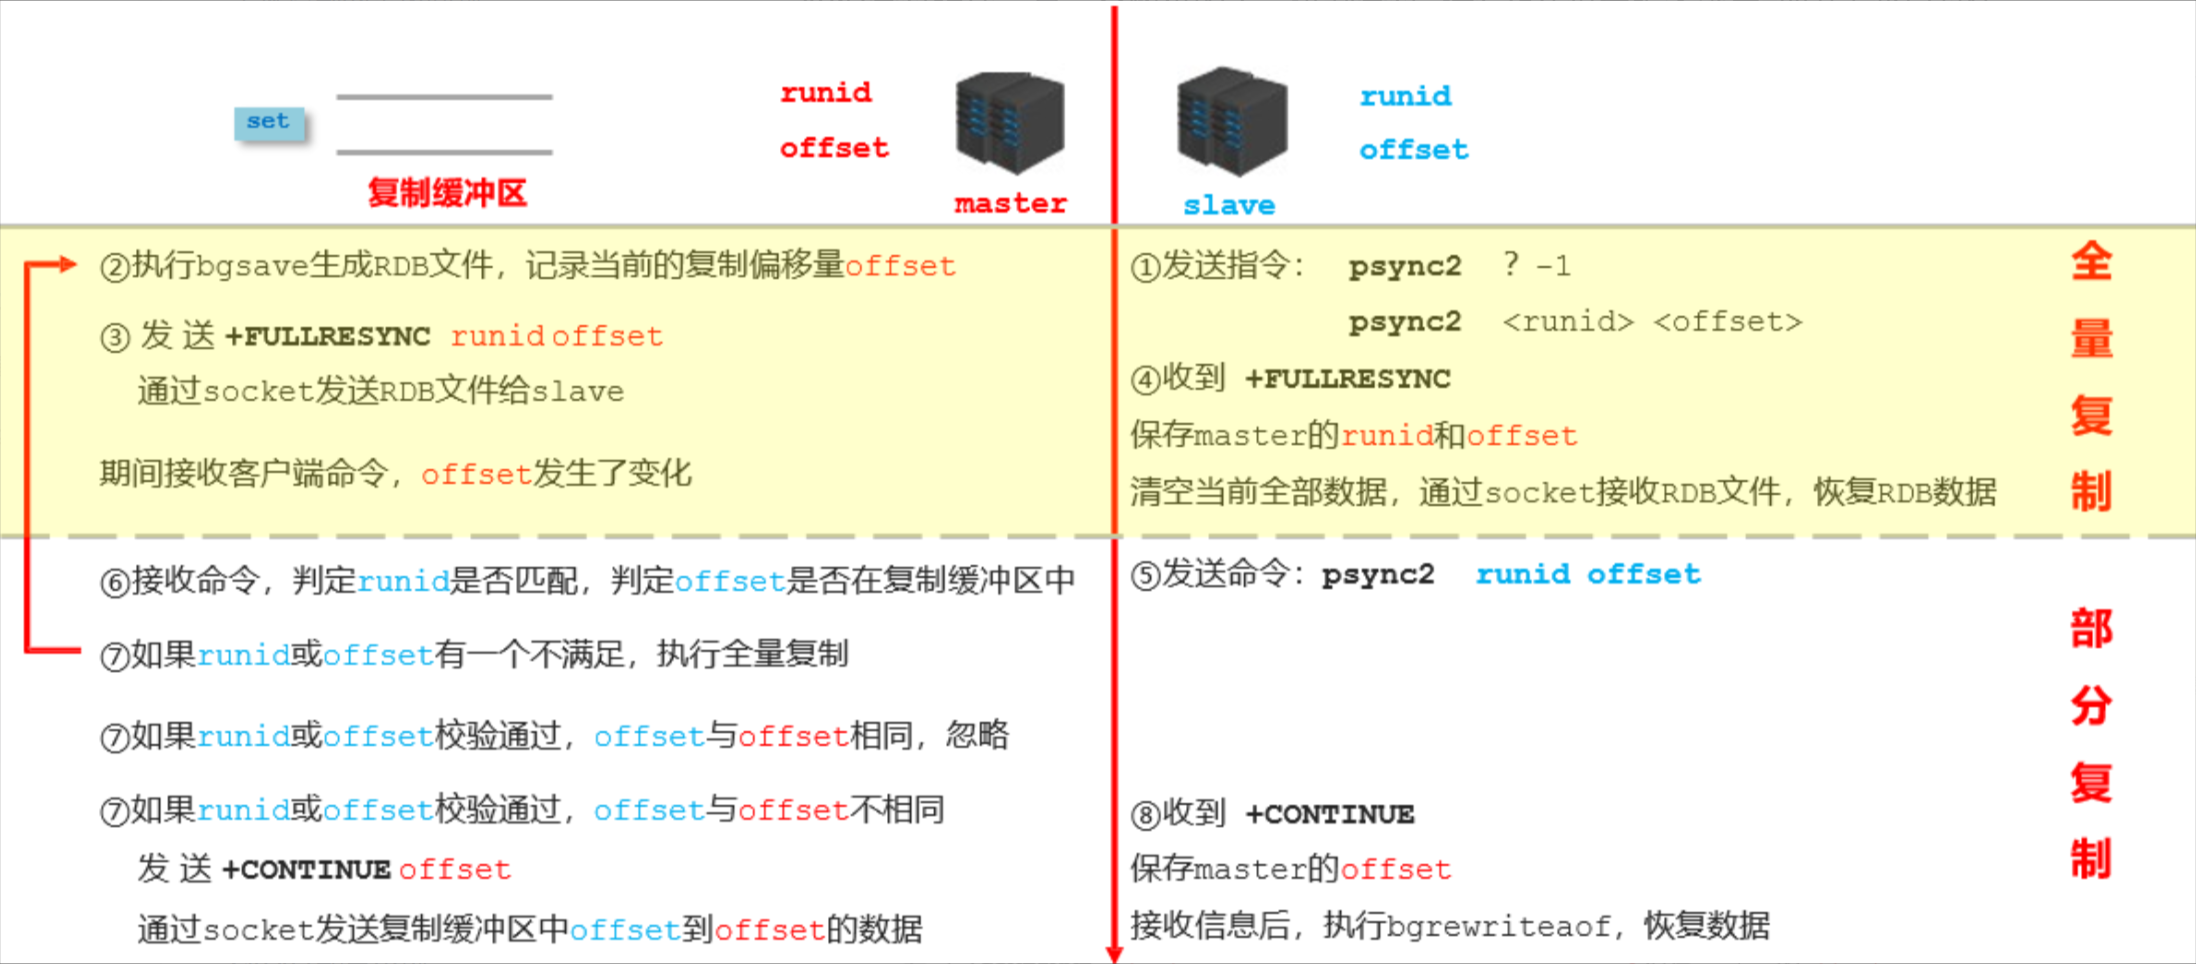
      <![CDATA[<h2 id="你在开发中都是怎么使用Redis的"><a href="#你在开发中都是怎么使用Redis的" class="headerlink" title="你在开发中都是怎么使用Redis的 ?"></a>你在开发中都是怎么使用Redis的 ?</h2><p>我主要使用的是 Redis的<strong>缓存</strong>和它的<strong>分布式锁</strong>功能</p><h2 id="Redis-为什么快？"><a href="#Redis-为什么快？" class="headerlink" title="Redis 为什么快？"></a>Redis 为什么快？</h2><ol><li>基于<strong>内存</strong>操作：内存的速度远高于访问磁盘的速度</li><li><strong>单线程 + I&#x2F;O 多路复用</strong>：避免了多线程带来的<strong>锁竞争</strong>、<strong>上下文切换</strong>的开销。</li><li><strong>高效的底层数据结构</strong>和编码：使用内存紧凑的 <strong>ziplist</strong> <strong>(压缩列表)</strong> 来存储数据，以节省内存空间。</li><li><strong>非阻塞</strong>操作：对于耗时的操作（如持久化），会交由子进程去处理，主进程继续响应客户端请求</li></ol><h2 id="数据持久化的方式？"><a href="#数据持久化的方式？" class="headerlink" title="数据持久化的方式？"></a>数据持久化的方式？</h2><ul><li><strong>RDB (Redis Database):</strong> 快照形式，在一个时间点将数据保存到磁盘。<ul><li>优点: 体积小，恢复快</li><li>缺点: 有可能导致数据的丢失，在创建子进程时候可能会导致主进程的瞬间阻塞</li></ul></li><li><strong>AOF (Append Only File):</strong> 日志形式，记录 Redis 执行的每个写命令。<ul><li>优点：<ul><li>高可靠性：配置为 always 时零数据丢失；everysec 时仅 1 秒丢失。</li><li>易恢复：AOF 是可读的协议格式，便于手动编辑。</li><li>抗损坏：追加式，电源故障仅影响最后命令，易修复。</li><li>后台重写：不中断服务，文件保持紧凑。</li></ul></li><li>缺点：<ul><li>文件大小：比 RDB 大（即使重写后），尤其对相同数据集。</li><li>性能：always 策略下 I&#x2F;O 开销高，恢复慢（需回放所有命令）。</li></ul></li></ul></li><li><strong>混合持久化（Redis 4.0+）</strong>：为了结合 RDB 和 AOF 的优势，Redis 引入了混合持久化；<ul><li>工作方式： 在进行 AOF 重写时，子进程先将内存中的数据以 RDB 格式写入到新 AOF 文件的开头。接着，再将重写期间发生的增量命令以 AOF 格式追加到 RDB 数据的后面。</li><li>优势： 启动时，先加载 RDB 部分（快），再执行 AOF 部分（保证数据最新），兼顾了启动速度和数据完整性。</li></ul></li></ul><h2 id="RDB的持久化过程？"><a href="#RDB的持久化过程？" class="headerlink" title="RDB的持久化过程？"></a>RDB的持久化过程？</h2><blockquote><p>回答重点：</p><ol><li>压缩二进制文件</li><li>子线程操作，创建子线程阻塞主线程</li><li>共享内存，写时复制COW受影响页</li><li>创建临时文件，完成后重命名</li></ol></blockquote><p>RDB 是通过生成一个经过<strong>压缩的二进制文件（.rdb 文件）</strong>，来保存某个时间点的数据库状态（快照）。</p><p>主进程在接收到持久化命令或达到触发条件，会执行<code>fork()</code>操作，<strong>创建子线</strong>程（此时会<strong>阻塞主线程</strong>，父子线程<strong>共享同一内存区域</strong>）；</p><p>在RDB期间，如果主线程有写请求，通过<strong>COW机制</strong>复制<strong>受影响的页</strong>（降低内存开销），从而可以继续处理；</p><p>子线程会将内存数据集写入一个<strong>临时 RDB 文件</strong>（防止意外导致原dump文件损坏），全部写完后子进程调用操作系统的 <code>rename()</code> 将临时文件重命名为正式的RDB文件（如 dump.rdb），子进程退出并通知父进程。</p><h2 id="AOF的执行过程？"><a href="#AOF的执行过程？" class="headerlink" title="AOF的执行过程？"></a>AOF的执行过程？</h2><p>在客户端发送写命令后，主进程会将命令格式化为AOF格式后<strong>追加</strong>到AOF<strong>缓冲区</strong>，根据配置的策略，使用 fsync 系统调用将缓冲区数据刷到磁盘，确保持久性。</p><h2 id="AOF-有哪些策略（fsync-策略）？"><a href="#AOF-有哪些策略（fsync-策略）？" class="headerlink" title="AOF 有哪些策略（fsync 策略）？"></a>AOF 有哪些策略（fsync 策略）？</h2><ul><li><p><strong>always</strong>：每次写命令都进行 fsync 同步(刷盘)。最高可靠性，但性能最低（支持组提交以优化并行写）。</p></li><li><p><strong>everysec</strong>（默认）：每秒进行一次 fsync 同步。高性能，崩溃时最多丢失 1 秒数据。</p></li><li><p><strong>no</strong>：由操作系统决定何时同步。最高性能，但数据丢失风险高。</p></li></ul><h2 id="什么是-AOF-文件重写？"><a href="#什么是-AOF-文件重写？" class="headerlink" title="什么是 AOF 文件重写？"></a>什么是 AOF 文件重写？</h2><p>随着时间推移，AOF 文件会变得越来越大，因为其中包含很多重复的、过期或无效的命令。为了消除冗余命令，会<strong>生成一个新的最小的 AOF 文件来替换原来的AOF文件</strong>，还原当前内存数据库状态。</p><p>重写不是读取旧的 AOF 文件，而是<strong>直接读取内存中的当前数据</strong>，用最少的命令来重建数据。</p><h2 id="AOF-重写执行过程？"><a href="#AOF-重写执行过程？" class="headerlink" title="AOF 重写执行过程？"></a>AOF 重写执行过程？</h2><blockquote><p>回答重点：</p><ol><li>创建子线程，通过数据快照写入新文件</li><li>新命令同时写入两个缓冲区</li><li>AOF缓冲区同步到旧的AOF文件中</li><li>AOF重写缓冲区追加到写完的新AOF文件的末尾</li><li>原子性地替换文件</li></ol></blockquote><p>当触发AOF重写条件时，主进程会<code>fork</code>一个子进程。这时子进程会创建一个新的AOF文件（防止发生意外破坏旧文件）。</p><p>此时主进程继续处理客户端的命令，接收到的新命令会同时写入 AOF缓冲区（主进程用，原来就有）和 AOF重写缓冲区（子进程用），AOF缓冲区的内容会被同步到旧的AOF文件中。</p><p>子进程将数据库快照重写完毕后，会通知主进程然后主进程会将 AOF重写缓冲区 中的所有内容追加到子进程生成的那个临时的新AOF文件的末尾（这样，新AOF文件就包含了重写开始时的内存快照数据 + 重写期间的所有新数据，与当前数据库状态完全一致），然后 原子性地用新的AOF文件替换旧的AOF文件。</p><h2 id="AOF-重写触发条件"><a href="#AOF-重写触发条件" class="headerlink" title="AOF 重写触发条件?"></a>AOF 重写触发条件?</h2><p>同时满足：</p><p><strong>最小触发大小</strong>: 默认值是 64MB</p><p><strong>增长率阈值</strong>: 默认值是 100%</p><h2 id="Key过期后的删除策略？"><a href="#Key过期后的删除策略？" class="headerlink" title="Key过期后的删除策略？"></a>Key过期后的删除策略？</h2><p>Redis 支持三种过期删除策略：定时删除、惰性删除 和 定期删除。这些策略不是互斥的，而是结合使用（默认<strong>惰性 + 定期</strong>）。</p><p>Redis 为每个数据库维护一个额外的字典（<strong>过期时间字典</strong>），避免扫描所有键，全局字典太大，过期时间字典中只含过期键。</p><h2 id="三种删除策略的区别？"><a href="#三种删除策略的区别？" class="headerlink" title="三种删除策略的区别？"></a>三种删除策略的区别？</h2><ul><li><p>定时删除：为每个设置过期时间的 Key 创建一个定时器。时间一到，定时器立即触发删除。</p><ul><li><p>优点：保证 Key 在过期后立即被删除，内存释放及时。</p></li><li><p>缺点：对 CPU不友好，需要大量创建和管理定时器，且在大量 Key 同时过期时，会瞬间占用大量 CPU 资源</p></li></ul></li><li><p>惰性删除：不主动删除过期键，而是在访问键时判断是否过期，如果过期则删除并返回 nil，这是一种被动策略。</p><ul><li><p>优点：节省 CPU 资源，仅在必要时检查，不需要周期性扫描。</p></li><li><p>缺点：如果过期键长期不被访问，会一直占用内存直到内存满（然后依赖淘汰策略）。</p></li></ul></li><li><p><strong>定期删除</strong>：Redis 会周期性地（默认<strong>每秒 10 次</strong>）随机从过期时间字典中抽取一批 Key（默认为 <strong>20 个</strong>），检查并删除已过期的 Key，如果删除的过期 Key 数量超过总抽样 Key 数量的 25%（即 5 个），则认为过期 Key 较多，会再次重复此过程，直到比例<strong>低于 25%</strong> 或达到最大运行时间限制（默认 <strong>25 毫秒</strong>）。</p><ul><li><p>优点：平衡了 CPU 和内存，定期清理，避免惰性删除的内存积累，对主线程阻塞几乎可以忽略。</p></li><li><p>缺点：不能保证立即删除；随机采样，可能遗漏一些键。如果过期键爆发式增加，可能清理不及时，导致内存压力。</p></li></ul></li></ul><h2 id="内存满了之后的淘汰策略？"><a href="#内存满了之后的淘汰策略？" class="headerlink" title="内存满了之后的淘汰策略？"></a>内存满了之后的淘汰策略？</h2><blockquote><p>淘汰范围：</p><ul><li>全部 Key（allkeys-xxx）：从所有键中淘汰，包括永久键。</li><li>过期 Key（volatile-xxx）：仅从设置了过期时间的键中淘汰。</li></ul><p>算法：</p><ul><li><strong>LRU</strong>（Least Recently Used）：最近使用<strong>时间</strong>最远，优先淘汰最久未访问的键。</li><li><strong>LFU</strong>（Least Frequently Used）：最近使用<strong>次数</strong>最少，优先淘汰访问频率最低的键。</li><li>Random：随机淘汰。</li><li>TTL：优先淘汰 TTL 最小的键（即将过期）。</li></ul></blockquote><ul><li><p>不淘汰策略 （默认）：</p><ul><li><code>noeviction</code>：当内存不足时，对于新的写入操作会直接拒绝并返回错误。读取操作仍然正常执行。</li></ul></li><li><p>全 Key 淘汰策略：</p><ul><li><p><code>allkeys-lru</code>：从所有 Key 中，选择最近最少使用的 Key 进行淘汰。</p></li><li><p><code>allkeys-lfu</code>：从所有 Key 中，选择最不经常使用的 Key 进行淘汰。</p></li><li><p><code>allkeys-random</code>：从所有 Key 中，随机选择 Key 进行淘汰。</p></li></ul></li><li><p>过期 Key 淘汰策略：</p><ul><li><code>volatile-lru</code>：从设置了过期时间的 Key 中，选择最近最少使用的 Key 进行淘汰。</li><li><code>volatile-lfu</code>：从设置了过期时间的 Key 中，选择最不经常使用的 Key 进行淘汰。</li><li><code>volatile-random</code>：从设置了过期时间的 Key 中，随机选择 Key 进行淘汰。</li><li><code>volatile-ttl</code>：从设置了过期时间的 Key 中，选择剩余生存时间（TTL）最短的 Key 进行淘汰。</li></ul></li></ul><table><thead><tr><th>策略类型</th><th>范围</th><th>算法</th><th>优点</th><th>缺点</th><th>适用场景</th></tr></thead><tbody><tr><td>noeviction</td><td>-</td><td>-</td><td>数据安全</td><td>写失败</td><td>纯存储，不允许丢失</td></tr><tr><td>allkeys-lru</td><td>所有键</td><td>LRU</td><td>高命中率</td><td>可能删永久键</td><td>纯缓存</td></tr><tr><td>volatile-lru</td><td>过期键</td><td>LRU</td><td>保护永久键</td><td>无过期键时失效</td><td>混合使用（缓存+存储）</td></tr><tr><td>allkeys-lfu</td><td>所有键</td><td>LFU</td><td>频率敏感</td><td>新键易删</td><td>热门项明显的场景</td></tr><tr><td>volatile-lfu</td><td>过期键</td><td>LFU</td><td>保护永久键，频率敏感</td><td>同上</td><td>同上</td></tr><tr><td>allkeys-random</td><td>所有键</td><td>随机</td><td>简单快速</td><td>不智能</td><td>测试或无模式数据</td></tr><tr><td>volatile-random</td><td>过期键</td><td>随机</td><td>保护永久键，简单</td><td>不智能</td><td>同上</td></tr><tr><td>volatile-ttl</td><td>过期键</td><td>TTL</td><td>最小数据丢失</td><td>忽略访问模式</td><td>对过期敏感的场景</td></tr></tbody></table><h2 id="String底层是怎么实现的？"><a href="#String底层是怎么实现的？" class="headerlink" title="String底层是怎么实现的？"></a>String底层是怎么实现的？</h2><ol><li><strong>int编码</strong>: 当存储的是整数, 且可以用long表示时使用</li><li><strong>embstr编码</strong>: 当存储的字符串长度≤44字节时使用</li><li>raw编码(<strong>SDS</strong>): 当字符串长度&gt;44字节时使用</li></ol><h2 id="SDS相比C字符串有什么优势"><a href="#SDS相比C字符串有什么优势" class="headerlink" title="SDS相比C字符串有什么优势?"></a>SDS相比C字符串有什么优势?</h2><ol><li>**O(1)**获取长度 - 有len字段​</li><li><strong>减少内存重分配次数</strong> - 空间预分配和惰性释放​</li><li><strong>二进制安全</strong> - 可存任意数据</li><li>防止缓冲区溢出 - 自动扩容</li></ol><h2 id="Hash什么时候用ziplist-什么时候用hashtable"><a href="#Hash什么时候用ziplist-什么时候用hashtable" class="headerlink" title="Hash什么时候用ziplist, 什么时候用hashtable?"></a>Hash什么时候用ziplist, 什么时候用hashtable?</h2><p>ziplist使用条件(同时满足):</p><ul><li><p>键值对<strong>数量 ≤ 512</strong></p></li><li><p>所有键值<strong>长度 ≤ 64字节</strong></p></li></ul><p>不满足任一条件就转为hashtable</p><h2 id="List为什么不直接用链表或数组"><a href="#List为什么不直接用链表或数组" class="headerlink" title="List为什么不直接用链表或数组?"></a>List为什么不直接用链表或数组?</h2><p>纯链表: 内存不连续,CPU缓存不友好 </p><p>纯数组: 插入删除效率低</p><p>quicklist结合两者优点:</p><ul><li><p>用ziplist保证内存连续性</p></li><li><p>用双向链表保证插入删除效率</p></li></ul><h2 id="set在什么情况下用-intset"><a href="#set在什么情况下用-intset" class="headerlink" title="set在什么情况下用 intset?"></a>set在什么情况下用 intset?</h2><p>Set的所有元素都是<strong>整数</strong>，且<strong>数量≤512</strong>时；</p><p>一旦添加非整数或超过512个,就转为hashtable</p><h2 id="什么是跳表？"><a href="#什么是跳表？" class="headerlink" title="什么是跳表？"></a>什么是跳表？</h2><p>跳表是一个分级别的数据结构, 最底层的那个级别存储了所有的元素, 每往上一层这个数据就会减少；</p><p>在进行数据存储的时候, 先存储在最底层, 然后往上存储, 上一层存储的概率是25%, 每往上一层都会乘以0.25，最高到32层；</p><p>查询的时候是从上往下进行查询, 因为上层的数据比较少, 相对于是索引结构, 可以快速定位到目标数据。</p><h2 id="ZSet为什么要同时用skiplist和dict"><a href="#ZSet为什么要同时用skiplist和dict" class="headerlink" title="ZSet为什么要同时用skiplist和dict?"></a>ZSet为什么要同时用skiplist和dict?</h2><p>skiplist: 提供有序性,支持范围查询ZRANGE</p><p>dict: 提供O(1)的ZSCORE查询快速获取分数</p><p>两个结构配合使用,各取所长，内存通过指针共享,不会浪费</p><h2 id="自己实现的分布式锁有什么问题？Redisson是如何解决这些问题的？"><a href="#自己实现的分布式锁有什么问题？Redisson是如何解决这些问题的？" class="headerlink" title="自己实现的分布式锁有什么问题？Redisson是如何解决这些问题的？"></a>自己实现的分布式锁有什么问题？Redisson是如何解决这些问题的？</h2><p>redis分布式锁的基本原理是<code>SETNX</code>（只有当key在redis中不存在才存储成功，存在则返回失败）</p><table><thead><tr><th>问题</th><th>说明</th><th>解决方案</th></tr></thead><tbody><tr><td>1 死锁</td><td>服务宕机，锁永远不释放</td><td>设置过期时间</td></tr><tr><td>2 误删锁</td><td>删除了别人的锁</td><td>加唯一标识，删除前判断</td></tr><tr><td>3 原子性</td><td>判断和删除不是原子操作</td><td>使用Lua 脚本</td></tr><tr><td>4 锁续期</td><td>业务没执行完锁就过期了</td><td>看门狗机制</td></tr><tr><td>5 可重入</td><td>同一线程获取多次锁</td><td>记录持有者和次数</td></tr></tbody></table><h2 id="Redis如何解决锁自动续期问题？"><a href="#Redis如何解决锁自动续期问题？" class="headerlink" title="Redis如何解决锁自动续期问题？"></a>Redis如何解决锁自动续期问题？</h2><p>通过<strong>看门狗</strong>机制</p><ol><li>默认锁过期时间30秒​</li><li>获取锁成功后，Redisson会启动一个后台线程（看门狗）</li><li>每隔10秒检查一次你的这个锁还在不在，如果不在说明你自己手动释放了</li><li>如果还在，说明   业务还在执行，自动重置30秒</li><li>业务完成后，停止续期</li></ol><p>前提：你在使用Redisson去获取分布式锁的时候<strong>不要去设置过期时间</strong>，如果你自己设置了过期时间，看门狗就失效了</p><h2 id="主从复制的过程？"><a href="#主从复制的过程？" class="headerlink" title="主从复制的过程？"></a>主从复制的过程？</h2><ol><li>Slave节点会主动向Master节点发送同步数据的请求<ul><li>如果是第一次同步 发送的命令是 <code>psync2 ? -1</code>  ?代表的是第一次同步 -1代表的是同步所有数据</li><li>如果不是第一次同步 发送的命令是 psync2 主节点的runid 上一次同步到的偏移量位置 offset</li></ul></li><li>Master节点收到Slave的同步数据请求后 如果是第一次同步 会将自己内存中的数据 生成RDB文件 同时把自己的runid和自己当前复制缓冲区中的偏移量信息都返回给Slave</li><li>Slave收到Master返回的同步数据 然后进行RDB的恢复 同时保存Master的runid和offset</li><li>Slave还会定期向Master发送同步数据的请求 <code>psync2 runid offset</code></li><li>Master接收同步数据请求后会进行判断<ul><li>先判断Slave传递过来的runid 是不是自己的runid<ul><li>如果是自己的runid 再去对比offset</li><li>如果不是自己的runid 会再次进行全量复制</li></ul></li><li>然后判断offset是否在当前的复制缓冲区内<ul><li>如果在就直接从offset的位置开始 返回到最新的数据 同时把最新的offset返回给Slave</li><li>如果不在说明Slave已经长时间没有给Master进行数据同步了 复制缓冲区中的数据已经丢失了部分 会再次触发全量复制</li></ul></li></ul></li><li>定期重复第4步和第5步</li></ol><p><img src="/images/upload/image-20251024183646282.png" alt="image-20251024183646282.png"></p><h2 id="什么情况会触发全量复制？"><a href="#什么情况会触发全量复制？" class="headerlink" title="什么情况会触发全量复制？"></a>什么情况会触发全量复制？</h2><ol><li>第一次同步时</li><li>runid不一致</li><li>offset不在复制缓冲区内</li></ol><h2 id="哪些情况下会导致频繁的全量复制？"><a href="#哪些情况下会导致频繁的全量复制？" class="headerlink" title="哪些情况下会导致频繁的全量复制？"></a>哪些情况下会导致频繁的全量复制？</h2><ol><li>Master重启或故障（run_id变化）</li><li>网络不稳定或中断（偏移量失效）</li><li>复制积压缓冲区过小（写操作覆盖缓冲区）</li><li>Slave重启或新增（无历史偏移量）</li><li>数据量大或写频繁（缓冲区溢出，RDB传输慢）</li><li>配置不当（缓冲区限制低、版本不兼容）</li></ol><h2 id="什么是哨兵模式？"><a href="#什么是哨兵模式？" class="headerlink" title="什么是哨兵模式？"></a>什么是哨兵模式？</h2><p> 如果Master节点发生故障, 哨兵会实现<strong>自动故障转移</strong>, 在Slave中选举出新的Master</p><h2 id="脑裂问题及解决方案？"><a href="#脑裂问题及解决方案？" class="headerlink" title="脑裂问题及解决方案？"></a>脑裂问题及解决方案？</h2><p>在哨兵或集群模式下，主节点与哨兵间网络出现中断，导致在不同网络分区的哨兵错误判断主节点下线而重新选举主节点，待网络恢复后存在两个主节点的情况（两者可同时写入，导致数据不一致）</p><p>解决方案：</p><ol><li>通过配置参数来限制原主节点写入权限（允许写入主节点的最小从节点数量、主从节点最大允许的延迟）</li><li>调整哨兵判断下线时间，增加判断下线所需的哨兵数量</li><li>做好日志监控报警</li></ol><h2 id="缓存击穿、穿透、雪崩问题及解决方案？"><a href="#缓存击穿、穿透、雪崩问题及解决方案？" class="headerlink" title="缓存击穿、穿透、雪崩问题及解决方案？"></a>缓存击穿、穿透、雪崩问题及解决方案？</h2><table><thead><tr><th>问题类型</th><th>核心原因</th><th>解决方案</th></tr></thead><tbody><tr><td>缓存穿透</td><td>请求查询的是<strong>根本不存在的数据</strong>，缓存和数据库都无法命中，大量请求直接穿透到数据库，可能导致数据库过载宕机。</td><td>1. 多级缓存<br />2. 热点key预加载<br />3. 逻辑过期</td></tr><tr><td>缓存击穿</td><td>一个<strong>热点 key</strong>在缓存中过期失效的瞬间，有大量并发请求访问，这些并发请求同时穿透到数据库，造成数据库瞬间压力骤增。</td><td>1. 参数校验<br />2. 布隆过滤器<br />3. 缓存空置</td></tr><tr><td>缓存雪崩</td><td>大量缓存 key 在<strong>同一时间段内集中过期</strong>，或缓存服务本身宕机，所有请求全部穿透到数据库，数据库无法承受压力而宕机，引发连锁反应。</td><td>1. 多级缓存<br />2. 随机过期时间</td></tr></tbody></table><h2 id="缓存一致性（MySQL和Redis）的解决方案？"><a href="#缓存一致性（MySQL和Redis）的解决方案？" class="headerlink" title="缓存一致性（MySQL和Redis）的解决方案？"></a>缓存一致性（MySQL和Redis）的解决方案？</h2><p><strong>Canal监听binlog</strong>：部署Canal工具监听MySQL binlog日志，解析变更事件后异步更新或删除Redis缓存，实现近实时同步。</p><p><strong>读写分离+最终一致性</strong>：读从Redis，写到MySQL后通过MQ（如Kafka）通知消费者更新Redis；结合TTL设置缓存过期，确保最终一致性。</p><p><strong>延时双删</strong>：更新DB后，先删除缓存，业务处理后延迟几秒（如500ms）再删一次缓存，确保读请求在延迟期内加载新数据。可以使用消息队列（如RabbitMQ）实现延迟删除。</p><p><strong>先更新DB，后删除缓存</strong>：写操作时先更新MySQL，再删除对应Redis缓存（而非更新缓存），读时缓存miss则从DB加载。避免脏读，但需处理并发问题。</p>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/redis-interview/</id>
    <link href="https://blog.wangbowei.com/archives/redis-interview/"/>
    <published>2025-09-28T10:33:00.000Z</published>
    <summary>你在开发中都是怎么使用Redis的 ? 我主要使用的是 Redis的缓存和它的分布式锁功能 Redis 为什么快？ 基于内存操作：内存的速度远高于访问磁盘的速度 单线程 + I/O 多路复用：避免了多线程带来的锁竞争、上下文切换的开销。 高效的底层数据结构和编码：使用内存紧凑的 ziplist (压</summary>
    <title>Redis 八股文面试题</title>
    <updated>2026-04-09T15:53:03.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="Java" scheme="https://blog.wangbowei.com/categories/Java/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="JUC" scheme="https://blog.wangbowei.com/tags/JUC/"/>
    <content>
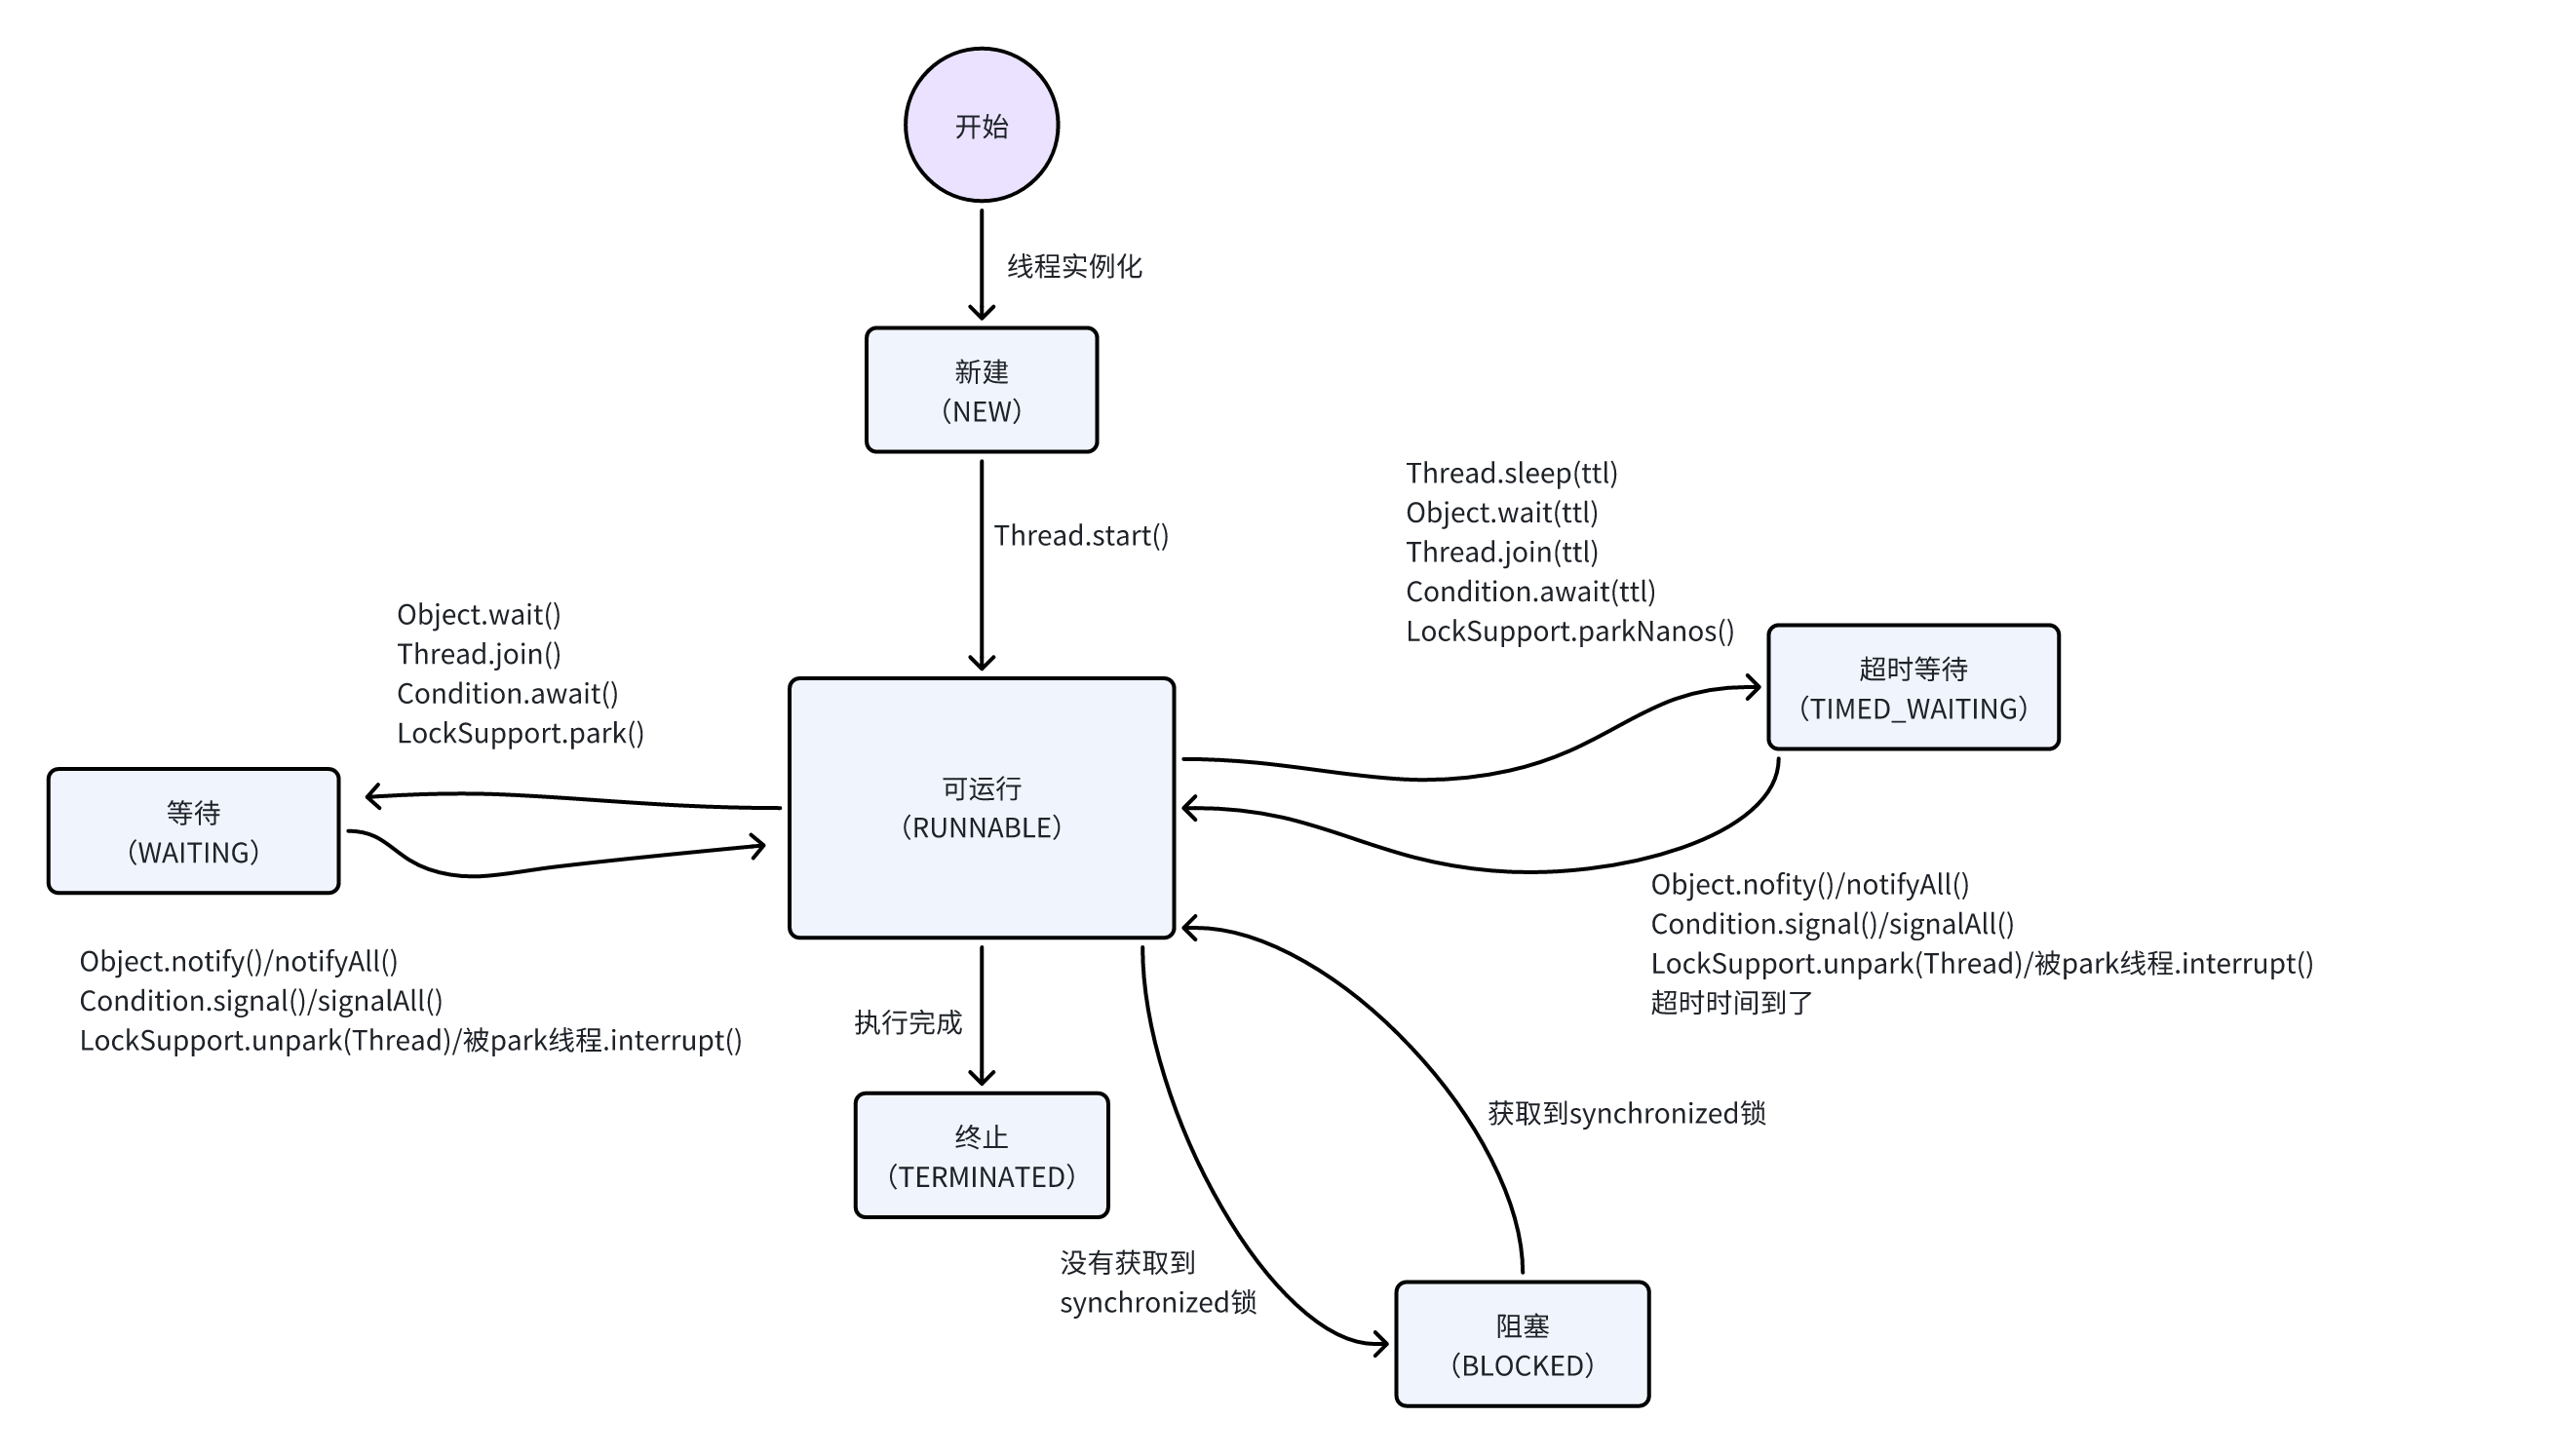
      <![CDATA[<h2 id="谈谈你对线程和进程的理解"><a href="#谈谈你对线程和进程的理解" class="headerlink" title="谈谈你对线程和进程的理解"></a>谈谈你对线程和进程的理解</h2><table><thead><tr><th align="center">进程</th><th align="center">线程</th></tr></thead><tbody><tr><td align="center">操作系统资源分配的基本单位</td><td align="center">CPU 调度的基本单位</td></tr></tbody></table><p>一个进程可包含多个线程</p><h2 id="创建线程有几种方式？分别适用什么场景？"><a href="#创建线程有几种方式？分别适用什么场景？" class="headerlink" title="创建线程有几种方式？分别适用什么场景？"></a>创建线程有几种方式？分别适用什么场景？</h2><ol><li>继承 <strong>Thread 类</strong>，重写run()方法：在无需返回值时使用</li><li>实现 <strong>Runnable 接口</strong>，实现run()方法：在需要返回值时使用</li><li>实现 <strong>Callable 接口</strong> + Future，实现call()方法：在需要抛出异常时使用</li></ol><h2 id="线程有哪些状态？"><a href="#线程有哪些状态？" class="headerlink" title="线程有哪些状态？"></a>线程有哪些状态？</h2><p><strong>新建（New）</strong>：线程刚创建，未调用start()。<br><strong>就绪（Runnable）</strong>：调用start()后，等待 CPU 调度（包含 “运行中” 状态）。<br><strong>阻塞（Blocked）</strong>：等待 synchronized 锁释放时进入。<br><strong>等待（Waiting）</strong>：调用wait()、join()、park()等，需被唤醒（无超时）。<br><strong>超时等待（Timed Waiting）</strong>：调用wait(time)、sleep(time)等，超时后自动唤醒。<br><strong>终止（Terminated）</strong>：run()执行完毕或异常终止。</p><p><img src="/images/upload/image-20251009165542168.png" alt="image-20251009165542168.png"></p><h2 id="什么是线程上下文切换？"><a href="#什么是线程上下文切换？" class="headerlink" title="什么是线程上下文切换？"></a>什么是线程上下文切换？</h2><p>当 CPU 从一个线程切换到另一个线程时，需保存当前线程的状态并加载新线程的状态，这个过程称为上下文切换（CPU将自己的时间片分给不同的的线程来执行任务）</p><p>频繁切换会消耗 CPU 资源，影响性能</p><h2 id="什么是线程安全问题？"><a href="#什么是线程安全问题？" class="headerlink" title="什么是线程安全问题？"></a>什么是线程安全问题？</h2><p>多个线程并发访问共享资源时，因执行顺序不确定（如指令重排、线程调度差异），导致最终结果与预期不符的问题。</p><p>导致线程不安全的原因主要有三个：原子性、可见性、有序性。</p><h2 id="什么是原子性问题？"><a href="#什么是原子性问题？" class="headerlink" title="什么是原子性问题？"></a>什么是原子性问题？</h2><p>原子性指一个或多个操作要么全部执行，要么全部不执行，非原子操作在多线程下可能被打断，导致数据不一致。</p><p>解决方式：加锁</p><h2 id="synchronized的加锁范围有哪些？分别锁的是什么对象？"><a href="#synchronized的加锁范围有哪些？分别锁的是什么对象？" class="headerlink" title="synchronized的加锁范围有哪些？分别锁的是什么对象？"></a>synchronized的加锁范围有哪些？分别锁的是什么对象？</h2><p>修饰实例方法：锁当前对象（this），同一对象的多个同步方法互斥。<br>修饰静态方法：锁当前类的 Class 对象（如Xxx.class），所有实例共享该锁。<br>修饰代码块：锁括号中的对象（如synchronized(obj) { … }），可指定任意对象作为锁。</p><h2 id="什么是死锁问题？如何检测死锁问题？如何避免死锁？"><a href="#什么是死锁问题？如何检测死锁问题？如何避免死锁？" class="headerlink" title="什么是死锁问题？如何检测死锁问题？如何避免死锁？"></a>什么是死锁问题？如何检测死锁问题？如何避免死锁？</h2><ul><li><p>死锁问题：两个或者两个以上的线程持有资源，并且互相等待对方手里资源的这一种现象叫做死锁</p></li><li><p>排查死锁：</p><ol><li>使用jps+jstack命令</li><li>使用arthas</li></ol></li><li><p>避免死锁：</p><ol><li>顺序加锁</li><li>设置锁超时时间</li></ol></li></ul><h2 id="synchronized锁升级是怎么样的？"><a href="#synchronized锁升级是怎么样的？" class="headerlink" title="synchronized锁升级是怎么样的？"></a>synchronized锁升级是怎么样的？</h2><p><strong>无锁</strong>：初始状态，无线程竞争。</p><p><strong>偏向锁</strong>：第一个线程获取锁，记录线程id，此时为偏向锁。</p><p><strong>轻量级锁</strong>：出现多个线程获取锁，但不发生实际竞争时（交替加锁，不在同一时刻竞争同一把锁），升级为轻量级锁。</p><p><strong>重量级锁</strong>：发生实际竞争时，升级为重量级锁。</p><h2 id="什么是悲观锁和乐观锁？都有哪些具体的实现？"><a href="#什么是悲观锁和乐观锁？都有哪些具体的实现？" class="headerlink" title="什么是悲观锁和乐观锁？都有哪些具体的实现？"></a>什么是悲观锁和乐观锁？都有哪些具体的实现？</h2><p>悲观锁：认为竞争必然发生，操作前就先加锁，如synchronized、ReentrantLock。</p><p>乐观锁：认为竞争少，先操作，操作完后进行比较，发生冲突重试，如CAS。</p><h2 id="什么是CAS？底层是基于什么实现的？"><a href="#什么是CAS？底层是基于什么实现的？" class="headerlink" title="什么是CAS？底层是基于什么实现的？"></a>什么是CAS？底层是基于什么实现的？</h2><p>CAS (Compare-And-Swap、比较并且交换) 。</p><p>Java底层实际是调用Unsafe类提供的native方法实现的，底层通过CPU保证原子性。</p><h2 id="什么是ABA问题？如何解决？"><a href="#什么是ABA问题？如何解决？" class="headerlink" title="什么是ABA问题？如何解决？"></a>什么是ABA问题？如何解决？</h2><p>问题：变量值从 A→B→A，CAS 会误认为值未变，导致错误更新。</p><p>解决：引入版本号，更新时版本号+1</p><h2 id="什么是可见性问题？怎么能解决可见性问题？"><a href="#什么是可见性问题？怎么能解决可见性问题？" class="headerlink" title="什么是可见性问题？怎么能解决可见性问题？"></a>什么是可见性问题？怎么能解决可见性问题？</h2><p>问题：一个线程修改共享变量后，其他线程不能立即看到最新值</p><p>解决：</p><ol><li>对变量加<code>volatile</code>修饰</li><li>加<code>synchronized</code>锁</li></ol><h2 id="什么是有序性问题？怎么能解决有序性问题？"><a href="#什么是有序性问题？怎么能解决有序性问题？" class="headerlink" title="什么是有序性问题？怎么能解决有序性问题？"></a>什么是有序性问题？怎么能解决有序性问题？</h2><p>问题：因指令重排导致的程序执行顺序与代码顺序不一致，进而导致多线程逻辑错误</p><p>解决：</p><ol><li>对变量加<code>volatile</code>修饰</li><li>加<code>synchronized</code>锁</li></ol><h2 id="volatile如何保证可见性以及有序性？能保证原子性吗？"><a href="#volatile如何保证可见性以及有序性？能保证原子性吗？" class="headerlink" title="volatile如何保证可见性以及有序性？能保证原子性吗？"></a>volatile如何保证可见性以及有序性？能保证原子性吗？</h2><p><code>volatile</code>通过<strong>内存屏障</strong>保证可见性和有序性，但不能保证原子性，原子性可以通过加锁保证。</p><h2 id="volatile和synchronized有什么区别？"><a href="#volatile和synchronized有什么区别？" class="headerlink" title="volatile和synchronized有什么区别？"></a>volatile和synchronized有什么区别？</h2><ul><li><p>volatile：</p><ol><li>可以保证可见性和有序性，但不能保证原子性；</li><li>加在变量上；</li><li>性能开销影响较小。</li></ol></li><li><p>synchronized：</p><ol><li>可见性、有序性、原子性都能保证；</li><li>加在方法或代码块上；</li><li>性能开销影响大。</li></ol></li></ul><h2 id="sleep-long-n-和-wait-long-n-有什么区别？"><a href="#sleep-long-n-和-wait-long-n-有什么区别？" class="headerlink" title="sleep(long n) 和 wait(long n) 有什么区别？"></a>sleep(long n) 和 wait(long n) 有什么区别？</h2><table><thead><tr><th align="left">特性</th><th align="left">sleep(long n)</th><th align="left">wait(long n)</th></tr></thead><tbody><tr><td align="left">所属类</td><td align="left">Thread</td><td align="left">Object</td></tr><tr><td align="left">锁释放</td><td align="left">不释放锁</td><td align="left">释放锁</td></tr><tr><td align="left">唤醒方式</td><td align="left">超时自动唤醒</td><td align="left">超时或被 notify 唤醒</td></tr><tr><td align="left">使用场景</td><td align="left">暂停执行（如定时）</td><td align="left">线程间等待通知</td></tr></tbody></table><h2 id="如何创建线程池？线程池的7个参数分别是什么，作用分别是什么？"><a href="#如何创建线程池？线程池的7个参数分别是什么，作用分别是什么？" class="headerlink" title="如何创建线程池？线程池的7个参数分别是什么，作用分别是什么？"></a>如何创建线程池？线程池的7个参数分别是什么，作用分别是什么？</h2><p>通过<code>ThreadPoolExecutor</code>构造函数创建，核心参数：</p><ol><li><strong>corePoolSize</strong>：核心线程数（长期存活，即使空闲）。</li><li><strong>maximumPoolSize</strong>：最大线程数（核心 + 非核心线程的上限）。</li><li><strong>keepAliveTime</strong>：非核心线程的空闲存活时间。</li><li><strong>unit</strong>：<code>keepAliveTime</code>的时间单位（如<code>TimeUnit.SECONDS</code>）。</li><li><strong>workQueue</strong>：任务等待队列（核心线程满时存放任务）。</li><li><strong>threadFactory</strong>：创建线程的工厂（可自定义线程名、优先级等）。</li><li><strong>handler</strong>：拒绝策略（任务满时如何处理新任务）。</li></ol><h2 id="为什么不推荐使用-Executors-工具类创建线程池？"><a href="#为什么不推荐使用-Executors-工具类创建线程池？" class="headerlink" title="为什么不推荐使用 Executors 工具类创建线程池？"></a>为什么不推荐使用 Executors 工具类创建线程池？</h2><p>都会导致OOM</p><p>（<code>FixedThreadPool</code>&#x2F;<code>SingleThreadPool</code>：使用无界队列（<code>LinkedBlockingQueue</code>）；<code>CachedThreadPool</code>：最大线程数为<code>Integer.MAX_VALUE</code>）</p><h2 id="任务提交到线程池后，执行流程是怎么样的？"><a href="#任务提交到线程池后，执行流程是怎么样的？" class="headerlink" title="任务提交到线程池后，执行流程是怎么样的？"></a>任务提交到线程池后，执行流程是怎么样的？</h2><ol><li>提交任务，若核心线程数未满，创建<strong>核心线程</strong>执行任务。</li><li>核心线程满，任务加入<strong>等待队列</strong>。</li><li>等待队列满，若未达最大线程数，创建<strong>非核心线程</strong>执行任务。</li><li>达到最大线程数，执行<strong>拒绝策略</strong>。</li></ol><h2 id="线程池的拒绝策略有哪些，默认是哪一种？"><a href="#线程池的拒绝策略有哪些，默认是哪一种？" class="headerlink" title="线程池的拒绝策略有哪些，默认是哪一种？"></a>线程池的拒绝策略有哪些，默认是哪一种？</h2><p>直接抛异常（默认）    &#x2F;    直接丢弃    &#x2F;    丢弃最老的任务    &#x2F;    交由提交任务的线程执行</p><ul><li><strong>AbortPolicy</strong>（默认）：抛<code>RejectedExecutionException</code>异常。</li><li><strong>CallerRunsPolicy</strong>：让提交任务的线程自己执行（减缓提交速度，适用于轻量任务）。</li><li><strong>DiscardPolicy</strong>：直接丢弃新任务（无提示）。</li><li><strong>DiscardOldestPolicy</strong>：丢弃队列中最旧的任务，再尝试提交新任务。</li></ul><h2 id="ThreadLocalMap是什么？其Key和Value分别是什么？"><a href="#ThreadLocalMap是什么？其Key和Value分别是什么？" class="headerlink" title="ThreadLocalMap是什么？其Key和Value分别是什么？"></a>ThreadLocalMap是什么？其Key和Value分别是什么？</h2><p><code>ThreadLocal</code>的静态内部类，类似 HashMap（但结构更简单），用于存储线程本地变量。</p><ul><li><strong>Key</strong>：<code>ThreadLocal</code>对象（弱引用，避免 ThreadLocal 对象未被引用时的内存泄漏）。</li><li><strong>Value</strong>：线程私有变量（强引用）。</li></ul><h2 id="为什么执行了ThreadLocal的set方法后要执行remove方法？不执行会有什么后果吗？"><a href="#为什么执行了ThreadLocal的set方法后要执行remove方法？不执行会有什么后果吗？" class="headerlink" title="为什么执行了ThreadLocal的set方法后要执行remove方法？不执行会有什么后果吗？"></a>为什么执行了ThreadLocal的set方法后要执行remove方法？不执行会有什么后果吗？</h2><p>ThreadLocalMap 的 Key（ThreadLocal 对象）被设计为<strong>弱引用</strong>，当该 ThreadLocal 对象失去所有外部强引用后，垃圾回收时会回收 Key。此时 Key 变为 null，但对应的 Value 因被 Entry <strong>强引用</strong>而无法释放。若线程长期存活（如线程池场景）且未主动调用 remove() 清理，残留的 Value 会持续累积，最终导致内存泄漏甚至<strong>内存溢出</strong>（OOM）</p><h2 id="什么是AQS？有哪三个核心？"><a href="#什么是AQS？有哪三个核心？" class="headerlink" title="什么是AQS？有哪三个核心？"></a>什么是AQS？有哪三个核心？</h2><p>AQS（AbstractQueuedSynchronizer）：抽象队列同步器，是 Java 并发工具（如 ReentrantLock、Semaphore）的基础框架。</p><p>核心：state变量，CLH队列（双向链表，先进先出），CAS操作</p><h2 id="ReentrantLock-锁和-synchronized-锁有什么区别？"><a href="#ReentrantLock-锁和-synchronized-锁有什么区别？" class="headerlink" title="ReentrantLock 锁和 synchronized 锁有什么区别？"></a>ReentrantLock 锁和 synchronized 锁有什么区别？</h2><p>synchronized 是JVM级别的锁，但是 ReentrantLock 是Java 层面的锁（底层是基于AQS实现的）</p><p><strong>中公超多</strong></p><table><thead><tr><th></th><th>ReentrantLock</th><th>synchronized</th></tr></thead><tbody><tr><td><strong>中</strong>断</td><td>可中断</td><td>不可中断</td></tr><tr><td><strong>公</strong>平</td><td>支持公平和非公平</td><td>只有非公平</td></tr><tr><td><strong>超</strong>时</td><td>指定时间未获取到锁就不继续获取</td><td>一直等待</td></tr><tr><td><strong>多</strong>个条件变量</td><td>有多个waitSet</td><td>只有一个waitSet</td></tr></tbody></table><h2 id="Semaphore有什么特点？适用于什么场景？底层是怎么实现的？"><a href="#Semaphore有什么特点？适用于什么场景？底层是怎么实现的？" class="headerlink" title="Semaphore有什么特点？适用于什么场景？底层是怎么实现的？"></a>Semaphore有什么特点？适用于什么场景？底层是怎么实现的？</h2><ul><li><strong>特点</strong>：控制同时访问资源的线程数（基于 “许可” 机制）。</li><li><strong>场景</strong>：限流（如限制并发请求数）、资源池控制（如限制数据库连接数）。</li><li><strong>底层实现</strong>：基于 AQS（state 表示可用许可数。<code>acquire()</code>减少许可，<code>release()</code>增加许可）</li></ul><h2 id="CountdownLatch有什么特点？适用于什么场景？底层是怎么实现的？"><a href="#CountdownLatch有什么特点？适用于什么场景？底层是怎么实现的？" class="headerlink" title="CountdownLatch有什么特点？适用于什么场景？底层是怎么实现的？"></a>CountdownLatch有什么特点？适用于什么场景？底层是怎么实现的？</h2><ul><li><strong>特点</strong>：让主线程等待多个子线程完成后再执行（倒计时门闩）。</li><li><strong>场景</strong>：线程同步协作，主线程等待所有任务线程初始化完成后再开始工作。</li><li><strong>底层实现</strong>：基于 AQS（state 为初始计数。子线程调用<code>countDown()</code>减 1，主线程调用<code>await()</code>等待 state&#x3D;0）</li></ul><h2 id="CyclicBarrier有什么特点？适用于什么场景？"><a href="#CyclicBarrier有什么特点？适用于什么场景？" class="headerlink" title="CyclicBarrier有什么特点？适用于什么场景？"></a>CyclicBarrier有什么特点？适用于什么场景？</h2><ul><li><strong>特点</strong>：让多个线程到达 “屏障点” 后再一起继续执行（可重用）。</li><li><strong>场景</strong>：分阶段任务（如多线程分块处理数据，所有线程完成后再汇总）。</li></ul>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/juc-interview/</id>
    <link href="https://blog.wangbowei.com/archives/juc-interview/"/>
    <published>2025-09-25T12:41:00.000Z</published>
    <summary>谈谈你对线程和进程的理解 进程 线程 操作系统资源分配的基本单位 CPU 调度的基本单位 一个进程可包含多个线程 创建线程有几种方式？分别适用什么场景？ 继承 Thread 类，重写run()方法：在无需返回值时使用 实现 Runnable 接口，实现run()方法：在需要返回值时使用 实现 Cal</summary>
    <title>JUC 八股文面试题</title>
    <updated>2026-04-09T16:24:17.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="Java" scheme="https://blog.wangbowei.com/categories/Java/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="JVM" scheme="https://blog.wangbowei.com/tags/JVM/"/>
    <content>
      <![CDATA[<h2 id="Java如何实现跨平台？"><a href="#Java如何实现跨平台？" class="headerlink" title="Java如何实现跨平台？"></a>Java如何实现跨平台？</h2><p>不直接跑在操作系统上，而是跑在 JVM 上。</p><h2 id="JDK和JRE有什么区别？"><a href="#JDK和JRE有什么区别？" class="headerlink" title="JDK和JRE有什么区别？"></a>JDK和JRE有什么区别？</h2><ul><li>**JRE（Java Runtime Environment）**Java 程序的运行环境：只有JVM+核心类库（如 <em>java.lang.*、java.util.*</em>）</li><li>**JDK（Java Development Kit）**Java 开发工具包：JRE+开发工具（编译器（javac）、打包工具（jar）、诊断工具（jconsole、jmap、jstack 等））</li></ul><h2 id="类的加载流程是怎样的？"><a href="#类的加载流程是怎样的？" class="headerlink" title="类的加载流程是怎样的？"></a>类的加载流程是怎样的？</h2><ol><li><strong>加载</strong>：从磁盘本地文件加载到JVM内存</li><li>链接<ul><li><strong>验证</strong>：检查字节码是否符合JVM规范</li><li><strong>准备</strong>：为静态变量赋默认值（数值型为0，布尔为false，引用为null）</li><li><strong>解析</strong>：将符号引用替换为直接引用（内存地址）</li></ul></li><li><strong>初始化</strong>：执行静态代码块</li><li>使用</li><li>卸载</li></ol><h2 id="有哪几种类加载器？"><a href="#有哪几种类加载器？" class="headerlink" title="有哪几种类加载器？"></a>有哪几种类加载器？</h2><ol><li><strong>启动类加载器</strong>（Bootstrap ClassLoader）：负责加载核心类库（如<em>java.lang.*、java.util.*</em>）</li><li><strong>扩展类加载器</strong>（Extension ClassLoader）：负责加载 扩展目录（$JAVA_HOME&#x2F;lib&#x2F;ext） 下的类库</li><li><strong>应用类加载器</strong>（Application ClassLoader）：负责加载 classpath 下的类（我们自己写的代码、第三方依赖）</li><li><strong>自定义类加载器</strong>（Custom ClassLoader）：开发者可自己继承 ClassLoader，实现特殊的加载逻辑</li></ol><h2 id="什么是双亲委派机制？"><a href="#什么是双亲委派机制？" class="headerlink" title="什么是双亲委派机制？"></a>什么是双亲委派机制？</h2><p>类加载后由下<strong>向上请求</strong>，由上<strong>向下加载</strong>，这种方式主要是为了<strong>保证核心类库的安全</strong>，同时<strong>避免重复加载</strong>同一个类；</p><p>当一个类加载器（ClassLoader）收到“加载某个类”的请求时，它不会自己立刻去加载，而是先把请求交给它的“父加载器”去尝试。如果父加载器能找到并加载，就用父加载器的结果。如果父加载器找不到，才由自己来加载。</p><h2 id="为什么有时候要打破双亲委派？"><a href="#为什么有时候要打破双亲委派？" class="headerlink" title="为什么有时候要打破双亲委派？"></a>为什么有时候要打破双亲委派？</h2><p>比如在 Tomcat 或者 SPI 这种场景下，因为父加载器加载不到我们应用里的类，或者我们需要<strong>不同Web 应用要有自己独立的类空间</strong>（避免类冲突），这时候就需要自定义类加载器，不走默认的委派规则。</p><h2 id="如何打破双亲委派？"><a href="#如何打破双亲委派？" class="headerlink" title="如何打破双亲委派？"></a>如何打破双亲委派？</h2><p>比如Tomcat主要通过WebAppClassLoader<strong>重写loadClass方法</strong>，优先加载当前应用类，仅对核心类委托父类加载的方式，打破了双亲委派的“父类优先”原则，满足了Web容器的特殊需求</p><h2 id="如何判断两个class对象是否相同"><a href="#如何判断两个class对象是否相同" class="headerlink" title="如何判断两个class对象是否相同"></a>如何判断两个class对象是否相同</h2><ol><li>类的<strong>完整类名</strong>必须一致，包括包名</li><li>加载这个类的ClassLoader（指<strong>ClassLoader实例对象</strong>）必须相同</li></ol><h2 id="JVM-内存结构（运行时数据区）有哪些？"><a href="#JVM-内存结构（运行时数据区）有哪些？" class="headerlink" title="JVM 内存结构（运行时数据区）有哪些？"></a>JVM 内存结构（运行时数据区）有哪些？</h2><ol><li><strong>堆</strong>：存放几乎所有对象实例和数组</li><li><strong>虚拟机栈</strong>：每个线程执行 Java 方法时都会创建一个栈帧，用来存储局部变量、操作数栈、返回地址等</li><li><strong>方法区</strong>：存储类的结构信息（类元数据）、静态变量、常量池、方法字节码等，JDK8前叫永久代（堆内存），JDK8之后改叫元空间（本地内存）</li><li><strong>程序计数器</strong>：记录当前线程正在执行的字节码指令地址</li><li><strong>本地方法栈</strong>：为 JVM 调用本地（Native）方法服务</li></ol><h2 id="栈帧是什么，里面有哪些东西？"><a href="#栈帧是什么，里面有哪些东西？" class="headerlink" title="栈帧是什么，里面有哪些东西？"></a>栈帧是什么，里面有哪些东西？</h2><p>虚拟机栈是由一系列 <strong>栈帧（Stack Frame）</strong> 组成的，每次调用一个方法，就会在栈里压入一个新的栈帧；方法执行完毕，就会弹出对应的栈帧</p><ol><li><strong>局部变量表（Local Variables）</strong>：存放方法的参数和方法体内定义的局部变量</li><li><strong>操作数栈（Operand Stack）</strong>：用于方法执行中的各种运算（加减乘除）、临时存放数据、方法返回值</li><li><strong>动态链接（Dynamic Linking）</strong>：存放指向运行时常量池的引用，用于支持将符号引用 →转为直接引用</li><li><strong>方法出口（Return Address）</strong>：记录方法调用后返回的位置</li></ol><h2 id="常见的垃圾回收算法以及他们的优劣势？"><a href="#常见的垃圾回收算法以及他们的优劣势？" class="headerlink" title="常见的垃圾回收算法以及他们的优劣势？"></a>常见的垃圾回收算法以及他们的优劣势？</h2><ol><li><strong>标记-清除</strong>：从 GC Roots 出发，标记所有存活的对象，清理掉没有被标记的对象（垃圾）<ul><li>优点：实现简单，不需要额外内存</li><li>缺点：会产生大量内存碎片</li></ul></li><li><strong>标记-整理</strong>：先标记存活对象，把所有存活对象往一端移动，然后清理边界以外的垃圾<ul><li>优点：没有内存碎片</li><li>缺点：移动对象时需要调整引用，成本高</li></ul></li><li><strong>复制算法</strong>：将内存分为两块，只使用一块，GC时将存活对象复制到另一块<ul><li>优点：没有内存碎片，复制效率高</li><li>缺点：会浪费一半内存</li></ul></li><li><strong>分代收集</strong>：新生代使用复制算法，老年代使用标记-清除&#x2F;标记-整理算法<ul><li>优点：结合各算法优势，提高效率</li><li>缺点：需要分区管理，增加实现复杂度</li></ul></li></ol><h2 id="怎么判断一个对象是不是垃圾？"><a href="#怎么判断一个对象是不是垃圾？" class="headerlink" title="怎么判断一个对象是不是垃圾？"></a>怎么判断一个对象是不是垃圾？</h2><ol><li><strong>引用计数法</strong>：每个对象维护一个“引用计数器”，有一个地方引用它时 +1，引用失效时 -1；当计数器 &#x3D; 0，就认为对象可以回收。<ul><li>优点：实现简单，判断效率高</li><li>缺点：存在<strong>循环引用</strong>的问题</li></ul></li><li><strong>可达性分析算法</strong>：从一组 <strong>GC Roots</strong>（栈、静态变量、常量池、本地方法引用）出发，沿引用链往下找，能找到的对象存活（可达），找不到的就是垃圾（不可达）<ul><li>优点：解决了循环引用的问题</li></ul></li></ol><h2 id="GC-Roots有哪些？"><a href="#GC-Roots有哪些？" class="headerlink" title="GC Roots有哪些？"></a>GC Roots有哪些？</h2><ol><li>线程<strong>栈里的</strong>局部变量（方法里 new 的对象）</li><li>类的<strong>静态变量</strong></li><li>本地方法（JNI）里引用的对象</li></ol><h2 id="有哪些引用类型？"><a href="#有哪些引用类型？" class="headerlink" title="有哪些引用类型？"></a>有哪些引用类型？</h2><ol><li><strong>强引用</strong>：GC 永远不会回收它（<strong>对象一定存活</strong>）</li><li><strong>软引用</strong>：GC 会根据内存情况决定是否回收软引用对象（<strong>内存紧张才回收</strong>）</li><li><strong>弱引用</strong>：GC 一发现弱引用对象就会回收，不管内存是否够用（<strong>一遇 GC 就回收</strong>）</li><li><strong>虚引用</strong>：不能通过虚引用获取对象（get() 永远返回 null）（<strong>可以看作已经回收了</strong>）</li></ol><h2 id="什么情况对象从新生代进入老年代？"><a href="#什么情况对象从新生代进入老年代？" class="headerlink" title="什么情况对象从新生代进入老年代？"></a>什么情况对象从新生代进入老年代？</h2><ol><li>存活<strong>年龄达到阈值</strong>（默认15）</li><li><strong>大对象</strong>直接进入老年代（可通过参数控制）</li><li><strong>survivor区空间不足</strong>放不下</li><li><strong>动态年龄判断</strong>，同龄对象占空间超过一半，则小于等于该年龄的对象都会提前进入老年代</li></ol><h2 id="内存泄漏与内存溢出的区别？"><a href="#内存泄漏与内存溢出的区别？" class="headerlink" title="内存泄漏与内存溢出的区别？"></a>内存泄漏与内存溢出的区别？</h2><ul><li>内存泄露：无用对象太多，无法被GC回收，导致内存被垃圾占满了，等于是占着茅坑不拉屎（如ThreadLocal没有remove()）</li><li>内存溢出：有用对象太多，内存被用完了，属于是茅坑被占满了，没位置了（如递归没有控制边界）</li></ul><h2 id="G1为什么支持大内存回收低延迟的？"><a href="#G1为什么支持大内存回收低延迟的？" class="headerlink" title="G1为什么支持大内存回收低延迟的？"></a>G1为什么支持大内存回收低延迟的？</h2><p>因为G1把堆划分成多个独立的小区域（Region），采用<strong>按 Region 回收 + 并行 + 并发标记 + 按收益优先回收</strong>的方式，实现了可预测的停顿时间控制。</p><h2 id="什么情况触发Full-GC？"><a href="#什么情况触发Full-GC？" class="headerlink" title="什么情况触发Full GC？"></a>什么情况触发Full GC？</h2><ul><li>老年代空间不足 + Major GC 失败</li><li>方法区&#x2F;元空间溢出</li><li>System.gc() 调用</li><li>大对象晋升失败</li><li>空间担保机制</li></ul><h2 id="空间分配担保机制是什么？"><a href="#空间分配担保机制是什么？" class="headerlink" title="空间分配担保机制是什么？"></a>空间分配担保机制是什么？</h2><p>空间担保机制指的是在触发 Minor GC 前，JVM 会先检查老年代的可用空间是否足够存放新生代中可能晋升的对象，如果不够，就提前触发一次 Full GC 来“担保”空间安全，避免内存溢出。</p><h2 id="cms的垃圾回收流程？"><a href="#cms的垃圾回收流程？" class="headerlink" title="cms的垃圾回收流程？"></a>cms的垃圾回收流程？</h2><ol><li><strong>初始标记</strong>：标记 GC Roots 能<strong>直接关联</strong>到的对象，需要STW</li><li><strong>并发标记</strong>：从初始标记的对象出发，并发地遍历整个对象图，找到<strong>所有可达</strong>对象</li><li><strong>重新标记</strong>：修正并发标记期间因为用户线程运行而导致的<strong>标记遗漏</strong>，需要STW</li><li><strong>并发清除</strong>：清除掉未被标记的垃圾对象，释放空间，可能产生内存碎片</li></ol><h2 id="cms垃圾回收哪几步需要stw？"><a href="#cms垃圾回收哪几步需要stw？" class="headerlink" title="cms垃圾回收哪几步需要stw？"></a>cms垃圾回收哪几步需要stw？</h2><p><strong>初始标记</strong>和<strong>重新标记</strong></p><h2 id="字符串实现1-8和1-9的区别？"><a href="#字符串实现1-8和1-9的区别？" class="headerlink" title="字符串实现1.8和1.9的区别？"></a>字符串实现1.8和1.9的区别？</h2><p>1.8使用字符数组char[]，1.9使用字符数组byte[]</p>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/jvm-interview/</id>
    <link href="https://blog.wangbowei.com/archives/jvm-interview/"/>
    <published>2025-09-18T10:21:00.000Z</published>
    <summary>Java如何实现跨平台？ 不直接跑在操作系统上，而是跑在 JVM 上。 JDK和JRE有什么区别？ **JRE（Java Runtime Environment）**Java 程序的运行环境：只有JVM+核心类库（如 java.lang.*、java.util.*） **JDK（Java Devel</summary>
    <title>JVM 八股文面试题</title>
    <updated>2026-04-09T15:59:47.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="数据库" scheme="https://blog.wangbowei.com/categories/%E6%95%B0%E6%8D%AE%E5%BA%93/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <category term="MySQL" scheme="https://blog.wangbowei.com/tags/MySQL/"/>
    <content>
      <![CDATA[<h2 id="常用的连接池有哪些，他们有什么区别"><a href="#常用的连接池有哪些，他们有什么区别" class="headerlink" title="常用的连接池有哪些，他们有什么区别"></a>常用的连接池有哪些，他们有什么区别</h2><p><strong>HikariCP</strong>：最轻量、最快，Spring Boot 默认，推荐优先使用</p><p><strong>Druid</strong>：阿里巴巴开源，性能稍逊，但功能丰富，尤其是监控、统计、SQL 防注入，适合对 <strong>安全性和运维监控</strong> 要求高的项目（牺牲少量性能换取了监控功能）</p><p><strong>C3P0 &#x2F; DBCP</strong>：曾经流行，现在基本不推荐用，除非是老项目</p><p><img src="/images/upload/image-20251012163450351.png" alt="image-20251012163450351.png"></p><h2 id="sql的执行流程简单说一下"><a href="#sql的执行流程简单说一下" class="headerlink" title="sql的执行流程简单说一下"></a>sql的执行流程简单说一下</h2><ol><li><strong>连接器</strong>：MySQL内部的连接池</li><li><strong>查询解析器</strong>：将SQL语句解析成语法树（类似于编译器）</li><li><strong>预处理器</strong>：预处理检查表&#x2F;列是否存在，是否有权限，并将表别名解析为表名</li><li><strong>查询优化器</strong>：将解析后的SQL转换为执行计划，决定走不走索引，走哪个索引，表连接顺序</li><li><strong>执行器</strong>：根据优化器生成的执行计划，调用存储引擎 API，逐步取出数据并返回给客户端</li></ol><p><img src="/images/upload/image-20251012163629865.png" alt="image-20251012163629865.png"></p><h2 id="常用的存储引擎和区别说一下"><a href="#常用的存储引擎和区别说一下" class="headerlink" title="常用的存储引擎和区别说一下"></a>常用的存储引擎和区别说一下</h2><p><strong>MEMORY</strong>：将数据存储在<strong>内存</strong>中，用于高速读写操作，数据在服务器重启或表被重建时会丢失</p><p><strong>MyISAM</strong>：不支持事务、外键、行级锁，只支持表级锁，采用<strong>非聚簇索引</strong>，会存储表的<strong>总行数</strong></p><p><strong>InnoDb</strong>：支持<strong>事务</strong>、<strong>外键</strong>、<strong>行级锁</strong>，也支持表级锁，采用聚簇索引和非聚簇索引，但不会存储表的总行数</p><h2 id="什么是mysql的索引，索引的底层结构是什么"><a href="#什么是mysql的索引，索引的底层结构是什么" class="headerlink" title="什么是mysql的索引，索引的底层结构是什么"></a>什么是mysql的索引，索引的底层结构是什么</h2><p>索引是帮助MySQL高效获取数据的<strong>排好序的数据结构</strong>，底层数据结构是b+树</p><h2 id="mysql页是什么？"><a href="#mysql页是什么？" class="headerlink" title="mysql页是什么？"></a>mysql页是什么？</h2><p>InnoDB 存储的最小单位是 <strong>页（Page）</strong>，默认大小 16KB</p><h2 id="索引是什么意思？"><a href="#索引是什么意思？" class="headerlink" title="索引是什么意思？"></a>索引是什么意思？</h2><p>是帮助MySQL高效获取数据的<strong>排好序的数据结构</strong></p><h2 id="b-树和b树有什么区别？"><a href="#b-树和b树有什么区别？" class="headerlink" title="b+树和b树有什么区别？"></a>b+树和b树有什么区别？</h2><p>b树所有节点都存储数据，b+树只有叶子节点存储数据，可以保证树高只有2~4层，提高查询速度；并且MySQL的b+树叶子节点使用双向链表连接，提高范围查询速度</p><h2 id="mysql有哪些索引？"><a href="#mysql有哪些索引？" class="headerlink" title="mysql有哪些索引？"></a>mysql有哪些索引？</h2><p>数据结构角度：B+树索引、Hash索引、全文索引</p><p>物理存储角度：聚簇索引、非聚簇索引</p><p>索引类型：主键索引、唯一索引、普通索引、联合索引、全文索引</p><h2 id="聚簇索引是什么意思？"><a href="#聚簇索引是什么意思？" class="headerlink" title="聚簇索引是什么意思？"></a>聚簇索引是什么意思？</h2><p>索引结构包含所有数据的索引，InnoDB中的主键索引就属于聚簇索引。</p><h2 id="回表是什么意思？"><a href="#回表是什么意思？" class="headerlink" title="回表是什么意思？"></a>回表是什么意思？</h2><p>在使用非聚簇索引时，为了取到具体数据，则需要通过PK(主键索引)回到聚集索引里去查询数据。这个就叫回表查询。扫描了2次索引树。所以效率相对较低。</p><h2 id="索引覆盖是什么？"><a href="#索引覆盖是什么？" class="headerlink" title="索引覆盖是什么？"></a>索引覆盖是什么？</h2><p>当一次 SQL 查询所需的所有列，<strong>都能从索引中直接获取</strong>，而不用回表到数据页（表里）取数据时，这个查询就叫做覆盖索引查询。</p><h2 id="索引下推是什么？"><a href="#索引下推是什么？" class="headerlink" title="索引下推是什么？"></a>索引下推是什么？</h2><p>索引下推是 MySQL <strong>5.6 引入的一种优化技术</strong>，在 <strong>存储引擎层</strong> 就提前利用索引里已有的字段来判断 WHERE 条件，筛掉不满足的记录，<strong>减少回表次数</strong></p><h2 id="索引为什么不能过多？"><a href="#索引为什么不能过多？" class="headerlink" title="索引为什么不能过多？"></a>索引为什么不能过多？</h2><ol><li>写操作开销增大，需要维护索引</li><li>占用存储空间</li><li>优化器选择困难</li></ol><h2 id="主键索引为什么建议用自增id"><a href="#主键索引为什么建议用自增id" class="headerlink" title="主键索引为什么建议用自增id"></a>主键索引为什么建议用自增id</h2><p>为了<strong>避免页分裂</strong>。</p><p>因为主键id存储了全量数据，会导致每页存储数据少而页很多，从中间插入时需要改变的页也会更多。</p><h2 id="什么是页分裂？"><a href="#什么是页分裂？" class="headerlink" title="什么是页分裂？"></a>什么是页分裂？</h2><p><strong>B+Tree 的页满了</strong>，又要在中间插入新记录时，MySQL 会：</p><ol><li>把原页拆成两个页；</li><li>移动部分数据到新页；</li><li>更新上层索引指针。</li></ol><p>问题：<strong>写入性能下降</strong>（涉及大量内存和磁盘操作）。</p><h2 id="最左前缀原则是什么？"><a href="#最左前缀原则是什么？" class="headerlink" title="最左前缀原则是什么？"></a>最左前缀原则是什么？</h2><p>只要<strong>查询条件从联合索引的最左边列开始</strong>，且各列在条件中连续出现（顺序可以颠倒），MySQL 就能把索引利用到。一旦跳过了某一列，右边所有列都无法再走索引。</p><p><strong>“带头不能少，中间不能断，范围后面全完蛋。”</strong></p><h2 id="什么是索引合并？"><a href="#什么是索引合并？" class="headerlink" title="什么是索引合并？"></a>什么是索引合并？</h2><p>当一个查询条件涉及多个不同索引时，MySQL 优化器可以 <strong>同时使用多个索引</strong>，再把结果集 <strong>合并</strong>，从而避免全表扫描。</p><h2 id="什么是事务？"><a href="#什么是事务？" class="headerlink" title="什么是事务？"></a>什么是事务？</h2><p>一组操作要么全部成功，要么全部失败</p><h2 id="事务的特性是什么？"><a href="#事务的特性是什么？" class="headerlink" title="事务的特性是什么？"></a>事务的特性是什么？</h2><p>ACID</p><p>原子性（<strong>A</strong>tomicity）：事务是最小执行单位，要么全做，要么全不做。</p><p>一致性（<strong>C</strong>onsistency）：事务执行前后，数据库必须从一个一致状态到另一个一致状态。</p><p>隔离性（<strong>I</strong>solation）：多个事务并发时，互不干扰。</p><p>持久性（<strong>D</strong>urability）：事务一旦提交，修改就永久保存，不会因宕机丢失。</p><h2 id="mysql怎么保证数据一致性的？"><a href="#mysql怎么保证数据一致性的？" class="headerlink" title="mysql怎么保证数据一致性的？"></a>mysql怎么保证数据一致性的？</h2><p>MySQL 对数据一致性的保证是 ACID 特性协同作用的结果：</p><ul><li>原子性通过 undo log 确保操作的完整性；</li><li>隔离性通过锁和 MVCC 控制并发干扰；</li><li>持久性通过 redo log 保证提交后的数据安全；</li><li>最终通过这些机制，使数据库从一个一致状态（事务开始前）可靠地过渡到另一个一致状态（事务提交后）。</li></ul><h2 id="mysql事务并发会有哪些问题？"><a href="#mysql事务并发会有哪些问题？" class="headerlink" title="mysql事务并发会有哪些问题？"></a>mysql事务并发会有哪些问题？</h2><ul><li><strong>脏读</strong>：事务 A 读取到事务 B 未提交的修改（若 B 回滚，A 读取的数据是 “脏数据”）。</li><li><strong>不可重复读</strong>：事务 A 多次读取同一数据，期间事务 B 修改并提交了该数据，导致 A 两次读取结果不一致。（修改导致两次读取的不一致）</li><li><strong>幻读</strong>：事务 A 按条件查询数据，期间事务 B 插入 &#x2F; 删除了符合条件的新数据，导致 A 再次查询时结果集增多 &#x2F; 减少（类似 “幻觉”）。（增删导致的两次读取不一致）</li></ul><h2 id="mysql的事务特性分别是怎么实现的？"><a href="#mysql的事务特性分别是怎么实现的？" class="headerlink" title="mysql的事务特性分别是怎么实现的？"></a>mysql的事务特性分别是怎么实现的？</h2><ul><li>原子性 → undo log；</li><li>一致性 → 原子性 + 隔离性 + 持久性协同；</li><li>隔离性 → 锁机制（当前读）+ MVCC（快照读 + ReadView）；</li><li>持久性 → redo log。</li></ul><h2 id="mysql的隔离级别有哪些？"><a href="#mysql的隔离级别有哪些？" class="headerlink" title="mysql的隔离级别有哪些？"></a>mysql的隔离级别有哪些？</h2><table><thead><tr><th>隔离级别</th><th>脏读</th><th>不可重复读</th><th>幻读</th></tr></thead><tbody><tr><td>读未提交</td><td>可能</td><td>可能</td><td>可能</td></tr><tr><td>读已提交</td><td>不可能</td><td>可能</td><td>可能</td></tr><tr><td>可重复读（默认）</td><td>不可能</td><td>不可能</td><td>极大避免（通过锁机制）</td></tr><tr><td>可串行化</td><td>不可能</td><td>不可能</td><td>不可能</td></tr></tbody></table><h2 id="mysql默认的隔离级别有哪些？"><a href="#mysql默认的隔离级别有哪些？" class="headerlink" title="mysql默认的隔离级别有哪些？"></a>mysql默认的隔离级别有哪些？</h2><ul><li><strong>读未提交（Read Uncommitted）</strong>：事务可读取其他未提交事务的修改。</li><li><strong>读已提交（Read Committed）</strong>：事务只能读取其他已提交事务的修改。</li><li><strong>可重复读（Repeatable Read）</strong>（默认）：事务中多次读取同一数据的结果一致（即使其他事务修改并提交）。</li><li><strong>串行化（Serializable）</strong>：事务串行执行，完全避免并发问题。</li></ul><h2 id="不同的隔离级别分别解决了什么问题？"><a href="#不同的隔离级别分别解决了什么问题？" class="headerlink" title="不同的隔离级别分别解决了什么问题？"></a>不同的隔离级别分别解决了什么问题？</h2><ul><li><strong>读未提交（Read Uncommitted）</strong>：什么问题都没解决</li><li><strong>读已提交（Read Committed）</strong>：解决了脏读</li><li><strong>可重复读（Repeatable Read）</strong>（默认）：解决了脏读、不可重复读以及部分幻读</li><li><strong>串行化（Serializable）</strong>：解决所有问题，但是性能低</li></ul><h2 id="什么是mvcc？"><a href="#什么是mvcc？" class="headerlink" title="什么是mvcc？"></a>什么是mvcc？</h2><p>MVCC（多版本并发控制）<strong>是一种并发控制手段</strong>。它通过undolog版本链+readView读视图实现，允许读写操作不冲突（读不加锁，写不阻塞读），从而提高并发性能。</p><h2 id="readView是什么？"><a href="#readView是什么？" class="headerlink" title="readView是什么？"></a>readView是什么？</h2><p>ReadView（读视图）是 MVCC 中用于判断数据版本可见性的逻辑结构，包含 4 个核心字段：</p><ul><li><code>m_ids</code>：当前活跃事务 ID 集合列表。</li><li><code>min_trx_id</code>：活跃事务中最小的 ID。</li><li><code>max_trx_id</code>：下一个将分配的事务 ID。</li><li><code>creator_trx_id</code>：创建该 ReadView 的事务 ID。</li></ul><p>作用：通过比较数据版本的事务 ID 与 ReadView 的字段，判断当前事务能否看到该版本。</p><p>可见性判断规则：</p><ul><li>比最小活跃事务ID小，一定读</li><li>比最大活跃事务ID大，一定不读</li><li>在最大最小之间的：<ul><li>在活跃列表（未提交），不读</li><li>不在列表（已提交），读</li></ul></li></ul><h2 id="什么是快照读和当前读？他们的区别是什么？"><a href="#什么是快照读和当前读？他们的区别是什么？" class="headerlink" title="什么是快照读和当前读？他们的区别是什么？"></a>什么是快照读和当前读？他们的区别是什么？</h2><ul><li><strong>快照读</strong>：读取数据的历史快照（非最新版本），不加锁，性能高。例如普通<code>SELECT</code>语句。</li><li><strong>当前读</strong>：读取数据的最新版本，且会加锁（防止其他事务修改）。例如<code>SELECT ... FOR UPDATE</code>、<code>INSERT</code>、<code>UPDATE</code>、<code>DELETE</code>等。</li></ul><p>区别：快照读依赖 MVCC，无锁冲突；当前读依赖锁机制，会阻塞其他事务的写操作。</p><h2 id="不同隔离级别下生成readView的时机？"><a href="#不同隔离级别下生成readView的时机？" class="headerlink" title="不同隔离级别下生成readView的时机？"></a>不同隔离级别下生成readView的时机？</h2><ul><li>读未提交：不生成 ReadView，直接读取最新版本。</li><li>读已提交：<strong>每次执行 SELECT 时</strong>生成新的 ReadView（因此能看到其他事务已提交的修改）。</li><li>可重复读：<strong>事务中第一次执行 SELECT 时</strong>生成 ReadView，后续复用（因此多次读结果一致）。</li><li>串行化：不依赖 MVCC，通过锁机制实现，无需生成 ReadView。</li></ul><h2 id="可重复读怎么解决不可重复读的？"><a href="#可重复读怎么解决不可重复读的？" class="headerlink" title="可重复读怎么解决不可重复读的？"></a>可重复读怎么解决不可重复读的？</h2><p>可重复读级别下，事务首次执行<code>SELECT</code>时生成 ReadView，后续所有查询复用该 ReadView。即使其他事务修改数据并提交，当前事务仍通过最初的 ReadView 判断可见性，因此多次读取结果一致，避免了不可重复读。</p><h2 id="mysql的锁有哪些类型"><a href="#mysql的锁有哪些类型" class="headerlink" title="mysql的锁有哪些类型"></a>mysql的锁有哪些类型</h2><p>表锁、行锁</p><p>共享锁、排他锁</p><p>意向锁</p><p>记录锁、间隙锁、临键锁</p><h2 id="普通索引的行锁是怎么加锁的？"><a href="#普通索引的行锁是怎么加锁的？" class="headerlink" title="普通索引的行锁是怎么加锁的？"></a>普通索引的行锁是怎么加锁的？</h2><p><img src="/images/upload/image-20251016095033422.png" alt="image-20251016095033422.png"></p><h2 id="数据更新的流程是怎么样的？"><a href="#数据更新的流程是怎么样的？" class="headerlink" title="数据更新的流程是怎么样的？"></a>数据更新的流程是怎么样的？</h2><ol><li><strong>缓冲池</strong>：先看buffer pool中有没有这条数据，如果有就直接取出来，如果没有，从磁盘加载到buffer pool再操作</li><li><strong>undo log日志</strong>：更新前考虑到可能回滚，所以先写一份旧值到undolog</li><li><strong>更新缓冲池数据</strong>：将内存中的数据改为新值，此时数据页和磁盘数据不一致，被标记为脏页</li><li><strong>记录redo log</strong>：先写入redo log buffer，然后按照策略刷盘（定时刷新&#x2F;事务提交&#x2F;log buffer写满）</li><li><strong>写入binlog</strong>：记录了所有对数据库进行更改的逻辑操作，可以实现数据库故障的数据恢复</li><li><strong>两阶段提交</strong>：通过两阶段提交最终保证事务的持久性与一致性<ul><li>如果一阶段redolog未刷盘就发生故障，回滚事务</li><li>如果一阶段redolog刷盘但undolog未刷盘，也回滚事务</li><li>如果一阶段redolog和undolog都刷盘，只有二阶段redolog未写入，依旧认为数据完整，提交事务</li></ul></li><li><strong>异步线程刷盘</strong>：通过后台的异步IO线程，会在之后某个时间里，随机的把内存buffer pool中的修改后的脏数据给刷回到磁盘上的数据文件里去</li></ol><h2 id="mysql的bufferpool是什么？"><a href="#mysql的bufferpool是什么？" class="headerlink" title="mysql的bufferpool是什么？"></a>mysql的bufferpool是什么？</h2><p><strong>Buffer Pool 就是 MySQL 的“内存缓存”</strong>，把常用的数据和索引页放在内存里，减少磁盘读写。（<strong>Buffer Pool 是内存里的临时副本</strong>）</p><h2 id="redolog是什么和binlog有什么区别？"><a href="#redolog是什么和binlog有什么区别？" class="headerlink" title="redolog是什么和binlog有什么区别？"></a>redolog是什么和binlog有什么区别？</h2><p>redolog是物理日志，binlog是逻辑日志</p><table><thead><tr><th>维度</th><th>Redo Log</th><th>Binlog</th></tr></thead><tbody><tr><td>所属层</td><td>InnoDB 存储引擎层</td><td>MySQL Server 层</td></tr><tr><td>日志类型</td><td>物理日志（记录数据页修改）</td><td>逻辑日志（记录 SQL 逻辑）</td></tr><tr><td>作用</td><td>崩溃恢复（保证 ACID 的 D）</td><td>主从复制、数据备份</td></tr><tr><td>写入时机</td><td>事务执行中循环写入（循环写）</td><td>事务提交后写入（追加写）</td></tr><tr><td>生命周期</td><td>与数据页刷新绑定</td><td>可独立归档、删除</td></tr></tbody></table><h2 id="什么是逻辑日志，什么是物理日志？"><a href="#什么是逻辑日志，什么是物理日志？" class="headerlink" title="什么是逻辑日志，什么是物理日志？"></a>什么是逻辑日志，什么是物理日志？</h2><ul><li><strong>逻辑日志</strong>：记录操作的逻辑含义（如 “将 id&#x3D;1 的 name 改为 ‘abc’”），与存储格式无关，可读性强。例如 Binlog。</li><li><strong>物理日志</strong>：记录数据页的物理变化（如 “数据页 0x123 的偏移量 100 处值改为 0x55”），依赖存储格式，恢复速度快。例如 Redo Log。</li></ul><h2 id="bufferpool的内部结构是怎么样的？"><a href="#bufferpool的内部结构是怎么样的？" class="headerlink" title="bufferpool的内部结构是怎么样的？"></a>bufferpool的内部结构是怎么样的？</h2><ul><li><strong>缓存页（Page）</strong>：默认 16KB，与磁盘数据页大小一致，用于存储数据 &#x2F; 索引。</li><li><strong>描述信息</strong>：每个缓存页对应一个控制块，记录页的元数据（如页地址、表空间 ID、LRU 链表指针等）。</li><li><strong>链表结构</strong>：<ul><li><strong>Free 链表</strong>：未使用的缓存页列表。</li><li><strong>LRU 链表</strong>：管理缓存页的 “冷热”，热点数据（频繁访问）在前端，冷数据在后端，淘汰时从后端移除。</li><li><strong>Flush 链表</strong>：已修改但未刷盘的缓存页（脏页）列表，等待刷盘。</li></ul></li></ul><h2 id="mysql对数据页冷热分离是怎么做的？"><a href="#mysql对数据页冷热分离是怎么做的？" class="headerlink" title="mysql对数据页冷热分离是怎么做的？"></a>mysql对数据页冷热分离是怎么做的？</h2><p>新加载的数据页一律放在冷数据区的链表头部，等至少 1s 之后再次访问，才会被提升到热区头部</p><p>冷数据区37%，热数据区63%（约为6 ：4）</p><h2 id="mysql行格式是什么，什么是空值列表？"><a href="#mysql行格式是什么，什么是空值列表？" class="headerlink" title="mysql行格式是什么，什么是空值列表？"></a>mysql行格式是什么，什么是空值列表？</h2><p>行格式规定<strong>一行数据在磁盘和内存中的存储布局</strong>。</p><p>空值列表是用一个紧凑的标记来记录，这样能大幅节省存储空间，在 <strong>COMPACT 行格式</strong>中，是用 <strong>二进制 bit 位</strong> 来标记。</p><h2 id="有没有做过mysql的调优，怎么做的？"><a href="#有没有做过mysql的调优，怎么做的？" class="headerlink" title="有没有做过mysql的调优，怎么做的？"></a>有没有做过mysql的调优，怎么做的？</h2><p>SQL调优是一个很大的概念，但是大致就是从索引优化、代码&#x2F;业务优化、架构优化几个方向上来做：</p><ul><li>比如最常说的索引优化：<ol><li>我们可以使用覆盖索引避免回表；</li><li>然后就是尽量满足最左匹配原则，避免索引失效；</li><li>还有就是索引也不宜过多，这样写入的时候维护索引的成本就高了，也占磁盘空间，mysql选择索引的时候也会选择困难</li></ol></li><li>再从从代码&#x2F;业务层面的话：<ol><li>减少sql次数，不在循环发sql，避免频繁数据库IO</li><li>可以尽量控制事务范围，用小事务避免使用大事务，不在事务中做文件&#x2F;网络IO操作</li><li>在业务允许的情况下，使用合适的隔离级别，如RR-&gt;RC，避免锁等待</li><li>在业务上做优化，比如如果需要查询未加索引的情况时，要求用户必填一个加了索引的字段，先筛选掉一部分数据在逐行查询</li></ol></li><li>最后就是架构上来说：<ol><li>最容易想到的就是加缓存中间层分担数据库压力，如redis、caffiein、guava</li><li>可以使用读写分离、分库分表（注意数据库主键与业务主键分离）+使用OLAP数据库定时归档减少OLTP数据库的数据量来分担数据库压力</li><li>还可以通过升级数据库版本、采用性能更好的连接池来优化</li></ol></li></ul><h2 id="mysql8-0对比5-7有哪些提升？"><a href="#mysql8-0对比5-7有哪些提升？" class="headerlink" title="mysql8.0对比5.7有哪些提升？"></a>mysql8.0对比5.7有哪些提升？</h2><p> 隐藏索引、窗口函数、更强的 JSON 支持，在线ddl</p><h2 id="explain怎么使用，关注哪些字段"><a href="#explain怎么使用，关注哪些字段" class="headerlink" title="explain怎么使用，关注哪些字段"></a>explain怎么使用，关注哪些字段</h2><p>在SQL语句前加EXPLAIN关键字就可以看执行计划，主要关注<strong>possible_keys（可能用到的索引）</strong>，<strong>key（实际用到的索引）</strong>，<strong>type（用到了哪种索引）</strong> ，还有就是<strong>Extra（额外信息，提示索引覆盖、索引下推、产生了条件过滤临时表等）</strong></p>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/mysql-interview/</id>
    <link href="https://blog.wangbowei.com/archives/mysql-interview/"/>
    <published>2025-09-09T16:25:00.000Z</published>
    <summary>常用的连接池有哪些，他们有什么区别 HikariCP：最轻量、最快，Spring Boot 默认，推荐优先使用 Druid：阿里巴巴开源，性能稍逊，但功能丰富，尤其是监控、统计、SQL 防注入，适合对 安全性和运维监控 要求高的项目（牺牲少量性能换取了监控功能） C3P0 / DBCP：曾经流行，现</summary>
    <title>MySQL 八股文面试题</title>
    <updated>2026-04-09T16:25:46.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Bob</name>
    </author>
    <category term="Java" scheme="https://blog.wangbowei.com/categories/Java/"/>
    <category term="集合" scheme="https://blog.wangbowei.com/tags/%E9%9B%86%E5%90%88/"/>
    <category term="八股" scheme="https://blog.wangbowei.com/tags/%E5%85%AB%E8%82%A1/"/>
    <content>
      <![CDATA[<h2 id="在Java中，集合体系结构是怎么样的？主要分为那些类？分别有什么特点？"><a href="#在Java中，集合体系结构是怎么样的？主要分为那些类？分别有什么特点？" class="headerlink" title="在Java中，集合体系结构是怎么样的？主要分为那些类？分别有什么特点？"></a>在Java中，集合体系结构是怎么样的？主要分为那些类？分别有什么特点？</h2><ul><li>单列集合（Collection）<ul><li>List：<strong>有序、可重复</strong>的集合（如 ArrayList、LinkedList）。</li><li>Set：<strong>无序、不可重复</strong>的集合（如 HashSet、TreeSet）。</li></ul></li><li>双列集合（Map）<ul><li>代表一组键值对（Key-Value）的映射关系，<strong>键不可重复</strong>。（如<code>HashMap</code>、<code>TreeMap</code>、<code>LinkedHashMap</code>）</li></ul></li></ul><p>主要类特点：</p><ul><li><code>ArrayList</code>：动态数组，随机访问快，插入删除慢。</li><li><code>LinkedList</code>：双向链表，插入删除快（尤其是中间位置），随机访问慢。</li><li><code>HashSet</code>：底层依赖<code>HashMap</code>，无序，查询快。</li><li><code>TreeSet</code>：基于红黑树，元素有序（自然排序或自定义排序）。</li><li><code>HashMap</code>：数组 + 链表 &#x2F; 红黑树，无序，查询、插入效率高。</li><li><code>TreeMap</code>：基于红黑树，key 有序，支持范围查询。</li></ul><h2 id="List和Set分别有什么特点？"><a href="#List和Set分别有什么特点？" class="headerlink" title="List和Set分别有什么特点？"></a>List和Set分别有什么特点？</h2><ul><li><strong>List</strong>：<ul><li>有序（元素插入顺序与遍历顺序一致）。</li><li>可重复（允许元素值相同）。</li><li>支持通过索引访问（<code>get(int index)</code>）。</li><li>允许存储多个<code>null</code>元素。</li></ul></li><li><strong>Set</strong>：<ul><li>无序（<code>HashSet</code>）或有序（<code>TreeSet</code>按 key 排序，<code>LinkedHashSet</code>按插入顺序）。</li><li>不可重复（元素需重写<code>equals()</code>和<code>hashCode()</code>保证唯一性）。</li><li>无索引，不支持随机访问。</li><li>最多允许一个<code>null</code>元素（<code>HashSet</code>）。</li></ul></li></ul><h2 id="ArrayList-和-LinkedList有什么区别？"><a href="#ArrayList-和-LinkedList有什么区别？" class="headerlink" title="ArrayList 和 LinkedList有什么区别？"></a>ArrayList 和 LinkedList有什么区别？</h2><table><thead><tr><th>维度</th><th>ArrayList</th><th>LinkedList</th></tr></thead><tbody><tr><td>底层结构</td><td>动态数组（连续内存）</td><td>双向链表（非连续内存）</td></tr><tr><td>随机访问</td><td>快（<code>O(1)</code>，直接通过索引）</td><td>慢（<code>O(n)</code>，需遍历链表）</td></tr><tr><td>尾部插入 &#x2F; 删除</td><td>快（O(1)）</td><td>快（<code>O(1)</code>，仅需调整指针）</td></tr><tr><td>中间插入 &#x2F; 删除</td><td>慢（<code>O(n)</code>，需移动元素）</td><td>快（<code>O(1)</code>）</td></tr></tbody></table><h2 id="ArrayList的扩容机制？"><a href="#ArrayList的扩容机制？" class="headerlink" title="ArrayList的扩容机制？"></a>ArrayList的扩容机制？</h2><ul><li><strong>初始容量</strong>：默认 10（无参构造），也可通过构造函数指定初始容量。</li><li><strong>扩容触发</strong>：当添加元素后，<code>size</code>超过当前容量时触发。</li><li><strong>扩容逻辑</strong>：<ol><li>计算新容量：默认是原容量的 1.5 倍（<code>oldCapacity + (oldCapacity &gt;&gt; 1)</code>）。</li><li>若新容量仍不足（如添加大量元素），直接扩容至所需容量。</li><li>通过<code>Arrays.copyOf()</code>复制原数组元素到新数组，替换原数组引用。</li></ol></li></ul><h2 id="说下-HashMap的put流程及扩容机制？"><a href="#说下-HashMap的put流程及扩容机制？" class="headerlink" title="说下 HashMap的put流程及扩容机制？"></a>说下 HashMap的put流程及扩容机制？</h2><p><img src="/images/upload/image-20251012162400495.png" alt="image-20251012162400495.png"></p><ul><li><strong>扩容机制</strong>：<ol><li>新容量为原容量的 2 倍（保证容量为 2 的幂）。</li><li>重新计算每个节点的新下标（JDK1.8 中通过<code>hash &amp; oldCapacity</code>判断，0 则下标不变，1 则下标 &#x3D; 原下标 + oldCapacity）。</li><li>将原数组元素迁移至新数组（链表拆分或红黑树拆分）。</li></ol></li></ul><h2 id="HashMap的扩容如何触发？"><a href="#HashMap的扩容如何触发？" class="headerlink" title="HashMap的扩容如何触发？"></a>HashMap的扩容如何触发？</h2><ul><li>当<code>put</code>元素后，<code>size</code>（键值对数量）超过阈值（<code>capacity * loadFactor</code>，默认负载因子 0.75）时触发。</li><li>特殊情况：若链表长度超过 8 且数组容量 &lt; 64，会先扩容而非转为红黑树。</li></ul><h2 id="HashMap-在-JDK-1-7-和-JDK-1-8-中有什么区别？"><a href="#HashMap-在-JDK-1-7-和-JDK-1-8-中有什么区别？" class="headerlink" title="HashMap 在 JDK 1.7 和 JDK 1.8 中有什么区别？"></a>HashMap 在 JDK 1.7 和 JDK 1.8 中有什么区别？</h2><table><thead><tr><th>维度</th><th>JDK 1.7</th><th>JDK 1.8</th></tr></thead><tbody><tr><td>底层结构</td><td>数组 + 链表</td><td>数组 + 链表 + 红黑树</td></tr><tr><td>链表插入方式</td><td>头插法（可能导致循环链表）</td><td>尾插法（避免循环）</td></tr><tr><td>扩容时元素迁移</td><td>重新计算 hash</td><td>利用高低位判断新下标</td></tr><tr><td>hash 计算</td><td>多次扰动（4 次移位 + 异或）</td><td>1 次扰动（高 16 位异或低 16 位）</td></tr><tr><td>阈值判断（转树）</td><td>无（仅链表）</td><td>链表长度 &gt; 8 且容量≥64 转红黑树</td></tr><tr><td>安全性</td><td>线程不安全，扩容可能死循环</td><td>线程不安全，但避免死循环</td></tr></tbody></table><h2 id="CopyOnWriteArrayList有什么特点？"><a href="#CopyOnWriteArrayList有什么特点？" class="headerlink" title="CopyOnWriteArrayList有什么特点？"></a>CopyOnWriteArrayList有什么特点？</h2><p>CopyOnWriteArrayList 采用的是<strong>写时复制</strong>的技术，<strong>适用于读多写少的场景</strong>，读操作不需要加锁，当时读取到的数据可能不是最新的数据。</p><h2 id="ConcurrentHashMap在JDK1-8中是如何保证put流程和初始化流程线程安全的？"><a href="#ConcurrentHashMap在JDK1-8中是如何保证put流程和初始化流程线程安全的？" class="headerlink" title="ConcurrentHashMap在JDK1.8中是如何保证put流程和初始化流程线程安全的？"></a>ConcurrentHashMap在JDK1.8中是如何保证put流程和初始化流程线程安全的？</h2><ul><li><strong>初始化</strong>：<ul><li>通过 CAS 操作保证线程安全。当<code>table</code>为<code>null</code>时，多个线程竞争初始化，CAS 成功的线程执行初始化（设置容量），失败的线程自旋等待。</li></ul></li><li><strong>put 流程</strong>：<ol><li>计算 hash 和下标，若数组未初始化则触发初始化。</li><li>若下标位置为空，通过 CAS 插入节点（无锁）。</li><li>若下标位置为<code>MOVED</code>（正在扩容），帮助扩容（多线程协同扩容）。</li><li>否则，对该位置的头节点加<code>synchronized</code>锁，执行插入（链表或红黑树）。</li><li>插入后更新元素数量（通过<code>baseCount</code>或<code>CounterCell</code>，CAS 更新避免锁竞争）。</li></ol></li></ul><h2 id="ConcurrentHashMap在JDK1-8中和JDK1-7中分别是怎么保证线程安全的？哪个效率好？"><a href="#ConcurrentHashMap在JDK1-8中和JDK1-7中分别是怎么保证线程安全的？哪个效率好？" class="headerlink" title="ConcurrentHashMap在JDK1.8中和JDK1.7中分别是怎么保证线程安全的？哪个效率好？"></a>ConcurrentHashMap在JDK1.8中和JDK1.7中分别是怎么保证线程安全的？哪个效率好？</h2><ul><li><strong>JDK 1.7</strong>：<ul><li>采用<strong>分段锁（Segment）</strong>：每个 Segment 是独立的 HashMap，自带<code>ReentrantLock</code>。</li><li>不同 Segment 的操作互不干扰，锁粒度为 Segment。</li></ul></li><li><strong>JDK 1.8</strong>：<ul><li>取消分段锁，采用<strong>CAS + synchronized</strong>：对数组槽位的头节点加锁（锁粒度为单个节点）。</li><li>无竞争时用 CAS，有竞争时才加锁，效率更高。</li></ul></li><li><strong>效率对比</strong>：<strong>JDK 1.8 效率更高</strong>。原因是锁粒度更细（节点级），减少锁竞争，且 CAS 操作在低并发时无需阻塞，性能更优。</li></ul>]]>
    </content>
    <id>https://blog.wangbowei.com/archives/java-collection-interview/</id>
    <link href="https://blog.wangbowei.com/archives/java-collection-interview/"/>
    <published>2025-09-03T11:57:00.000Z</published>
    <summary>在Java中，集合体系结构是怎么样的？主要分为那些类？分别有什么特点？ 单列集合（Collection） List：有序、可重复的集合（如 ArrayList、LinkedList）。 Set：无序、不可重复的集合（如 HashSet、TreeSet）。 双列集合（Map） 代表一组键值对（Key-</summary>
    <title>集合 八股文面试题</title>
    <updated>2026-04-09T16:24:39.000Z</updated>
  </entry>
</feed>