Redis 八股文面试题
你在开发中都是怎么使用Redis的 ?
我主要使用的是 Redis的缓存和它的分布式锁功能
Redis 为什么快?
- 基于内存操作:内存的速度远高于访问磁盘的速度
- 单线程 + I/O 多路复用:避免了多线程带来的锁竞争、上下文切换的开销。
- 高效的底层数据结构和编码:使用内存紧凑的 ziplist (压缩列表) 来存储数据,以节省内存空间。
- 非阻塞操作:对于耗时的操作(如持久化),会交由子进程去处理,主进程继续响应客户端请求
数据持久化的方式?
- RDB (Redis Database): 快照形式,在一个时间点将数据保存到磁盘。
- 优点: 体积小,恢复快
- 缺点: 有可能导致数据的丢失,在创建子进程时候可能会导致主进程的瞬间阻塞
- AOF (Append Only File): 日志形式,记录 Redis 执行的每个写命令。
- 优点:
- 高可靠性:配置为 always 时零数据丢失;everysec 时仅 1 秒丢失。
- 易恢复:AOF 是可读的协议格式,便于手动编辑。
- 抗损坏:追加式,电源故障仅影响最后命令,易修复。
- 后台重写:不中断服务,文件保持紧凑。
- 缺点:
- 文件大小:比 RDB 大(即使重写后),尤其对相同数据集。
- 性能:always 策略下 I/O 开销高,恢复慢(需回放所有命令)。
- 优点:
- 混合持久化(Redis 4.0+):为了结合 RDB 和 AOF 的优势,Redis 引入了混合持久化;
- 工作方式: 在进行 AOF 重写时,子进程先将内存中的数据以 RDB 格式写入到新 AOF 文件的开头。接着,再将重写期间发生的增量命令以 AOF 格式追加到 RDB 数据的后面。
- 优势: 启动时,先加载 RDB 部分(快),再执行 AOF 部分(保证数据最新),兼顾了启动速度和数据完整性。
RDB的持久化过程?
回答重点:
- 压缩二进制文件
- 子线程操作,创建子线程阻塞主线程
- 共享内存,写时复制COW受影响页
- 创建临时文件,完成后重命名
RDB 是通过生成一个经过压缩的二进制文件(.rdb 文件),来保存某个时间点的数据库状态(快照)。
主进程在接收到持久化命令或达到触发条件,会执行fork()操作,创建子线程(此时会阻塞主线程,父子线程共享同一内存区域);
在RDB期间,如果主线程有写请求,通过COW机制复制受影响的页(降低内存开销),从而可以继续处理;
子线程会将内存数据集写入一个临时 RDB 文件(防止意外导致原dump文件损坏),全部写完后子进程调用操作系统的 rename() 将临时文件重命名为正式的RDB文件(如 dump.rdb),子进程退出并通知父进程。
AOF的执行过程?
在客户端发送写命令后,主进程会将命令格式化为AOF格式后追加到AOF缓冲区,根据配置的策略,使用 fsync 系统调用将缓冲区数据刷到磁盘,确保持久性。
AOF 有哪些策略(fsync 策略)?
always:每次写命令都进行 fsync 同步(刷盘)。最高可靠性,但性能最低(支持组提交以优化并行写)。
everysec(默认):每秒进行一次 fsync 同步。高性能,崩溃时最多丢失 1 秒数据。
no:由操作系统决定何时同步。最高性能,但数据丢失风险高。
什么是 AOF 文件重写?
随着时间推移,AOF 文件会变得越来越大,因为其中包含很多重复的、过期或无效的命令。为了消除冗余命令,会生成一个新的最小的 AOF 文件来替换原来的AOF文件,还原当前内存数据库状态。
重写不是读取旧的 AOF 文件,而是直接读取内存中的当前数据,用最少的命令来重建数据。
AOF 重写执行过程?
回答重点:
- 创建子线程,通过数据快照写入新文件
- 新命令同时写入两个缓冲区
- AOF缓冲区同步到旧的AOF文件中
- AOF重写缓冲区追加到写完的新AOF文件的末尾
- 原子性地替换文件
当触发AOF重写条件时,主进程会fork一个子进程。这时子进程会创建一个新的AOF文件(防止发生意外破坏旧文件)。
此时主进程继续处理客户端的命令,接收到的新命令会同时写入 AOF缓冲区(主进程用,原来就有)和 AOF重写缓冲区(子进程用),AOF缓冲区的内容会被同步到旧的AOF文件中。
子进程将数据库快照重写完毕后,会通知主进程然后主进程会将 AOF重写缓冲区 中的所有内容追加到子进程生成的那个临时的新AOF文件的末尾(这样,新AOF文件就包含了重写开始时的内存快照数据 + 重写期间的所有新数据,与当前数据库状态完全一致),然后 原子性地用新的AOF文件替换旧的AOF文件。
AOF 重写触发条件?
同时满足:
最小触发大小: 默认值是 64MB
增长率阈值: 默认值是 100%
Key过期后的删除策略?
Redis 支持三种过期删除策略:定时删除、惰性删除 和 定期删除。这些策略不是互斥的,而是结合使用(默认惰性 + 定期)。
Redis 为每个数据库维护一个额外的字典(过期时间字典),避免扫描所有键,全局字典太大,过期时间字典中只含过期键。
三种删除策略的区别?
定时删除:为每个设置过期时间的 Key 创建一个定时器。时间一到,定时器立即触发删除。
优点:保证 Key 在过期后立即被删除,内存释放及时。
缺点:对 CPU不友好,需要大量创建和管理定时器,且在大量 Key 同时过期时,会瞬间占用大量 CPU 资源
惰性删除:不主动删除过期键,而是在访问键时判断是否过期,如果过期则删除并返回 nil,这是一种被动策略。
优点:节省 CPU 资源,仅在必要时检查,不需要周期性扫描。
缺点:如果过期键长期不被访问,会一直占用内存直到内存满(然后依赖淘汰策略)。
定期删除:Redis 会周期性地(默认每秒 10 次)随机从过期时间字典中抽取一批 Key(默认为 20 个),检查并删除已过期的 Key,如果删除的过期 Key 数量超过总抽样 Key 数量的 25%(即 5 个),则认为过期 Key 较多,会再次重复此过程,直到比例低于 25% 或达到最大运行时间限制(默认 25 毫秒)。
优点:平衡了 CPU 和内存,定期清理,避免惰性删除的内存积累,对主线程阻塞几乎可以忽略。
缺点:不能保证立即删除;随机采样,可能遗漏一些键。如果过期键爆发式增加,可能清理不及时,导致内存压力。
内存满了之后的淘汰策略?
淘汰范围:
- 全部 Key(allkeys-xxx):从所有键中淘汰,包括永久键。
- 过期 Key(volatile-xxx):仅从设置了过期时间的键中淘汰。
算法:
- LRU(Least Recently Used):最近使用时间最远,优先淘汰最久未访问的键。
- LFU(Least Frequently Used):最近使用次数最少,优先淘汰访问频率最低的键。
- Random:随机淘汰。
- TTL:优先淘汰 TTL 最小的键(即将过期)。
不淘汰策略 (默认):
noeviction:当内存不足时,对于新的写入操作会直接拒绝并返回错误。读取操作仍然正常执行。
全 Key 淘汰策略:
allkeys-lru:从所有 Key 中,选择最近最少使用的 Key 进行淘汰。allkeys-lfu:从所有 Key 中,选择最不经常使用的 Key 进行淘汰。allkeys-random:从所有 Key 中,随机选择 Key 进行淘汰。
过期 Key 淘汰策略:
volatile-lru:从设置了过期时间的 Key 中,选择最近最少使用的 Key 进行淘汰。volatile-lfu:从设置了过期时间的 Key 中,选择最不经常使用的 Key 进行淘汰。volatile-random:从设置了过期时间的 Key 中,随机选择 Key 进行淘汰。volatile-ttl:从设置了过期时间的 Key 中,选择剩余生存时间(TTL)最短的 Key 进行淘汰。
| 策略类型 | 范围 | 算法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|---|
| noeviction | - | - | 数据安全 | 写失败 | 纯存储,不允许丢失 |
| allkeys-lru | 所有键 | LRU | 高命中率 | 可能删永久键 | 纯缓存 |
| volatile-lru | 过期键 | LRU | 保护永久键 | 无过期键时失效 | 混合使用(缓存+存储) |
| allkeys-lfu | 所有键 | LFU | 频率敏感 | 新键易删 | 热门项明显的场景 |
| volatile-lfu | 过期键 | LFU | 保护永久键,频率敏感 | 同上 | 同上 |
| allkeys-random | 所有键 | 随机 | 简单快速 | 不智能 | 测试或无模式数据 |
| volatile-random | 过期键 | 随机 | 保护永久键,简单 | 不智能 | 同上 |
| volatile-ttl | 过期键 | TTL | 最小数据丢失 | 忽略访问模式 | 对过期敏感的场景 |
String底层是怎么实现的?
- int编码: 当存储的是整数, 且可以用long表示时使用
- embstr编码: 当存储的字符串长度≤44字节时使用
- raw编码(SDS): 当字符串长度>44字节时使用
SDS相比C字符串有什么优势?
- **O(1)**获取长度 - 有len字段
- 减少内存重分配次数 - 空间预分配和惰性释放
- 二进制安全 - 可存任意数据
- 防止缓冲区溢出 - 自动扩容
Hash什么时候用ziplist, 什么时候用hashtable?
ziplist使用条件(同时满足):
键值对数量 ≤ 512
所有键值长度 ≤ 64字节
不满足任一条件就转为hashtable
List为什么不直接用链表或数组?
纯链表: 内存不连续,CPU缓存不友好
纯数组: 插入删除效率低
quicklist结合两者优点:
用ziplist保证内存连续性
用双向链表保证插入删除效率
set在什么情况下用 intset?
Set的所有元素都是整数,且数量≤512时;
一旦添加非整数或超过512个,就转为hashtable
什么是跳表?
跳表是一个分级别的数据结构, 最底层的那个级别存储了所有的元素, 每往上一层这个数据就会减少;
在进行数据存储的时候, 先存储在最底层, 然后往上存储, 上一层存储的概率是25%, 每往上一层都会乘以0.25,最高到32层;
查询的时候是从上往下进行查询, 因为上层的数据比较少, 相对于是索引结构, 可以快速定位到目标数据。
ZSet为什么要同时用skiplist和dict?
skiplist: 提供有序性,支持范围查询ZRANGE
dict: 提供O(1)的ZSCORE查询快速获取分数
两个结构配合使用,各取所长,内存通过指针共享,不会浪费
自己实现的分布式锁有什么问题?Redisson是如何解决这些问题的?
redis分布式锁的基本原理是SETNX(只有当key在redis中不存在才存储成功,存在则返回失败)
| 问题 | 说明 | 解决方案 |
|---|---|---|
| 1 死锁 | 服务宕机,锁永远不释放 | 设置过期时间 |
| 2 误删锁 | 删除了别人的锁 | 加唯一标识,删除前判断 |
| 3 原子性 | 判断和删除不是原子操作 | 使用Lua 脚本 |
| 4 锁续期 | 业务没执行完锁就过期了 | 看门狗机制 |
| 5 可重入 | 同一线程获取多次锁 | 记录持有者和次数 |
Redis如何解决锁自动续期问题?
通过看门狗机制
- 默认锁过期时间30秒
- 获取锁成功后,Redisson会启动一个后台线程(看门狗)
- 每隔10秒检查一次你的这个锁还在不在,如果不在说明你自己手动释放了
- 如果还在,说明 业务还在执行,自动重置30秒
- 业务完成后,停止续期
前提:你在使用Redisson去获取分布式锁的时候不要去设置过期时间,如果你自己设置了过期时间,看门狗就失效了
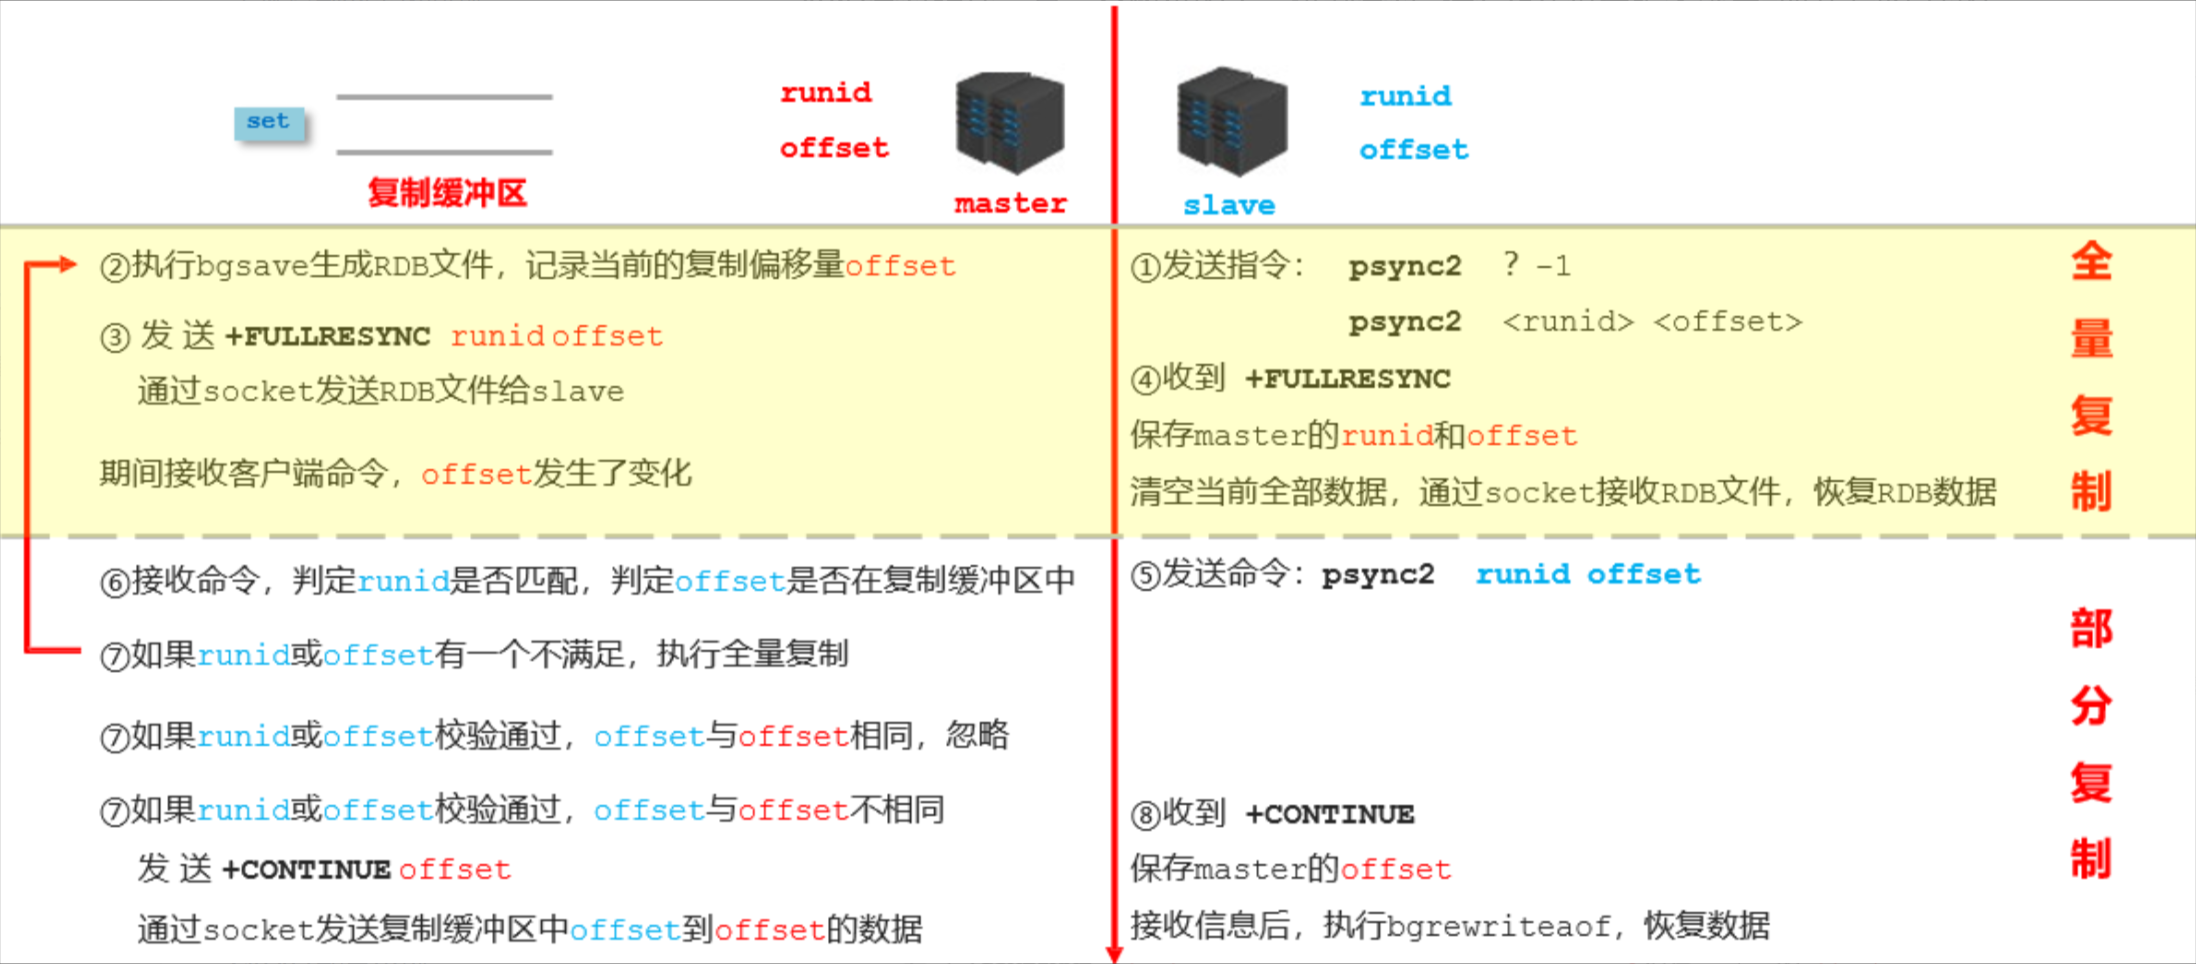
主从复制的过程?
- Slave节点会主动向Master节点发送同步数据的请求
- 如果是第一次同步 发送的命令是
psync2 ? -1?代表的是第一次同步 -1代表的是同步所有数据 - 如果不是第一次同步 发送的命令是 psync2 主节点的runid 上一次同步到的偏移量位置 offset
- 如果是第一次同步 发送的命令是
- Master节点收到Slave的同步数据请求后 如果是第一次同步 会将自己内存中的数据 生成RDB文件 同时把自己的runid和自己当前复制缓冲区中的偏移量信息都返回给Slave
- Slave收到Master返回的同步数据 然后进行RDB的恢复 同时保存Master的runid和offset
- Slave还会定期向Master发送同步数据的请求
psync2 runid offset - Master接收同步数据请求后会进行判断
- 先判断Slave传递过来的runid 是不是自己的runid
- 如果是自己的runid 再去对比offset
- 如果不是自己的runid 会再次进行全量复制
- 然后判断offset是否在当前的复制缓冲区内
- 如果在就直接从offset的位置开始 返回到最新的数据 同时把最新的offset返回给Slave
- 如果不在说明Slave已经长时间没有给Master进行数据同步了 复制缓冲区中的数据已经丢失了部分 会再次触发全量复制
- 先判断Slave传递过来的runid 是不是自己的runid
- 定期重复第4步和第5步
什么情况会触发全量复制?
- 第一次同步时
- runid不一致
- offset不在复制缓冲区内
哪些情况下会导致频繁的全量复制?
- Master重启或故障(run_id变化)
- 网络不稳定或中断(偏移量失效)
- 复制积压缓冲区过小(写操作覆盖缓冲区)
- Slave重启或新增(无历史偏移量)
- 数据量大或写频繁(缓冲区溢出,RDB传输慢)
- 配置不当(缓冲区限制低、版本不兼容)
什么是哨兵模式?
如果Master节点发生故障, 哨兵会实现自动故障转移, 在Slave中选举出新的Master
脑裂问题及解决方案?
在哨兵或集群模式下,主节点与哨兵间网络出现中断,导致在不同网络分区的哨兵错误判断主节点下线而重新选举主节点,待网络恢复后存在两个主节点的情况(两者可同时写入,导致数据不一致)
解决方案:
- 通过配置参数来限制原主节点写入权限(允许写入主节点的最小从节点数量、主从节点最大允许的延迟)
- 调整哨兵判断下线时间,增加判断下线所需的哨兵数量
- 做好日志监控报警
缓存击穿、穿透、雪崩问题及解决方案?
| 问题类型 | 核心原因 | 解决方案 |
|---|---|---|
| 缓存穿透 | 请求查询的是根本不存在的数据,缓存和数据库都无法命中,大量请求直接穿透到数据库,可能导致数据库过载宕机。 | 1. 多级缓存 2. 热点key预加载 3. 逻辑过期 |
| 缓存击穿 | 一个热点 key在缓存中过期失效的瞬间,有大量并发请求访问,这些并发请求同时穿透到数据库,造成数据库瞬间压力骤增。 | 1. 参数校验 2. 布隆过滤器 3. 缓存空置 |
| 缓存雪崩 | 大量缓存 key 在同一时间段内集中过期,或缓存服务本身宕机,所有请求全部穿透到数据库,数据库无法承受压力而宕机,引发连锁反应。 | 1. 多级缓存 2. 随机过期时间 |
缓存一致性(MySQL和Redis)的解决方案?
Canal监听binlog:部署Canal工具监听MySQL binlog日志,解析变更事件后异步更新或删除Redis缓存,实现近实时同步。
读写分离+最终一致性:读从Redis,写到MySQL后通过MQ(如Kafka)通知消费者更新Redis;结合TTL设置缓存过期,确保最终一致性。
延时双删:更新DB后,先删除缓存,业务处理后延迟几秒(如500ms)再删一次缓存,确保读请求在延迟期内加载新数据。可以使用消息队列(如RabbitMQ)实现延迟删除。
先更新DB,后删除缓存:写操作时先更新MySQL,再删除对应Redis缓存(而非更新缓存),读时缓存miss则从DB加载。避免脏读,但需处理并发问题。