Seata分布式事务 八股文面试题
什么是CAP定理?
- Consistency 一致性:所有节点在同一时间看到的数据必须一致。
- Availability 可用性:每个请求都能得到响应,不会出现长时间阻塞或错误。
- Partition tolerance 分区容错性:当网络通信出现故障时(如网络丢包、节点之间无法连通),系统仍能继续运作。
在分布式系统中,网络分区无法避免,所以 P 必须保证。那么我们主要在AP/CP模式中做取舍。
CP:保证一致性 + 分区容错,牺牲可用性,适用于需要保证强一致允许响应慢或者直接拒绝请求
AP:保证可用性 + 分区容错,牺牲一致性,保证高可用,响应快但是允许短时数据不一致(我们的项目使用AP)
什么是BASE理论?
BA(Basically Available-基本可用):系统在出现故障或网络分区时,允许损失部分可用性,但必须保证核心功能可用
S(Soft state-软状态):一定时间内,系统中的数据可以是中间状态、未同步状态,允许临时不一致状态
E(Eventually consistent-最终一致性):虽然系统允许短时间不一致,但在乱状态结束后,最终达到数据一致
在实际项目中我们也是遵循BASE理论,基本采用的AP模式保证系统高可用,允许短时的数据不一致。
Seata中有哪些重要角色?
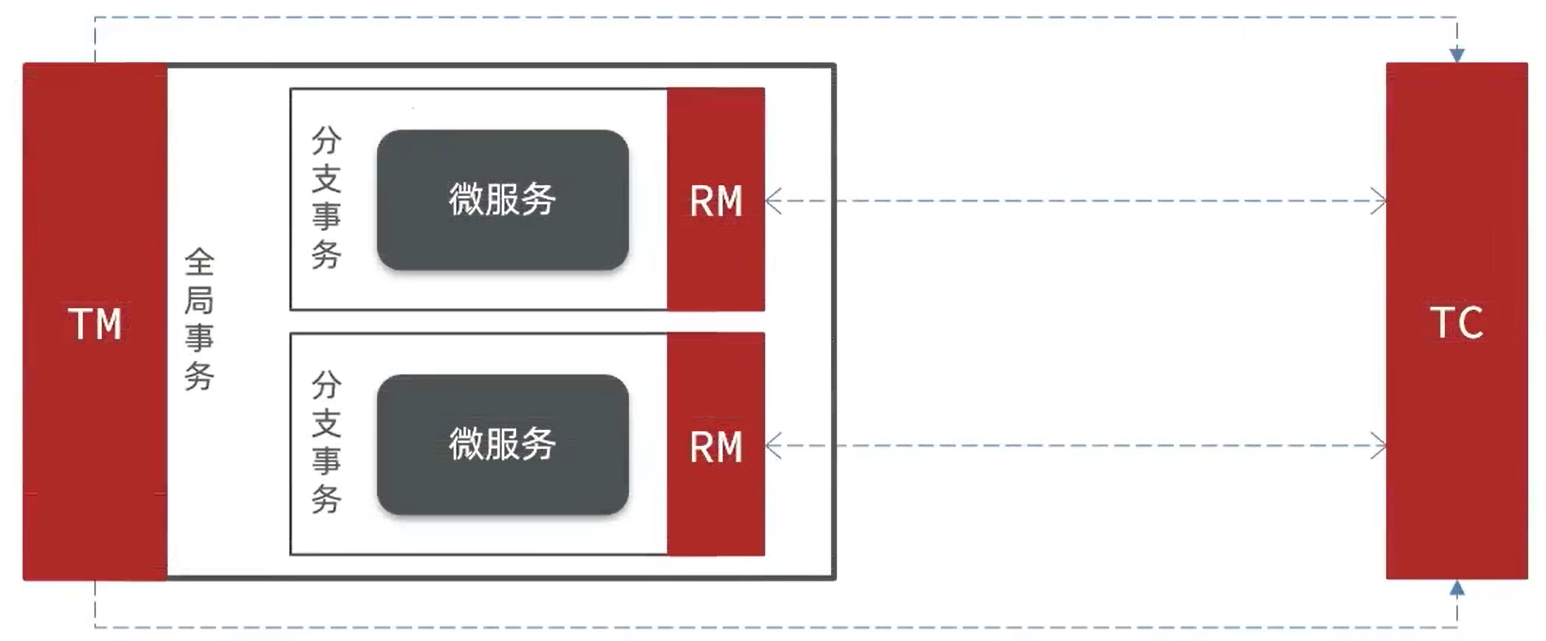
- TC(Transaction Coordinator)事务协调者:负责整个全局和分支事务事务的状态,协调全局事务的提交和回滚
- TM(Transaction Manager)事务管理者:定义全局事务范围,开始全局事务、提交/回滚全局事务
- RM(Resource Manager)资源管理者:管理分支事务处理的资源,与TC交谈,以注册分支事务和报告分支事务的状态,并驱动分支事务的提交/回滚。
Seata有几种模式?
XA模式:强一致性分阶段事务模式,牺牲了一定的可用性,无业务侵入
AT模式:最终一致的分阶段事务模式,无业务侵入,也是Seata的默认模式
TCC模式:最终一致的分阶段事务模式,有业务侵入
SAGA模式:长事务模式,有业务侵入
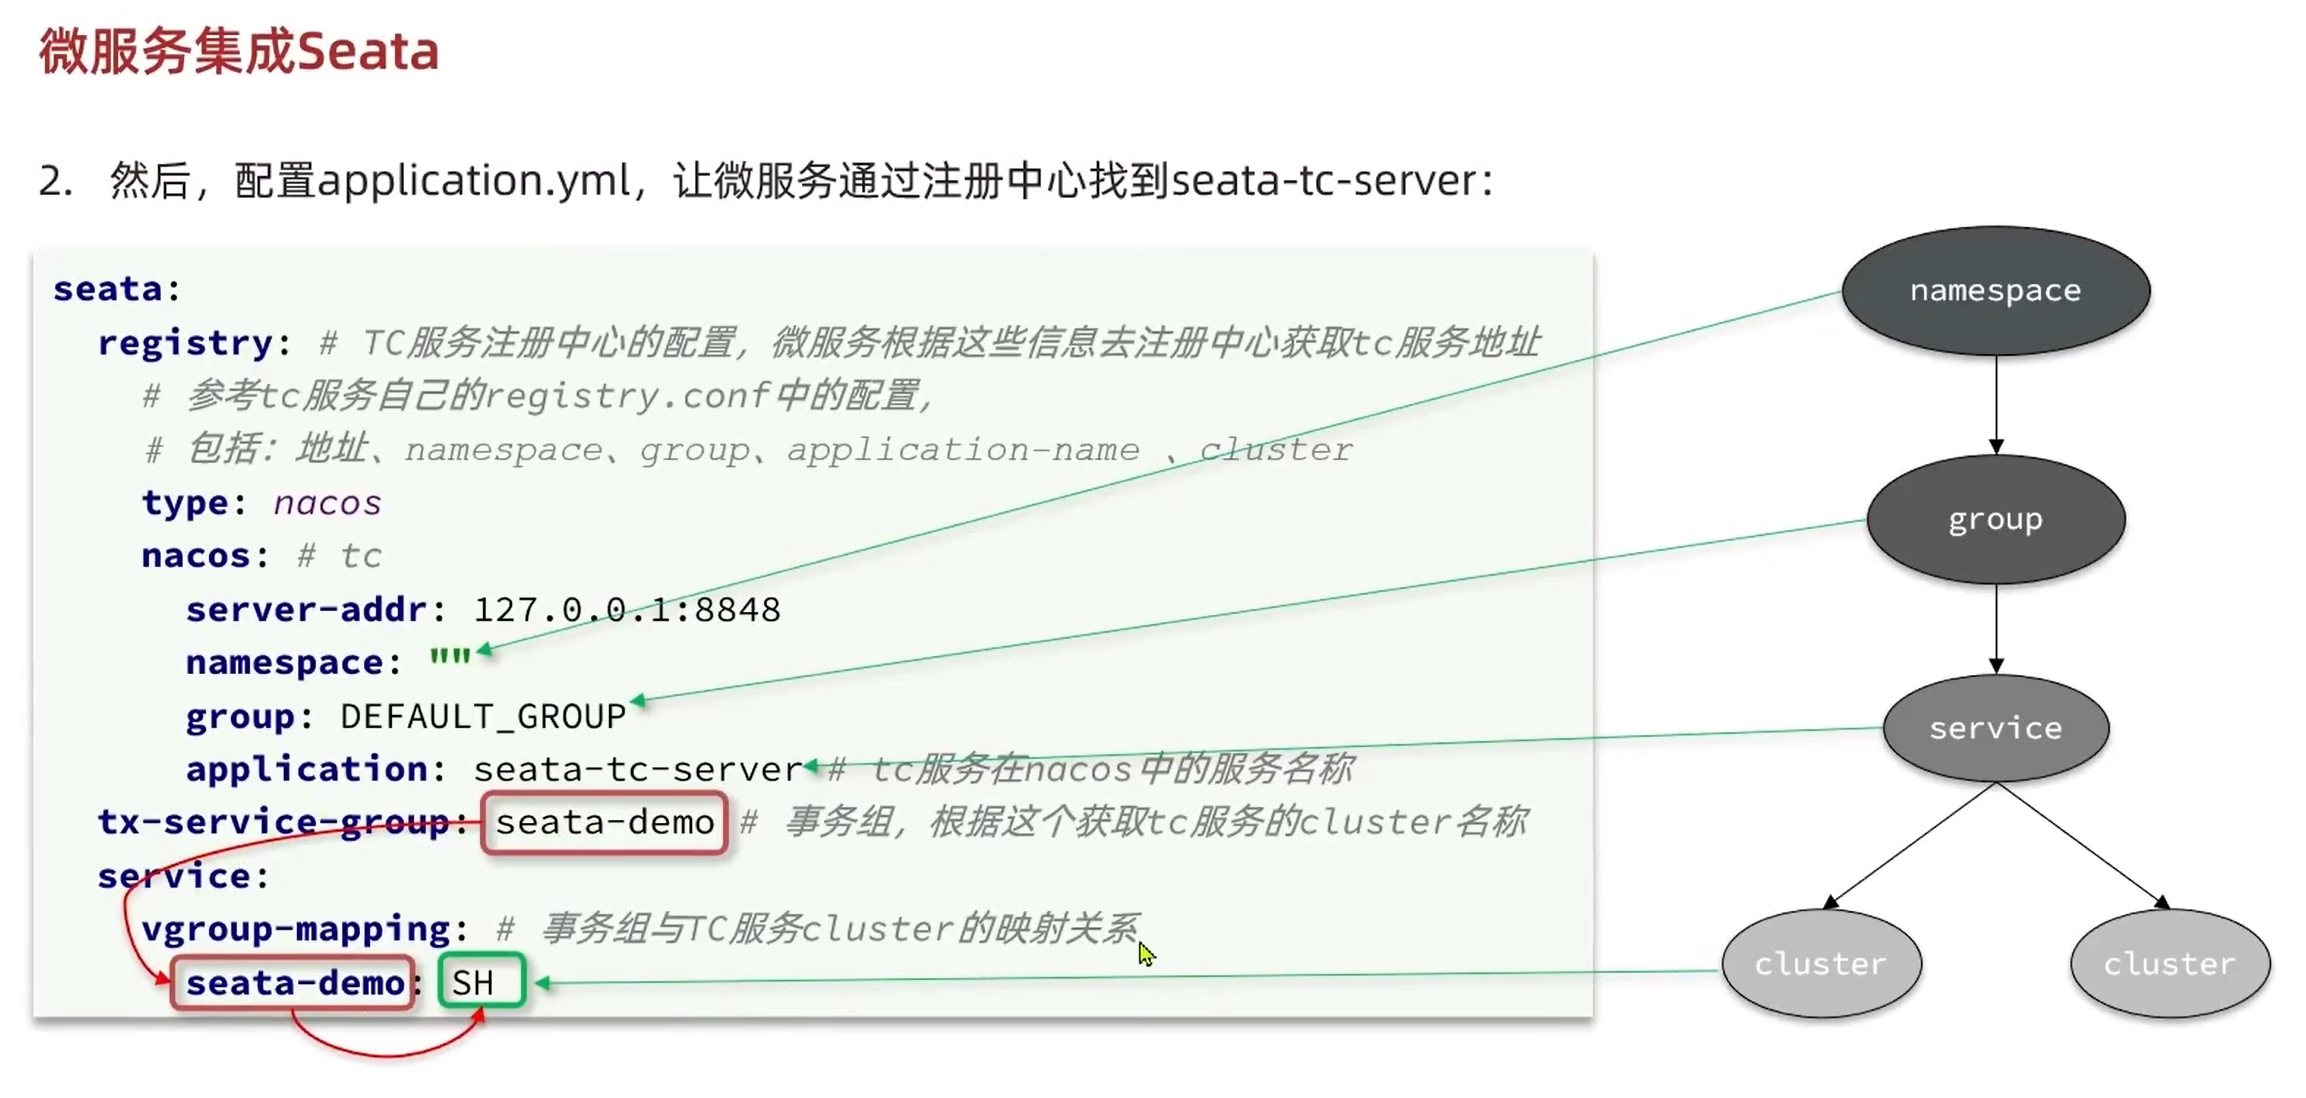
Nacos服务名称包括哪几部分?
namespace(命名空间)+group(组名称)+serviceName(服务名称)+cluster(集群名称)
Seata客户端获取TC的cluster名称的方式?
以tx-group-service的值为key到vgroupMapping中查找
什么是2PC、3PC?
- 2PC:两阶段提交
- 准备阶段:执行SQL语句但是不提交
- 提交/回滚阶段:等到所有节点都返回YES就commit,否则rollback
- 优点:保证强一致性
- 缺点:
- 同步阻塞,性能差
- 单点故障会一直等待
- 发出commit命令时可能有参与者没收到导致数据不一致
- 3PC:三阶段提交
- 询问提交阶段:询问是否可以提交
- 预提交阶段:如果参与者都回复YES,则进入预提交阶段,锁定资源
- 提交阶段:通知参与者提交,如果超时由参与者自己决定提交或回滚
- 改进点:超时参与者可以自己决定提交/回滚,避免单点故障等待问题
- 仍存在发出commit命令时可能有参与者没收到导致数据不一致的问题
Seata的XA模式是怎么样的?
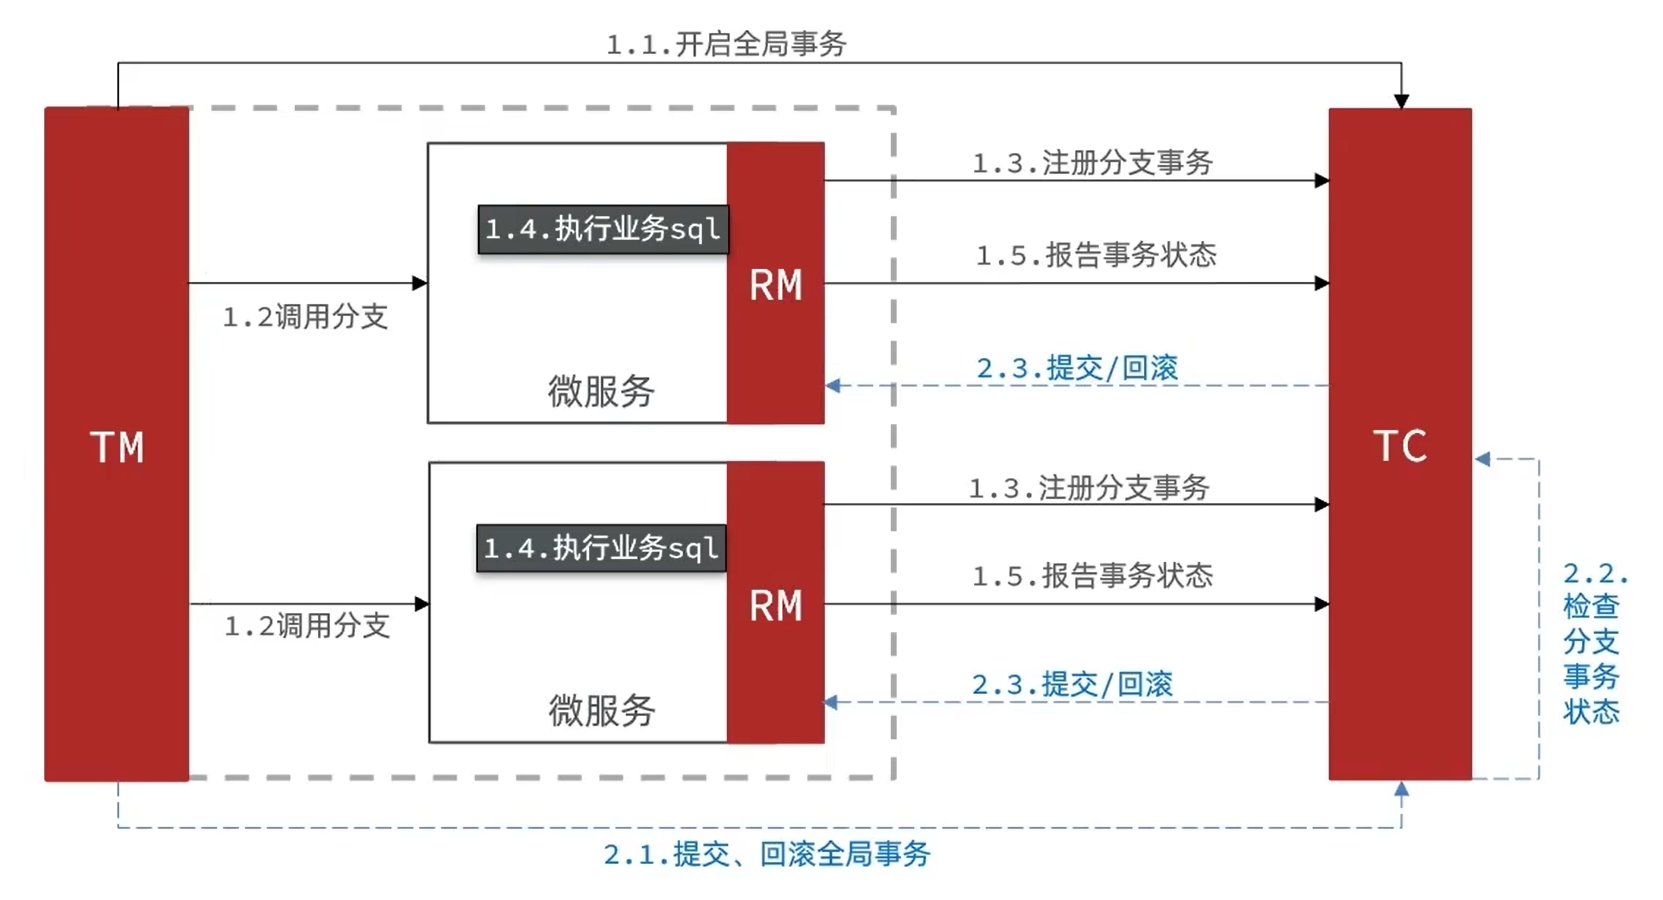
XA模式基于2PC协议,具有强一致性,但是性能差,依赖数据库支持,适用于银行金融等需要保证强一致的场景
Seata的AT模式是怎么样的?
AT模式第一阶段直接提交,并记录数据快照写入undolog,如果参与者都成功,则提交事务,异步删除undolog;如果有失败,则通过数据快照回复原始数据,性能更好,保证了最终一致性,但是存在脏写的隔离性问题,项目中常用AT模式
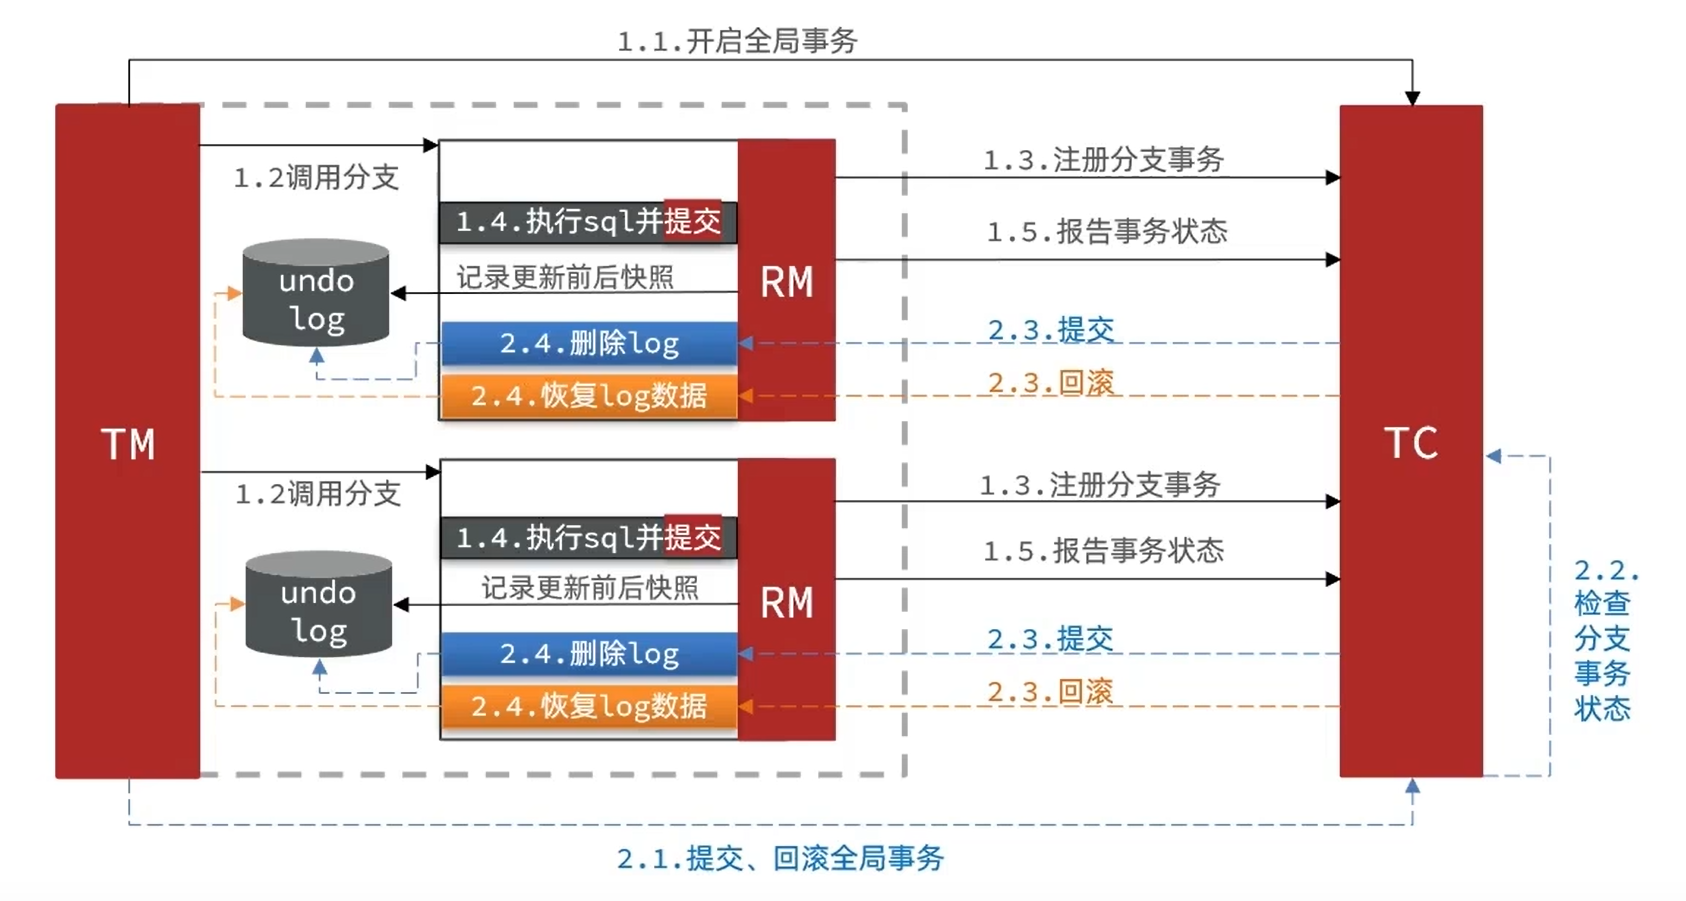
AT模式存在什么问题?如何解决的?
AT模式存在的最大问题就是脏写的问题,一阶段直接提交后数据可能被其他事务修改,而二阶段回滚后可能造成数据不一致;
Seata通过全局锁解决了脏写的问题,Seata 自己维护了一个逻辑全局锁,Seata 会向 TC 申请全局锁,如果全局锁冲突则必须等待/失败重试。
加了全局锁性能不就低了,那和XA模式有区别吗?
有区别!在锁粒度上有区别,AT性能更高。
XA模式的锁是数据库的锁,锁定了整行的数据;
而AT模式是Seata自己维护的逻辑锁,只锁定了字段,修改其他字段不影响。
如果其他事务不受Seata管理怎么办呢?
其实Seata不止记录了更新前的数据快照,也记录更新后的数据,回滚时采用一种类似CAS的方式比较数据有没有被修改,如果被修改了就发出异常,这时候就可以人工介入解决。
如果Undo Log写失败了怎么办?
Undo log 写入和业务 SQL 在同一个本地事务中执行,只要业务 SQL 成功,Undo log 一定存在且完整。
Seata的TCC模式是怎么样的?
Try(预留资源):资源的检测和预留,如锁定库存、冻结余额
Confirm(确认执行):完成资源操作业务;要求Try成功Confirm一定要能成功
Cancel(取消回滚):预留资源释放,可以理解为Try的反向操作
- 优点:
- 性能好:一阶段直接提交,相较于AT也无需生成快照和全局锁,性能最好
- 不依赖数据库事务,依赖手动编码的补偿,可用于不支持事务的数据库
- 缺点:
- 有代码侵入,需要编写三份逻辑
- 无法保证强一致,只能保证最终一致性,存在软状态
- 需要考虑Confirm和Cancel的失败情况,需要做好幂等处理
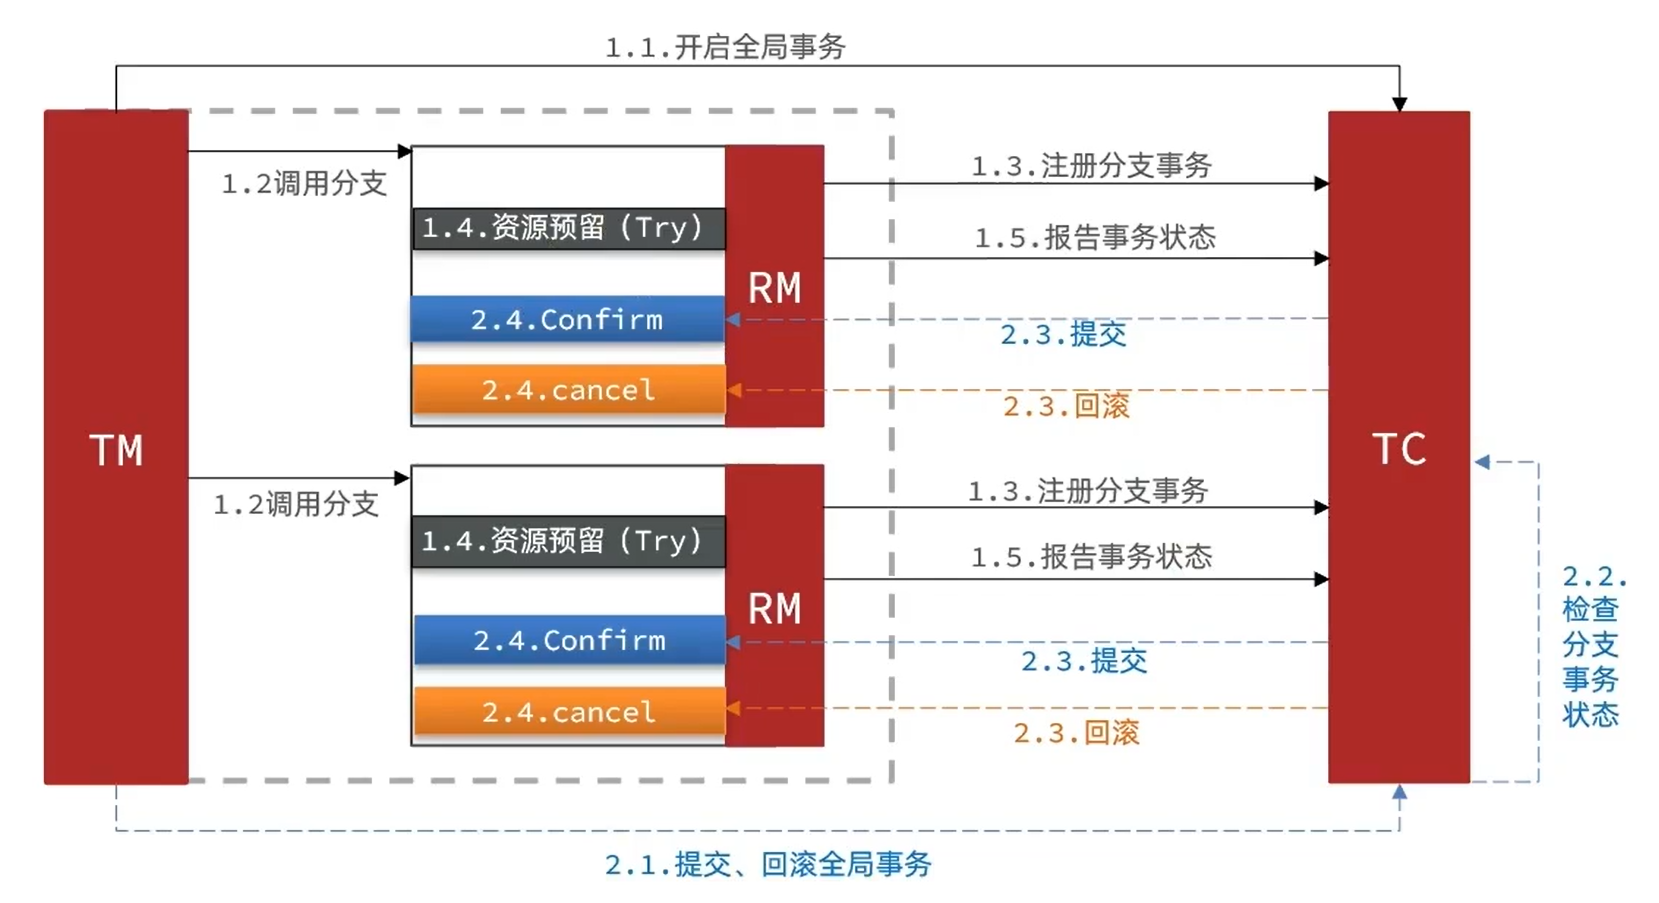
你是如何在代码中实现TCC的?
- 首先我们要接口定义三个方法代表 Try/Confirm/Cancel 三步;
- 然后加上
@LocalTCC和@TwoPhaseBusinessAction注解; @TwoPhaseBusinessAction注解传入commit / rollback两个方法名,Try 自己就是被注解的方法;- 在Service中实现这个接口;
- 然后在业务接口加上
@GlobalTransactional,就实现了TCC。
1 |
|
TCC存在什么问题?如何解决?
问题:
- 幂等性:Confirm和Cancel失败重试,保证不重复执行
- 空回滚:当某分支事务的try阶段阻塞时,可能导致全局事务超时而触发二阶段的cancel操作。在未执行try操作时先执行了cancel操作,这时cancel不能做回滚,就是空回滚。
- 业务悬挂:对于已经空回滚的业务,如果以后继续执行try,就永远不可能confirm或cancel,这就是业务悬挂。
解决方案:
- 幂等回滚状态判断:在在执行操作前需要判断状态是不是已经是当前操作过的状态了,如果已经是说明已经处理过一次了,就直接返回。
- 空回滚冻结记录判断:通常在代码中,我们会在回滚前通过xid查询判断有没有冻结记录,有才执行回滚;如果没有,说明try还没做,我们就会新增一条空回滚的冻结记录,状态为回滚,但不真正回滚。
- 悬挂冻结记录判断:判断是否已经有过冻结记录,如果为空才执行try;如果不为空,说明Cancel执行过了,直接return拒绝。
Seata的Saga模式是怎么样的?
一阶段:直接提交本地事务
二阶段:成功则什么都不做;失败则通过编写补偿业务来回滚
优点:
事务参与者可以基于事件驱动实现异步调用,吞吐高
一阶段直接提交事务,无锁,性能好
不用编写TCC中的三个阶段,实现简单
缺点:
软状态持续时间不确定,时效性差
没有锁,没有事务隔离,会有脏写