RocketMQ 八股文面试题
发送同步消息,如果出现了异常,怎么进行可靠性保障?
RocketMQ会默认进行重试(客户端内部进行的,看不见的),默认会重试2次,重试次数可以自己配置;
一般来说 如果重试都失败了,可能就是MQ服务器出现了异常/宕机了,我们还需要再重试了,当然也可以编码,但是通常我们不会这么做,此时这个mq已经不能用了,但是我们要把这个消息保存到 MySQL,XXL-J0B 定时去扫描这个表,然后重新进行发送和消费消息
如何保证顺序消息?
产生乱序的原因:
生产者把消息发送到Topic的时候,默认是存储到了4个队列中,每个队列可能会被不同的消费者或不同的线程进行消费,而我们没法控制消费者或者线程的执行顺序,所以会产生乱序
保证顺序消息的前提:
- 将一组需要保证顺序的消息放到同一个队列
- 使用单线程进行消费
你在开发中有没有使用到MQ的事务消息?使用的业务场景是什么?为什么使用事务消息?
使用过,场景是XXX
为了保证消息和本地事务的一致性
事务消息核心:
- half消息机制: 事务消息发送到MQ后会先被暂存起来(存储到一个特定的事务Topic中) 直到收到生产者发送来的COMMIT 才会把消息推送给消费者
- 回查机制: MQ如果没有收到生产者发送过来的COMMIT/ROLLBACK 会自动去调用生产者的回调方法检查本地事务执行结果
我使用同步消息加事务注解的方式可以代替事务消息吗?
不可以!因为同步消息如果发生网络错误,无法判断MQ时候收到消息,是为送到就网络故障还是MQ收到消息返回时网络故障;
如果MQ收到消息返回时网络故障,加上事务注解的方法回滚事务,MQ消费了消息,还是会导致数据不一致,所以必须依赖事务消息的半消息+事务回查机制来保证事务
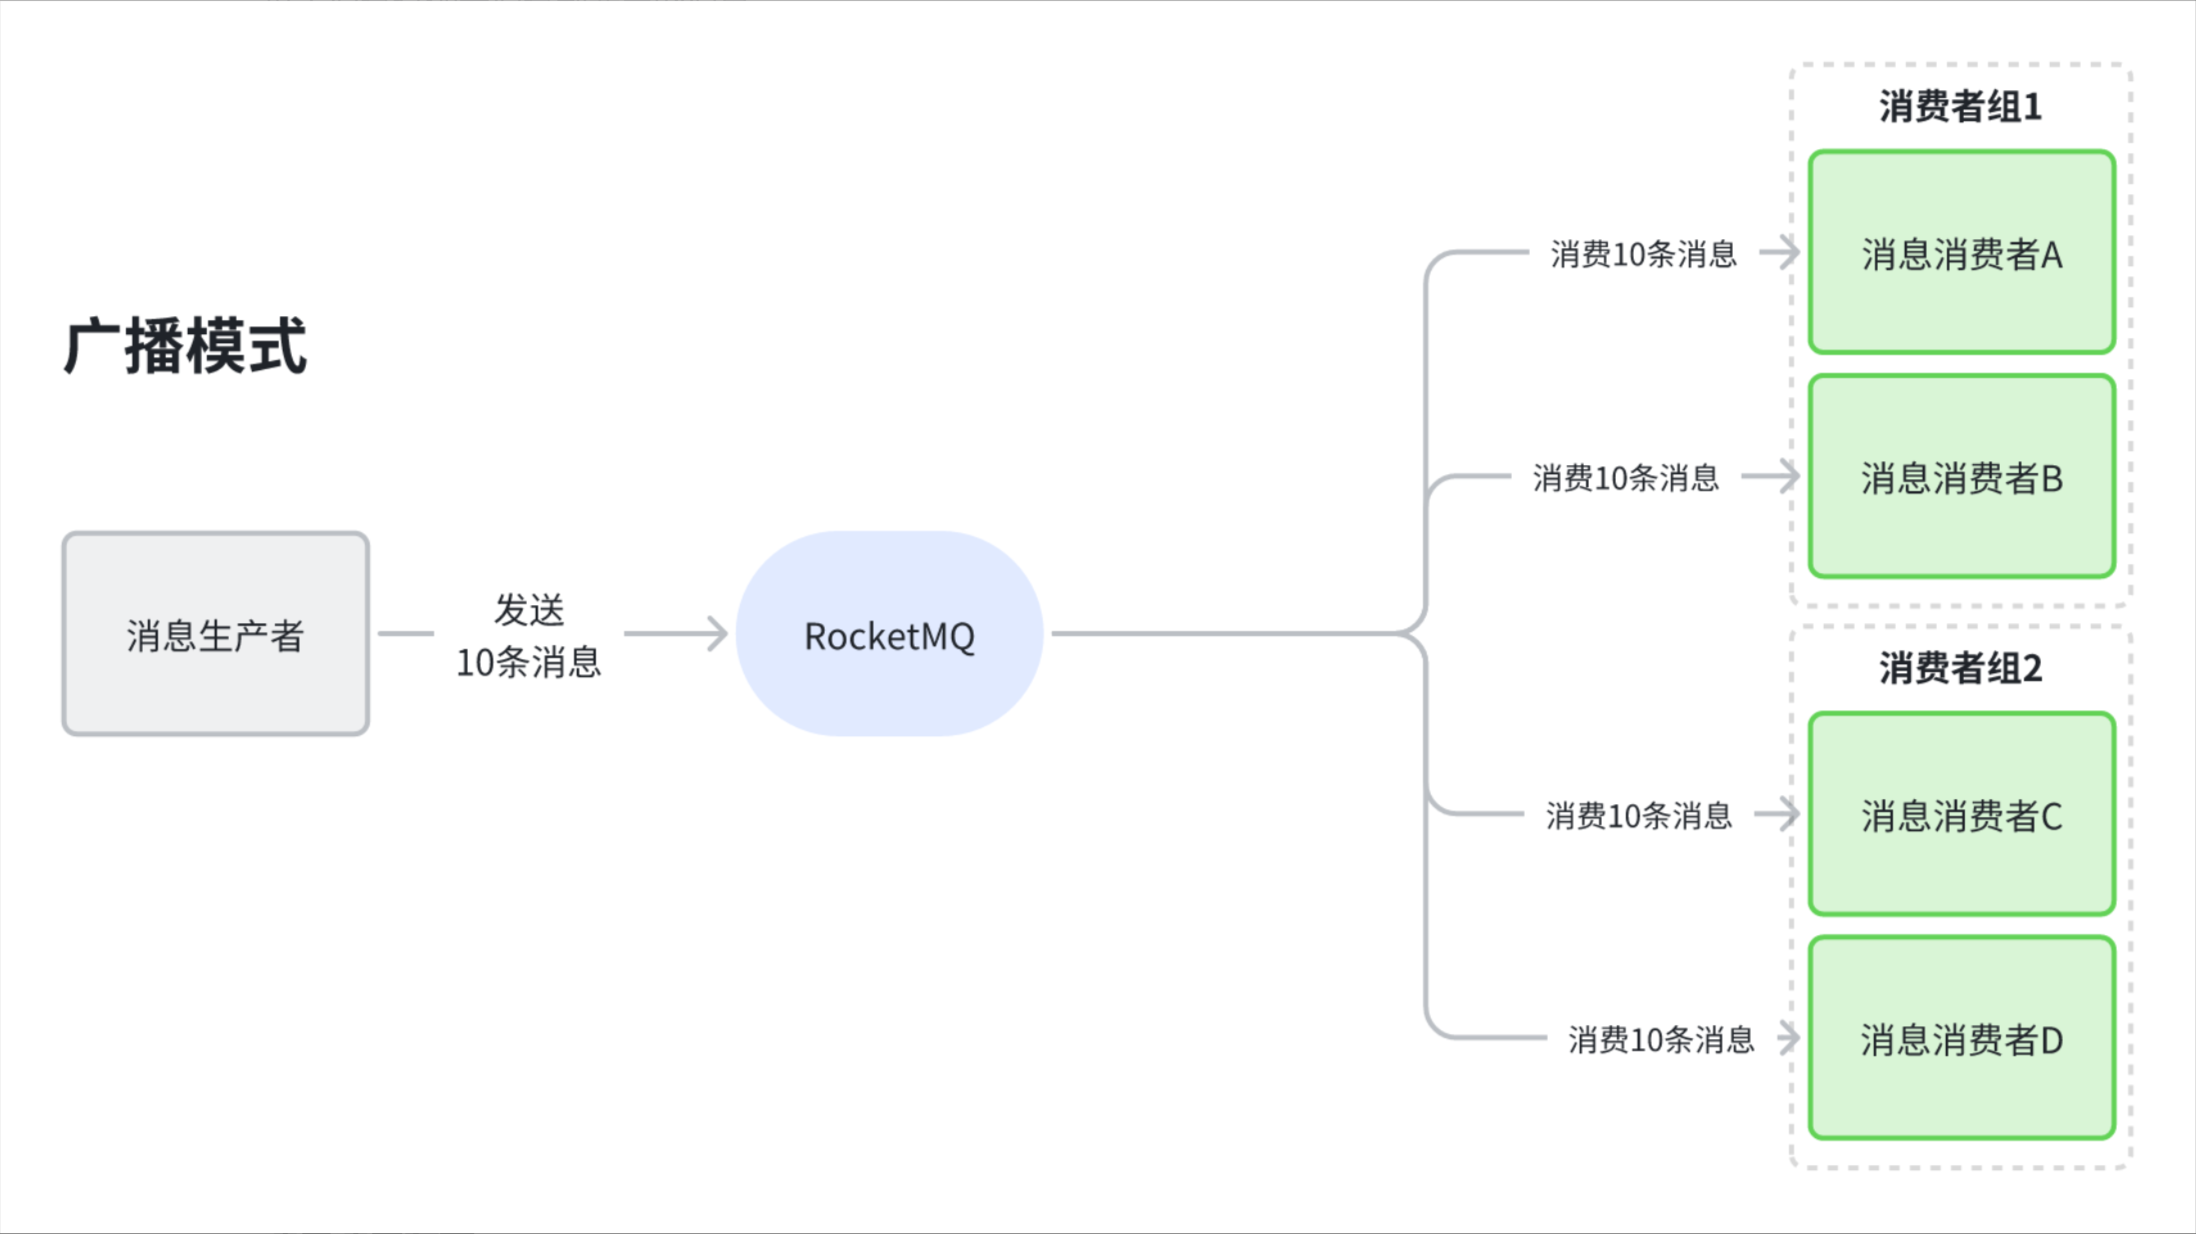
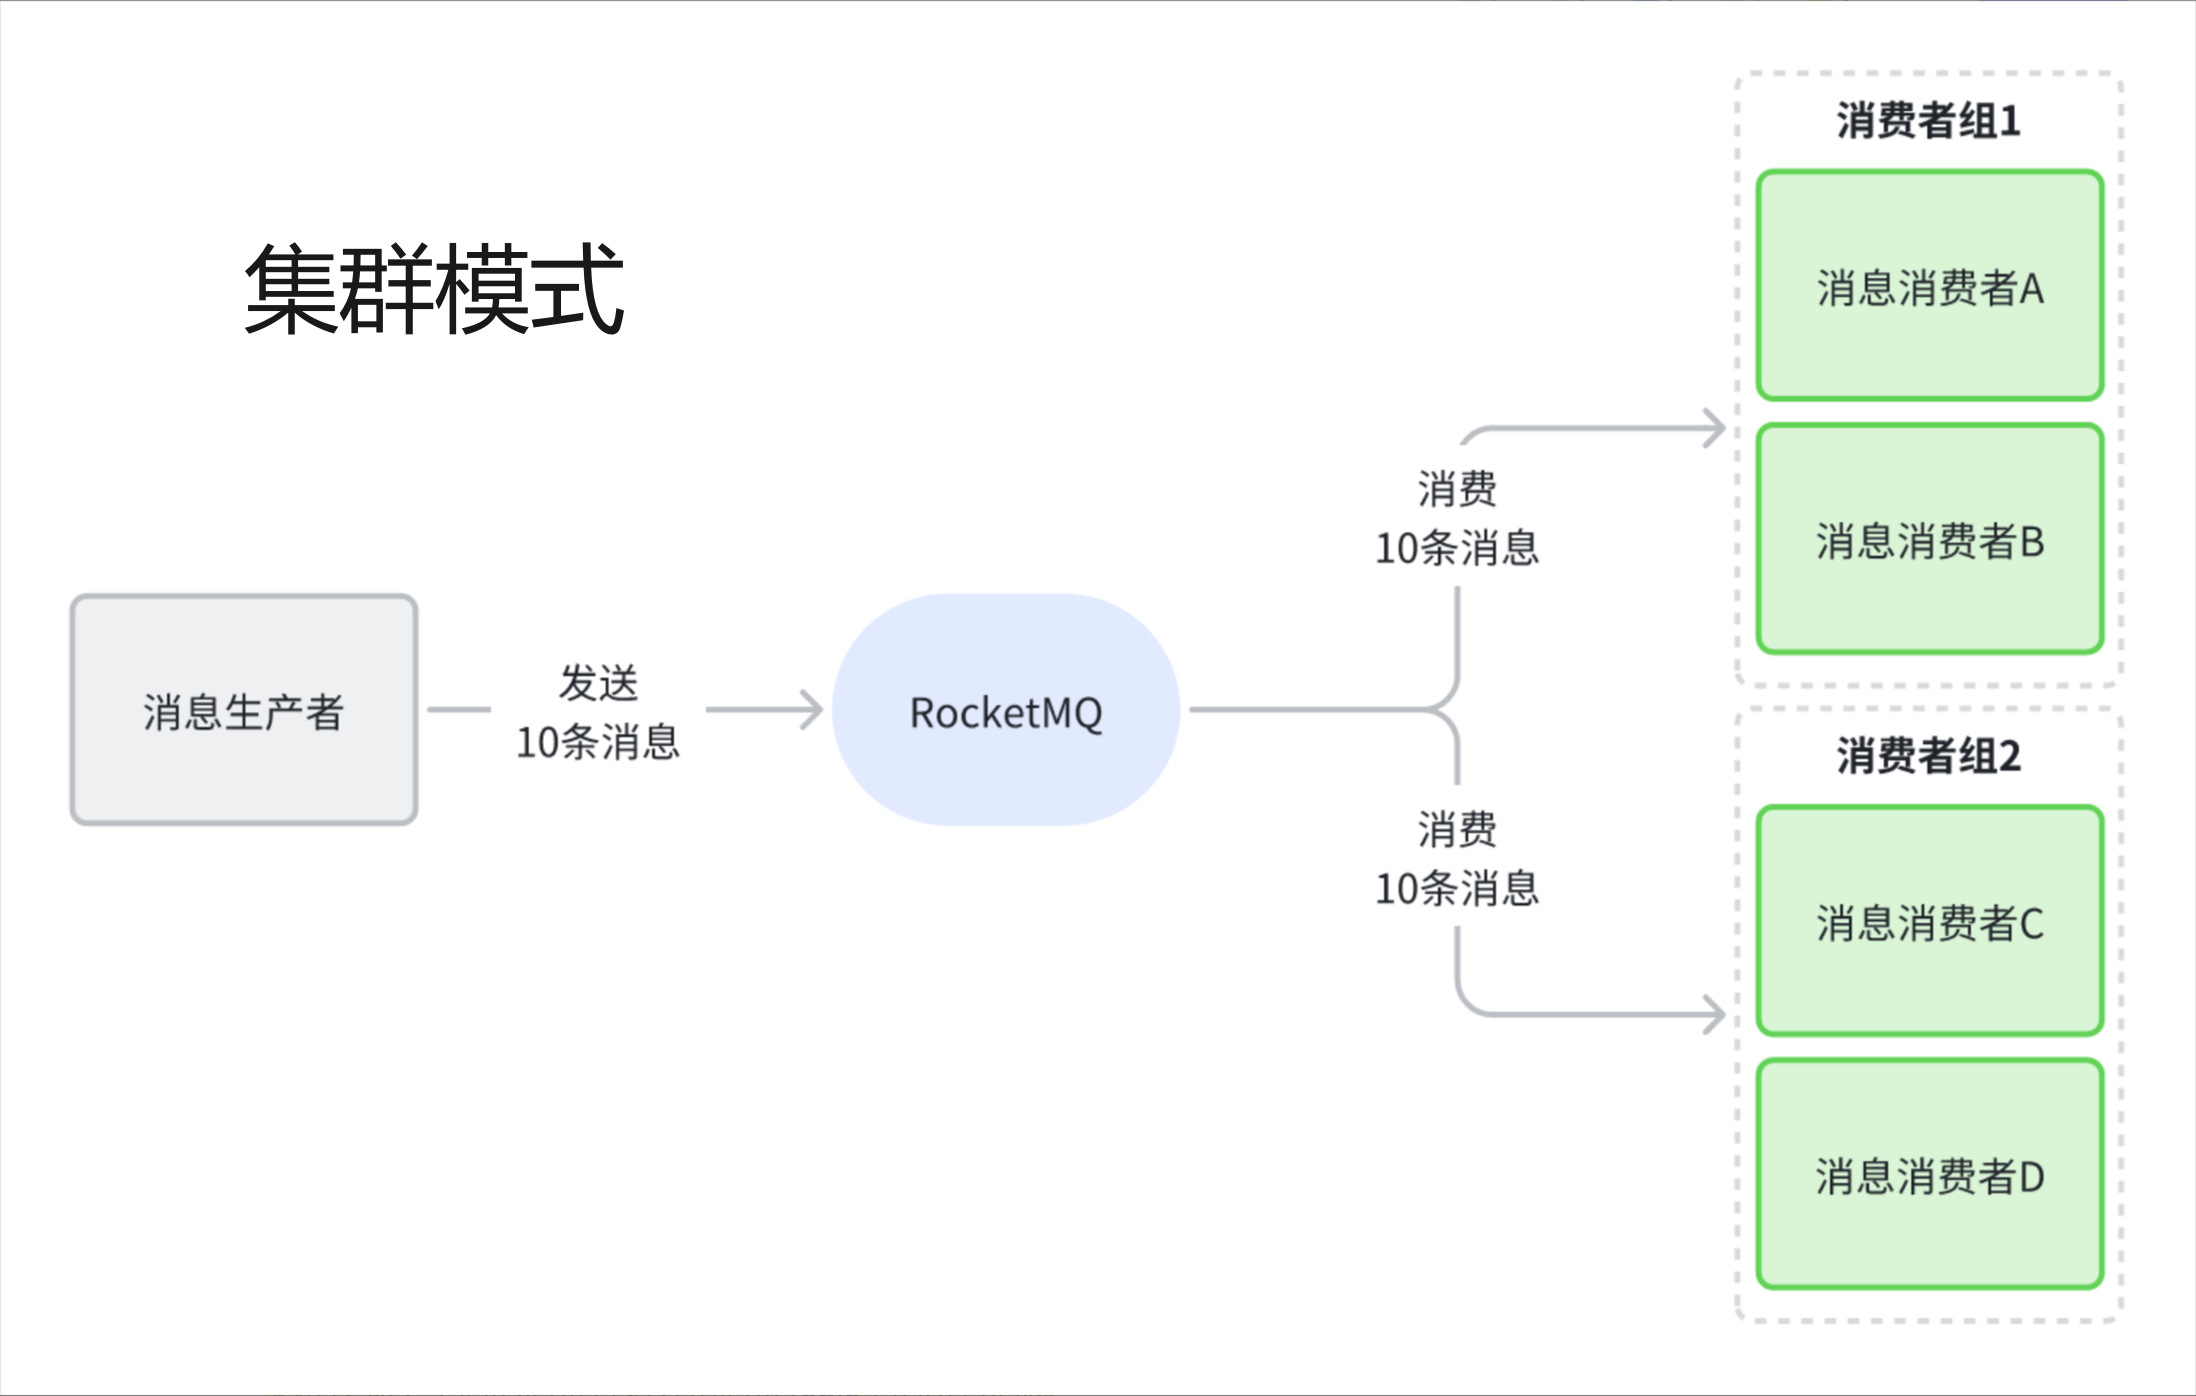
广播模式和集群模式有什么区别?
广播模式就像是个人作业,每个消费者都要做,每个消费者组里的每个消费者都要消费topic里的所有消息;
集群模式就像是小组作业,每个消费者组都要做,一个消费者组里的消费者平分topic里的消息(组内负载均衡)。
RocketMQ的架构是什么样?
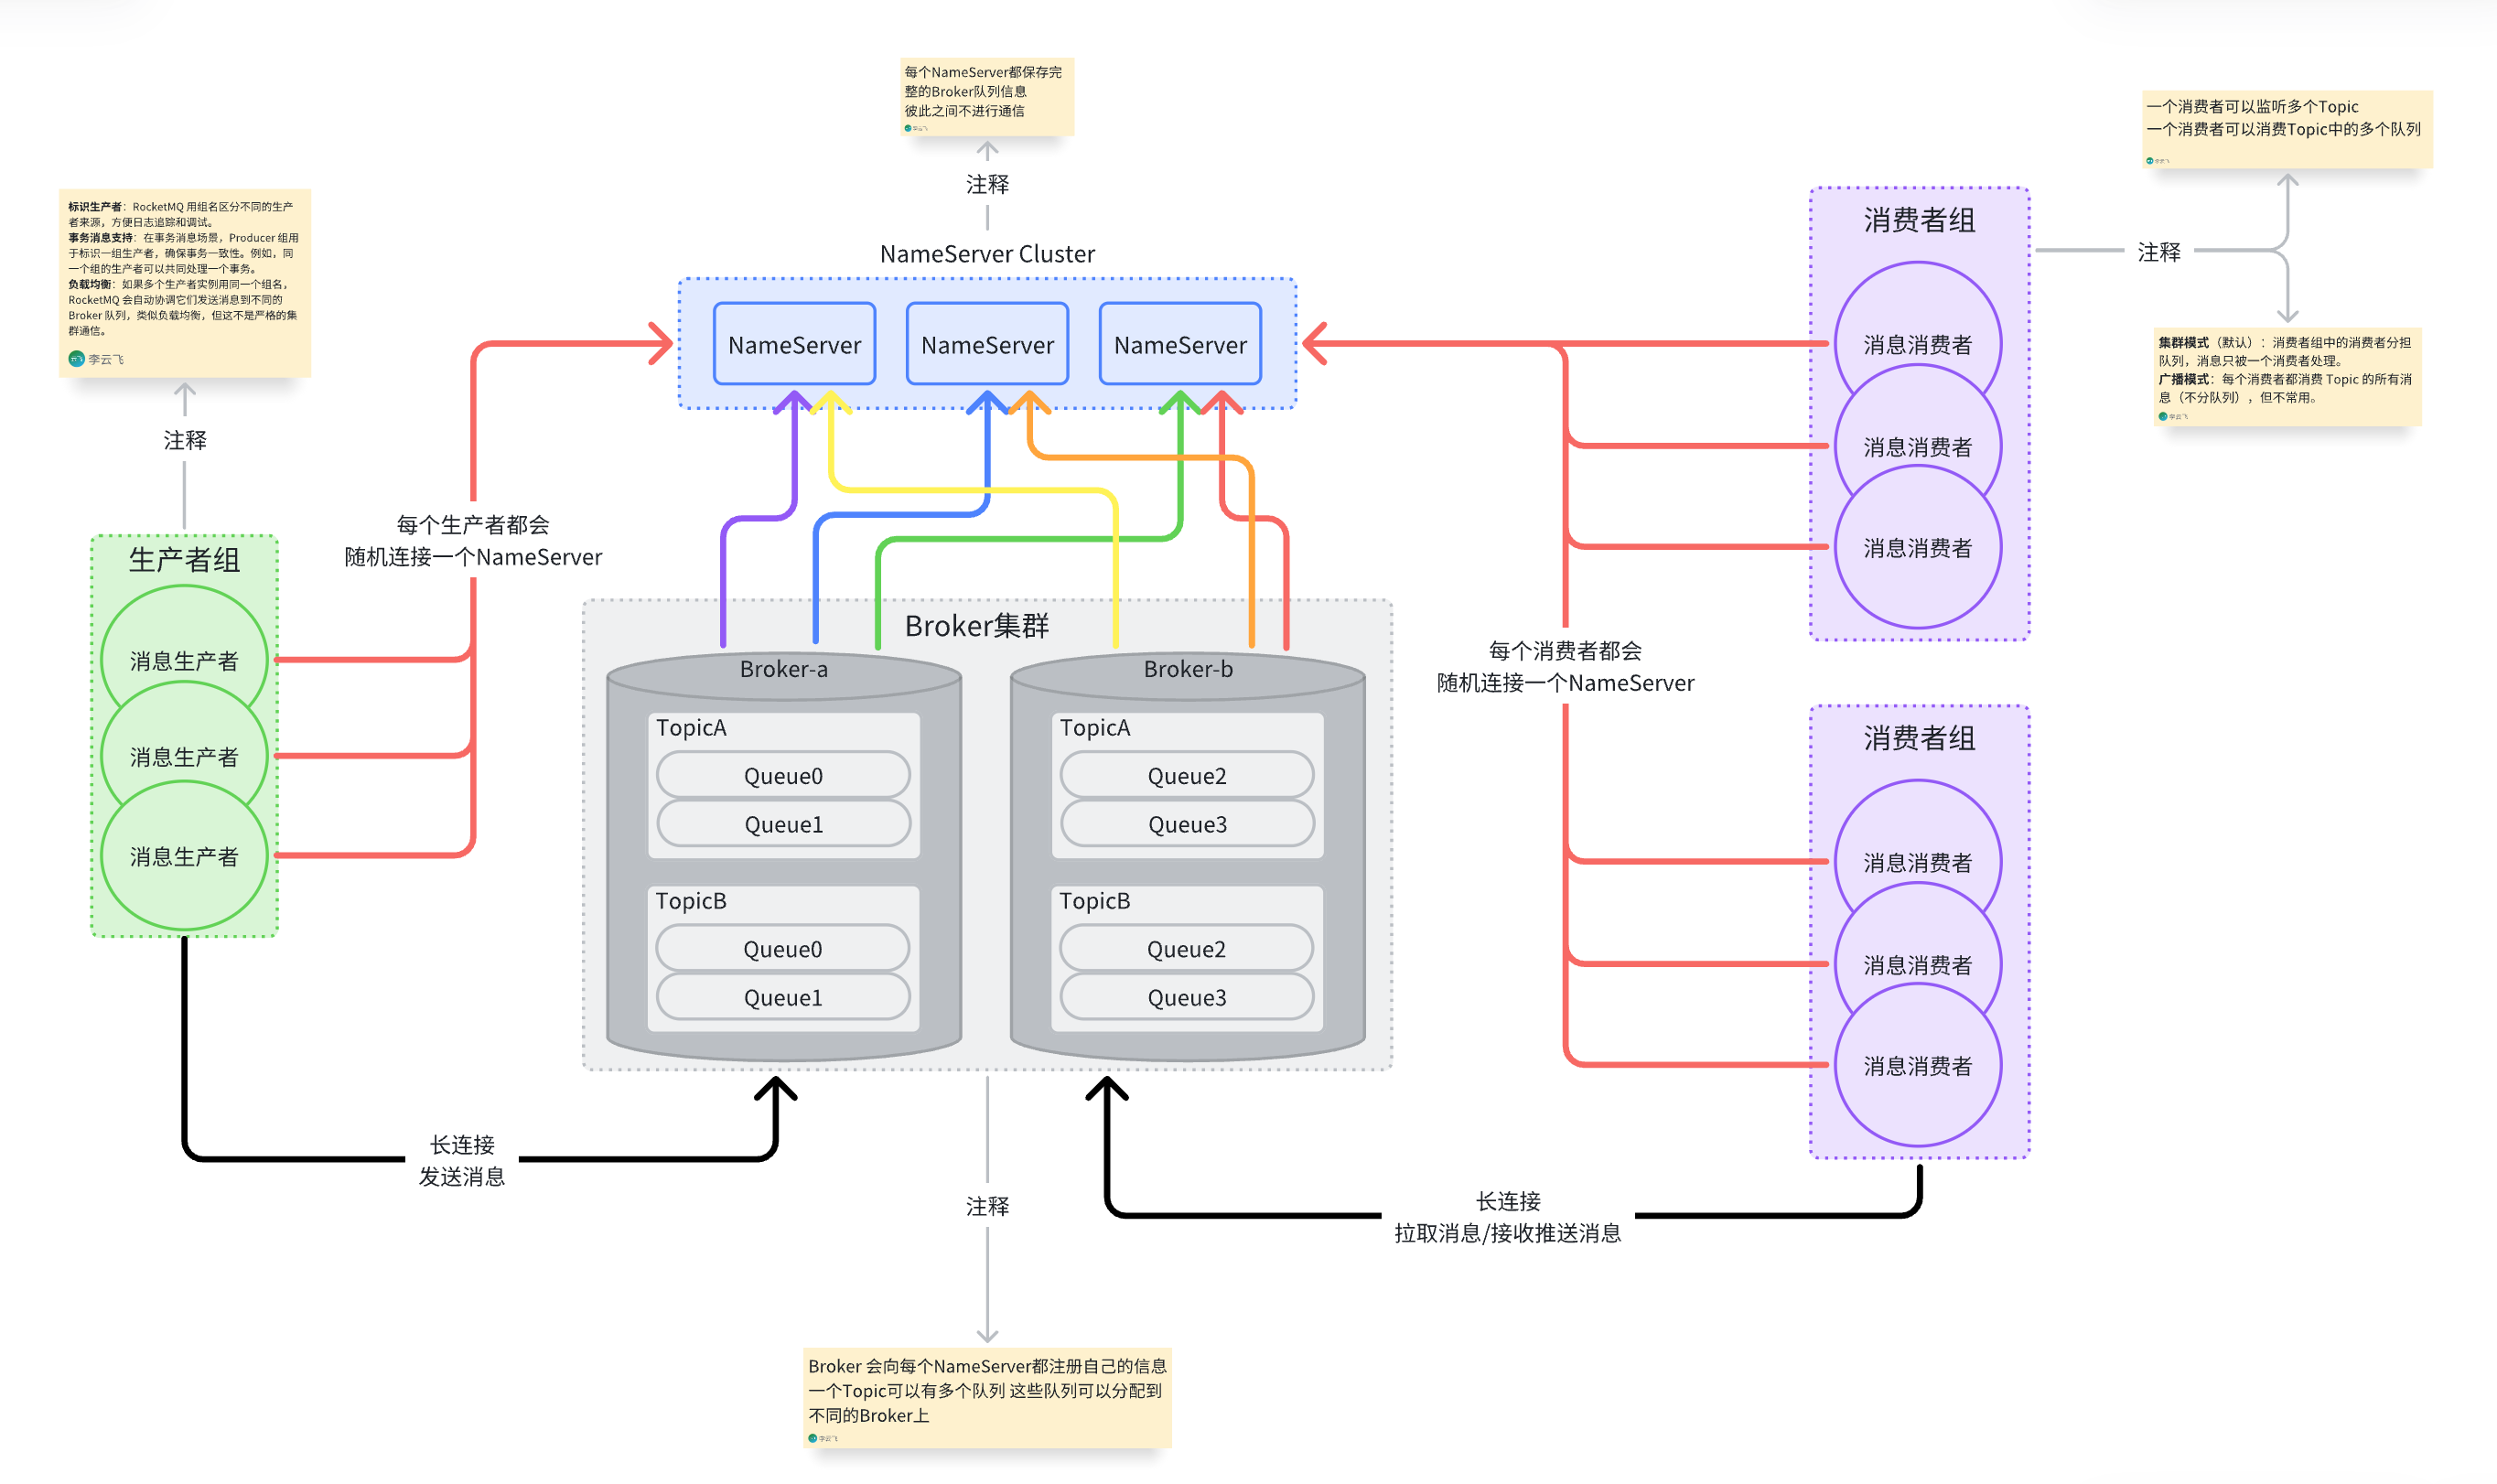
- NameServer是RocketMQ的轻量级注册中心
- Broker是消息的核心存储和转发组件
- Producer负责生成消息并发送到指定的Topic
- Consumer负责从Broker拉取并处理消息
消息是如何传递的?
- Producer发送消息到Broker的指定Topic和Queue。
- Broker存储消息(根据刷盘和复制策略),并维护消息的索引。
- Consumer从Broker拉取消息,按订阅规则处理。
- NameServer持续提供路由支持,确保Producer和Consumer能动态发现Broker。
- 如果Broker集群包含Master和Slave,消息会在主从间复制以提高可靠性;Consumer可从Master或Slave(视配置)消费消息。
NameServer 集群之间会相互通信吗?
不会,每个 NameServer 独立记录 Broker 和 Topic 的信息(比如哪个 Broker 存了哪些 Topic)。它们之间不聊天,每个 NameServer 自己维护一份完整的数据副本。
Broker 会连接到每个 NameServer 吗,还是只连接到一个 NameServer 就可以了?
Broker 会 连接到所有 NameServer
如果 Broker 崩溃了,NameServer 如何感知?
Broker 会每隔一段时间(30秒)向所有的 NameServer 发送一次心跳包,如果 NameServer 在一段时间(默认 120s)没有收到某个 Broker 的心跳,就认为该 Broker 已崩溃,会从路由表中移除它。
Broker 集群之间会相互通信吗?
不会直接相互通信,只有主从关系主节点会把消息复制到从节点
一个 Topic 可以存储在多个 Broker 上吗?存储的数据是相同的还是不同的?
一个 Topic 可以存储在多个 Broker 上。存储的数据 通常是不同的,因为 Topic 的消息被分成多个队列(Queue),分散在不同 Broker 上。
一个消费者可以同时监听多个 Topic 吗?
可以
具体实现得看消费者如何定义,如果是一台服务器为一个消费者,那么可以通过多个类监听同一个topic,通过tag来区分不同;如果一个类为一个消费者,那么只能通过传统的API方式订阅多个topic
你们RocketMQ项目用的什么集群架构?
我们项目用的是多主多从的主从架构。Master 处理读写,Slave 处理读不可写,除非Slave角色更换成了Master,复制 Master 数据做备份。
如果 Master 宕机了,Slave 会进行 Master 角色转换吗?
我记得在之前的版本,是不能自动切换的,从节点可以继续读,但是不能写了,只能手动配置更换主节点;
但是在5.0+之后好像就可以支持自动切换了
主从同步的具体过程?
从节点主动先主节点发送同步请求,请求携带offset偏移量,告诉主节点从哪里返回数据给我,也就是就是继续从上一次同步的位置继续同步;
收到主节点返回的数据后从节点会将数据存储到CommitLog中,同时更新自己的offset。
主从同步的两种方式?
- 同步复制:主节点和从节点要同时保存成功,才会给生产者返回响应;可靠性高,但性能相对较低
- 异步复制:主节点保存成功就立即给生产者返回响应,从节点可能还没有进行保存;性能高,但可能存在数据丢失风险
消息的存储过程是怎样的?
回答重点:
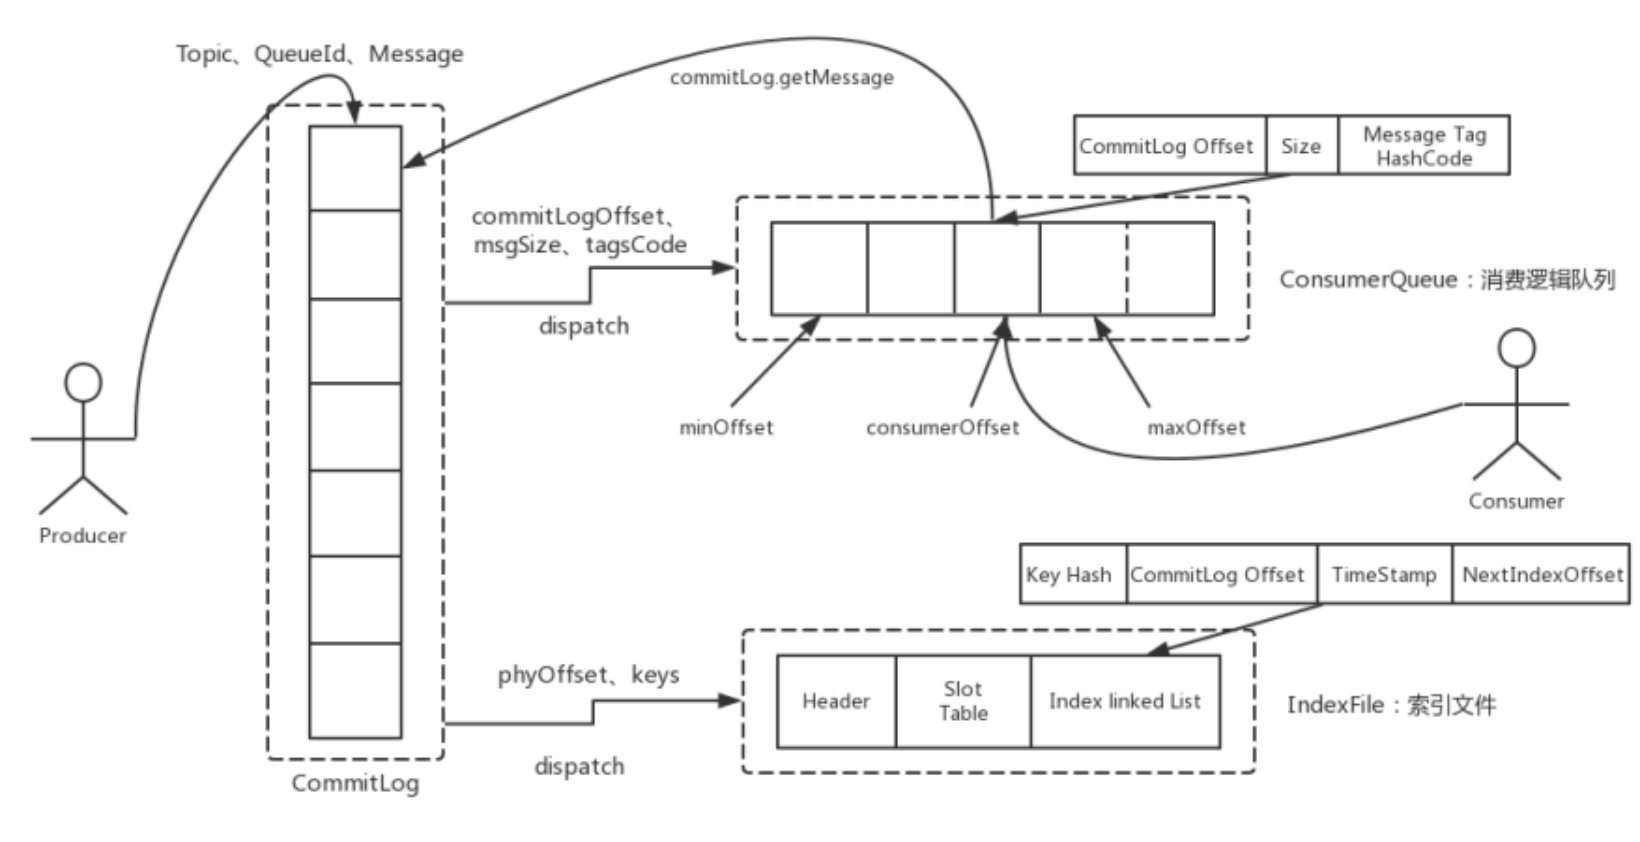
- 消息实际存储在 CommitLog 中,ConsumeQueue 中只存储了消息在 CommitLog 中的偏移量
- 消费者监听的 Topic 队列实际是监听的 ConsumeQueue(每个Topic中的每个队列都会对应一个ConsumeQueue),通过 ConsumeQueue 中的偏移量去CommitLog中找实际消息
- CommitLog 不止发给了 ConsumeQueue,还发给了 IndexFile 方便通过消息ID快速查找
Producer 发送消息到 Broker 之后,Broker 使用同步或者异步的方式将消息持久化,保存到 CommitLog 中,当消息持久化到 CommitLog 之后,消息就不会丢失,可以根据 CommitLog 来进行消息重发。
生产者发送消息给MQ,MQ会把这些消息一股脑的都存储在CommitLog中,没有区分Topic和队列,然后CommitLog存储完消息后会把这个消息的大小 、消息存储在CommitLog中的偏移量(存在CommitLog中的物理位置)、消息标签的hash值都转发给ConsumeQueue;
每个Topic中的每个队列都会对应一个ConsumeQueue,消费者在对Topic进行监听的时候,其实的对ConsumeQueue进行监听,然后从ConsumeQueue中获取要消费的消息,但是消息存储在CommitLog中,
因为ConsumeQueue中有这个消息存储在CommitLog中的位置,所以可以根据这个位置直接定位到CommitLog中把消息取出来。
同时CommitLog在存储消息之后还会向IndexFile中转发这个消息的Key和消息ID,以后我们就可以直接通过这个消息ID快速查找这个消息在CommitLog中的位置。
RocketMQ为什么这么快 / 性能为什么这么高?
首先MQ会把这个消息顺序写到commitlog中 ,然后再通过consumerqueue去索引消息可以快速从commitlog中定位到消息;
MQ还使用了mmap的这种零拷贝技术 实现了MQ内存和操作系统内存的映射 减少了数据往应用层内存拷贝的次数。
消息的刷盘机制?
- 同步刷盘
- 生产者发送消息
- Broker接收消息
- 消息写入PageCache(内存映射文件)
- 立即调用force()方法强制刷盘
- 等待数据真正写入磁盘
- 刷盘完成后返回响应给生产者
- 异步刷盘
- 生产者发送消息
- Broker接收消息
- 消息写入PageCache(内存映射文件)
- 立即返回响应给生产者(不等待刷盘)
- 后台线程异步执行刷盘
- 定时或达到阈值时批量刷盘
- 触发条件:
- 时间间隔:默认500ms执行一次
- 脏页数量:达到一定阈值
- 系统要求:操作系统内存压力时主动刷盘
- 正常关机:内存中数据会写入磁盘
- 触发条件:
同步/异步的消息、刷盘、复制之间的关系
同步消息:发送消息 等着返回 执行后续代码
异步消息:发送消息 执行后续代码 执行回调
同步刷盘:接收消息 写入磁盘 返回响应
异步刷盘:接收消息 返回响应 写入磁盘
同步复制:主服务器接收消息 同步从服务器 返回响应
异步复制:主服务器接收消息 返回响应 同步从服务器
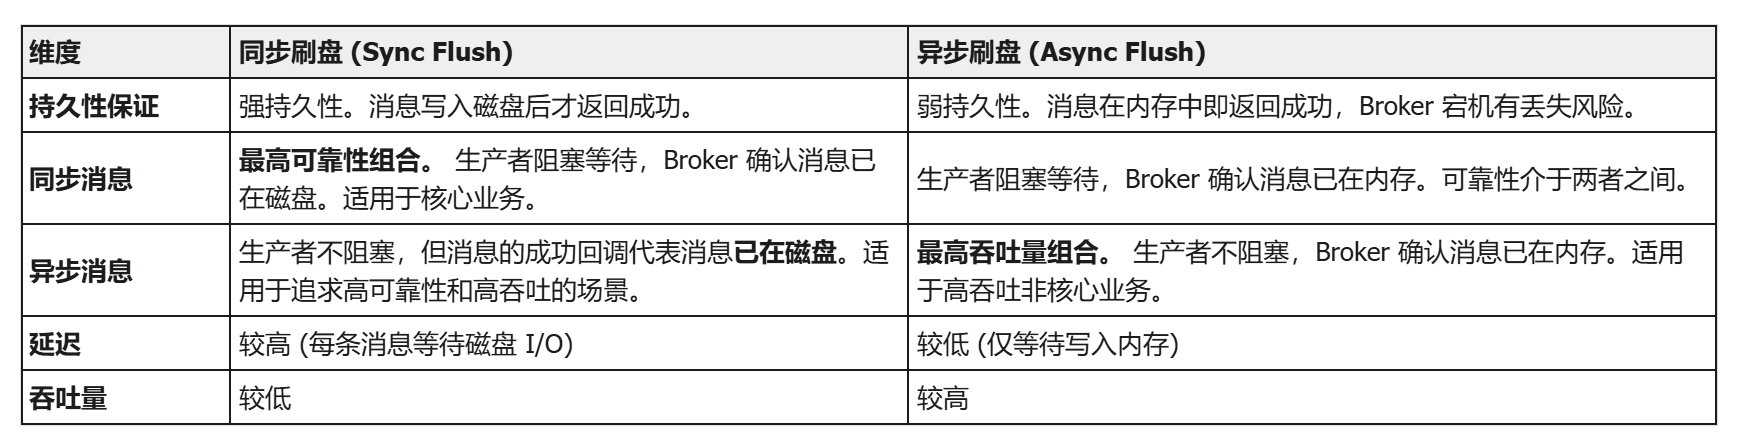
要达到最高可靠性,使用 同步消息发送 + 同步刷盘 的组合。
要达到最高吞吐量,使用 异步消息发送 + 异步刷盘 的组合。
在实际生产中,RocketMQ 默认的配置通常是:异步刷盘(Async Flush) + 主从异步复制(ASYNC_MASTER),兼顾性能和可靠性。
触发再平衡的时机?
当消费者组变化(如新消费者加入、旧消费者下线、Queue 数变化)时,立即触发再平衡
RocketMQ消息发送失败的重试策略?
==消息重试只在集群消费 (Clustering) 模式下生效!==
无序消息:采用阶梯式延时投递,最大重试16次(可配置)。消费失败的会存入一个重试Topic(有就添加,没有就创建),并将消息转为延时消息,到时间后会作为一条新的普通消息,重新自动投递到对应消费者组的重试 Topic 队列,消费者自动订阅了这条队列进行二次消费
有序消息:有序消息为了保证顺序,会阻塞后续消息,无限次不断重新投递给消费者
处理方式:加强监控,及时通知开发人员
无序消息:RocketMQ 采用延时投递的方式进行重试,并使用阶梯式重试间隔来避免瞬时故障对系统造成持续压力
- **消费失败:**当一条无序消息被消费者消费失败后会通知 Broker进行消息重试。
- 创建重试Topic: Broker 检查该消费者是否有重试Topic
%RETRY% + consumerGroupName如果没有则自动创建,该重试Topic的名称是固定格式且是懒加载,只有出现重试消息时才会创建,且会被消费者组自动订阅,每个消费者组对应自己的重试Topic。 - 时间调度: Broker 将重试消息转化为延迟消息,根据重试次数选择对应的延迟等级,并将重试消息存入内部的延迟 Topic(SCHEDULE_TOPIC_XXXX)的队列中。
- 定时轮询: Broker 的定时器线程扫描
SCHEDULE_TOPIC_XXXX。 - 到期投递: 当消息到期时,定时器线程将其取出,并将消息作为一条新的普通消息,投递到重试 Topic (
%RETRY% + consumerGroupName) 的某个队列中。 - 消费者拉取: 消费者因为自动订阅了
%RETRY% + consumerGroupName,从而拉取到消息进行二次消费。
- 最大重试次数: 默认是 16 次(可配置)。
有序消息:为了保证同一个Sharding Key(如订单 ID)下的消息消费顺序,严格按照发送顺序进行
- 阻塞重试: 有序消息在消费失败后,Broker 不会进行延时投递。它会无限次地、立即、不断地将失败消息重新投递给当前的消费者,每次重试间隔通常为 1 秒(具体取决于版本和配置)。
- 消费阻塞: 由于顺序性的要求,只要该消息没有消费成功,该队列 (Queue) 后续的所有消息都会被阻塞,无法被投递给任何消费者。
处理建议:对顺序消息的消费情况设置严格告警。在消费者代码中对异常进行严格包裹处理,如果出现消息消费失败的情况,要及时记录消息或者通知开发人员。
什么是死信队列?
死信机制是消息重试的最终兜底方案。当一条无序消息在达到最大重试次数(默认16次)后仍然消费失败,RocketMQ 会将其转移到死信队列 (Dead Letter Queue, DLQ)。一个死信队列对应一个消费组,该消费组内所有 Topic 产生的死信消息都会被收集到这一个 DLQ 中。一旦消息进入 DLQ,它将永远不会被原来的消费者组(GroupID)正常消费到。死信消息默认有保留时间,超时后会被系统自动清理。
如何处理死信队列?
用户可以创建独立的消费者组订阅死信Topic,将死信消息记录到日志、发送警报给开发人员、存储到数据库,或者人工审核后重新发送到原来的Topic。
RocketMQ 如何保证消息不丢失(消息的可靠性)
生产者:如果消息发送失败,MQ会默认进行2次重试,如果还是发送失败,我们可以捕获MQ返回的异常然后把消息进行其他位置的存储(Redis/MySQL),最后再人为干预处理这些发送失败的消息。
Broker:消息到达MQ后会先存储中内存中,我们可以配置同步刷盘将消息立即存储到硬盘,同时也可以配置主从到同步复制,让消息中从服务器中也存储一份。
消费者:如果消费者消费失败消息会自动进行重试,如果达到重试次数会进入到死信,我们可以去写个消费者监听这个死信队列,然后处理死信消息。
RocketMQ 如何保证消息的顺序性
首先我们要保证顺序必须知道为什么会产生乱序:多个顺序消息在进行发送的时候,默认是会轮询存储到不同的队列中,每个队列可能是有不同的消费者实例或者是不同的线程进行消费的,我们不能保证多个实例或者多个线程的消费顺序。
那我们保证顺序的就是:把消息放到一个队列中,并用单线程消费
RocketMQ 消息堆积了怎么解决
发生消息堆积首先想到的就是增加消费者暂时解决或缓解问题,再排查是否有消息有耗时操作(如IO/大量计算/大量数据排序等),再评估消费者个数。
RocketMQ 如何保证高可用性
NameServer:部署多个NameServer集群,多节点独立运行,互不依赖。
Broker集群:采用多 Master 多 Slave的主从架构,配置主从复制,实现自动故障转移。
RocketMQ 如何保证幂等性 / 确保消息不会被重复消费
有些操作天然就是幂等性的,比如MySQL中的删除操作,执行多次同一个SQL语句,对数据库影响是一致的;如果消费逻辑中就都是幂等性的操作,其实可以不用去做非幂等性的措施。
对于非幂等性的操作来说,我们要进行处理,防止一个消息被重复消费多次,记录每次消费过的消息ID,存储到Redis/MySQL中,再每次消费前先查询是否已经被消费过;
如果消费操作是操作数据库的,我们可以根据业务自动判断查询数据库中是否已经操作过这个数据了,如果是更新的,可以使用乐观锁
RocketMQ 消息存储过程是什么
消息生产者发送消息给MQ的Broker,Broker会先把消息存储到内存(Page Cache),如果配置的是同步刷盘,消息会立即存储到磁盘,如果配置的是异步刷盘,消息不会立即存储磁盘
消息中存储到磁盘的时候,先直接存储到Commit Log中,同时Commit Log还会向ConsumerQueue和Index File做两次转发,ConsumerQueue会记录消息在CommitLog中存储的位置信息,Index File会记录消息的Key和消息的ID,同时还会记录消息在CommitLog中存储的位置信息。
RocketMQ 的架构是怎么样的
Name Server:记录Broker中的Topic的信息,多个Name Server之间不会进行通信,依靠Broker进行数据同步
Broker: 存储消息的,启动会向Name Server进行注册,同时还会向Name Server发送心跳
Producer: 发送消息的,会先从Name Server根据Topic获取Broker的信息,然后发送消息给Broker
Consumer:接收消息的,会先从Name Server根据Topic获取Broker的信息,然后从Broker接收消息
RocketMQ延时消息不同版本的实现方式?
在4.x版本是通过延时级别实现的,消息会先放进一个系统延迟队列里,Broker 后台线程定时扫描,到期后再投递到真实主题,精度是秒级,默认18个级别,从1s-2h(1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h)
在5.x版本改为采用时间轮机制实现,可以设置任意毫秒级的投递时间,延时精度更高、性能更好,也没有固定档位限制