集合 八股文面试题
在Java中,集合体系结构是怎么样的?主要分为那些类?分别有什么特点?
- 单列集合(Collection)
- List:有序、可重复的集合(如 ArrayList、LinkedList)。
- Set:无序、不可重复的集合(如 HashSet、TreeSet)。
- 双列集合(Map)
- 代表一组键值对(Key-Value)的映射关系,键不可重复。(如
HashMap、TreeMap、LinkedHashMap)
- 代表一组键值对(Key-Value)的映射关系,键不可重复。(如
主要类特点:
ArrayList:动态数组,随机访问快,插入删除慢。LinkedList:双向链表,插入删除快(尤其是中间位置),随机访问慢。HashSet:底层依赖HashMap,无序,查询快。TreeSet:基于红黑树,元素有序(自然排序或自定义排序)。HashMap:数组 + 链表 / 红黑树,无序,查询、插入效率高。TreeMap:基于红黑树,key 有序,支持范围查询。
List和Set分别有什么特点?
- List:
- 有序(元素插入顺序与遍历顺序一致)。
- 可重复(允许元素值相同)。
- 支持通过索引访问(
get(int index))。 - 允许存储多个
null元素。
- Set:
- 无序(
HashSet)或有序(TreeSet按 key 排序,LinkedHashSet按插入顺序)。 - 不可重复(元素需重写
equals()和hashCode()保证唯一性)。 - 无索引,不支持随机访问。
- 最多允许一个
null元素(HashSet)。
- 无序(
ArrayList 和 LinkedList有什么区别?
| 维度 | ArrayList | LinkedList |
|---|---|---|
| 底层结构 | 动态数组(连续内存) | 双向链表(非连续内存) |
| 随机访问 | 快(O(1),直接通过索引) |
慢(O(n),需遍历链表) |
| 尾部插入 / 删除 | 快(O(1)) | 快(O(1),仅需调整指针) |
| 中间插入 / 删除 | 慢(O(n),需移动元素) |
快(O(1)) |
ArrayList的扩容机制?
- 初始容量:默认 10(无参构造),也可通过构造函数指定初始容量。
- 扩容触发:当添加元素后,
size超过当前容量时触发。 - 扩容逻辑:
- 计算新容量:默认是原容量的 1.5 倍(
oldCapacity + (oldCapacity >> 1))。 - 若新容量仍不足(如添加大量元素),直接扩容至所需容量。
- 通过
Arrays.copyOf()复制原数组元素到新数组,替换原数组引用。
- 计算新容量:默认是原容量的 1.5 倍(
说下 HashMap的put流程及扩容机制?
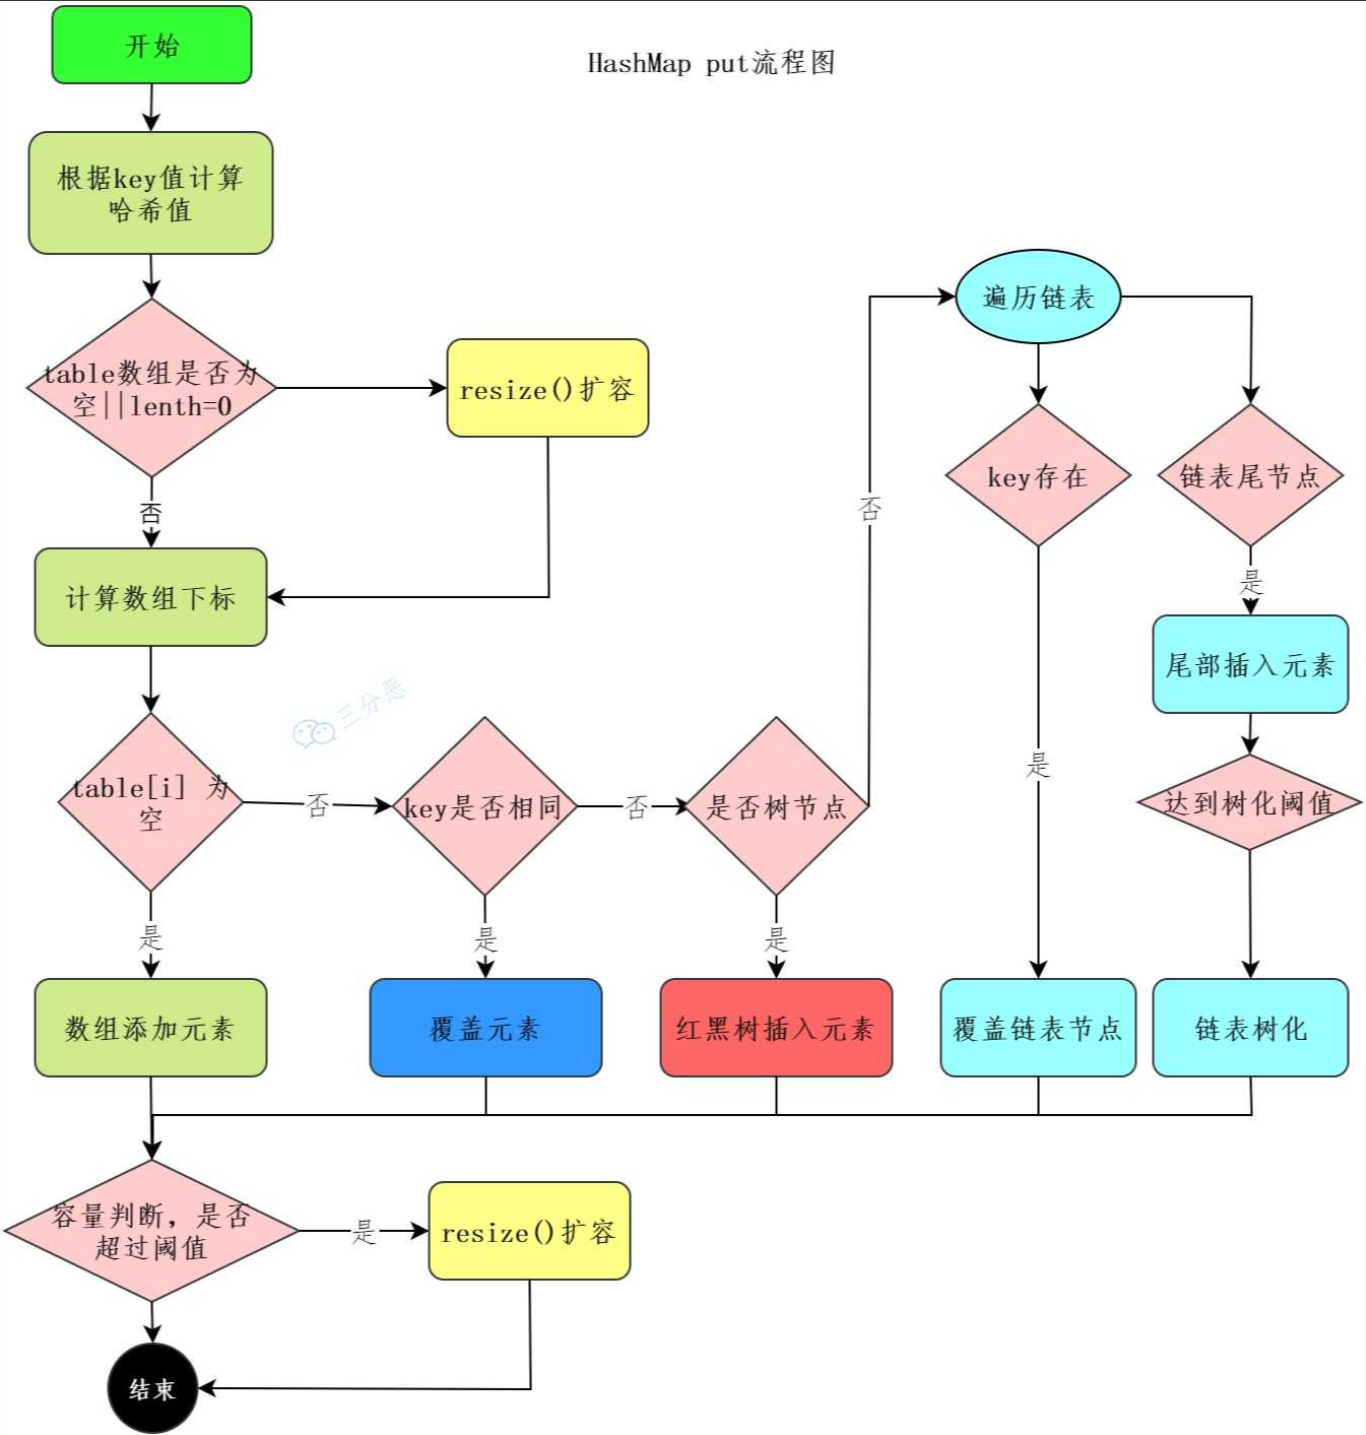
- 扩容机制:
- 新容量为原容量的 2 倍(保证容量为 2 的幂)。
- 重新计算每个节点的新下标(JDK1.8 中通过
hash & oldCapacity判断,0 则下标不变,1 则下标 = 原下标 + oldCapacity)。 - 将原数组元素迁移至新数组(链表拆分或红黑树拆分)。
HashMap的扩容如何触发?
- 当
put元素后,size(键值对数量)超过阈值(capacity * loadFactor,默认负载因子 0.75)时触发。 - 特殊情况:若链表长度超过 8 且数组容量 < 64,会先扩容而非转为红黑树。
HashMap 在 JDK 1.7 和 JDK 1.8 中有什么区别?
| 维度 | JDK 1.7 | JDK 1.8 |
|---|---|---|
| 底层结构 | 数组 + 链表 | 数组 + 链表 + 红黑树 |
| 链表插入方式 | 头插法(可能导致循环链表) | 尾插法(避免循环) |
| 扩容时元素迁移 | 重新计算 hash | 利用高低位判断新下标 |
| hash 计算 | 多次扰动(4 次移位 + 异或) | 1 次扰动(高 16 位异或低 16 位) |
| 阈值判断(转树) | 无(仅链表) | 链表长度 > 8 且容量≥64 转红黑树 |
| 安全性 | 线程不安全,扩容可能死循环 | 线程不安全,但避免死循环 |
CopyOnWriteArrayList有什么特点?
CopyOnWriteArrayList 采用的是写时复制的技术,适用于读多写少的场景,读操作不需要加锁,当时读取到的数据可能不是最新的数据。
ConcurrentHashMap在JDK1.8中是如何保证put流程和初始化流程线程安全的?
- 初始化:
- 通过 CAS 操作保证线程安全。当
table为null时,多个线程竞争初始化,CAS 成功的线程执行初始化(设置容量),失败的线程自旋等待。
- 通过 CAS 操作保证线程安全。当
- put 流程:
- 计算 hash 和下标,若数组未初始化则触发初始化。
- 若下标位置为空,通过 CAS 插入节点(无锁)。
- 若下标位置为
MOVED(正在扩容),帮助扩容(多线程协同扩容)。 - 否则,对该位置的头节点加
synchronized锁,执行插入(链表或红黑树)。 - 插入后更新元素数量(通过
baseCount或CounterCell,CAS 更新避免锁竞争)。
ConcurrentHashMap在JDK1.8中和JDK1.7中分别是怎么保证线程安全的?哪个效率好?
- JDK 1.7:
- 采用分段锁(Segment):每个 Segment 是独立的 HashMap,自带
ReentrantLock。 - 不同 Segment 的操作互不干扰,锁粒度为 Segment。
- 采用分段锁(Segment):每个 Segment 是独立的 HashMap,自带
- JDK 1.8:
- 取消分段锁,采用CAS + synchronized:对数组槽位的头节点加锁(锁粒度为单个节点)。
- 无竞争时用 CAS,有竞争时才加锁,效率更高。
- 效率对比:JDK 1.8 效率更高。原因是锁粒度更细(节点级),减少锁竞争,且 CAS 操作在低并发时无需阻塞,性能更优。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 Bob's Blog!
相关推荐
2025-09-18
JVM 八股文面试题
Java如何实现跨平台? 不直接跑在操作系统上,而是跑在 JVM 上。 JDK和JRE有什么区别? **JRE(Java Runtime Environment)**Java 程序的运行环境:只有JVM+核心类库(如 java.lang.*、java.util.*) **JDK(Java Devel
2025-09-28
Redis 八股文面试题
你在开发中都是怎么使用Redis的 ? 我主要使用的是 Redis的缓存和它的分布式锁功能 Redis 为什么快? 基于内存操作:内存的速度远高于访问磁盘的速度 单线程 + I/O 多路复用:避免了多线程带来的锁竞争、上下文切换的开销。 高效的底层数据结构和编码:使用内存紧凑的 ziplist (压
2025-09-25
JUC 八股文面试题
谈谈你对线程和进程的理解 进程 线程 操作系统资源分配的基本单位 CPU 调度的基本单位 一个进程可包含多个线程 创建线程有几种方式?分别适用什么场景? 继承 Thread 类,重写run()方法:在无需返回值时使用 实现 Runnable 接口,实现run()方法:在需要返回值时使用 实现 Cal
2025-10-27
Seata分布式事务 八股文面试题
什么是CAP定理? Consistency 一致性:所有节点在同一时间看到的数据必须一致。 Availability 可用性:每个请求都能得到响应,不会出现长时间阻塞或错误。 Partition tolerance 分区容错性:当网络通信出现故障时(如网络丢包、节点之间无法连通),系统仍能继续运作。
2025-11-09
MySQL 的优化
如何调优? SQL调优是一个很大的概念,但是大致就是从索引优化、代码/业务优化、架构优化几个方向上来做: 比如最常说的索引优化: 我们可以使用覆盖索引避免回表; 然后就是尽量满足最左匹配原则,避免索引失效; 还有就是索引也不宜过多,这样写入的时候维护索引的成本就高了,也占磁盘空间,mysql选择索引
2025-11-08
Spring 的事务
事务的特性和属性 特性:原子性、一致性、隔离性、持久性 属性:隔离性、传播性、回滚规则、是否只读、超时时间 事务传播行为有哪几种? 协同派: REQUIRED:有就加入,没有就新建(默认) SUPPORTS:有就加入,没有就算了 NESTED:有就新建子事务(子事务失败父事务不受影响,父事务失败会带